
Redis 的 listpack 和 ziplist 有什么区别?为什么 listpack 能避免连锁更新?
下面是一段教学用的模拟面试。
🧑💻 面试官: listpack 和 ziplist 都很紧凑,为什么还要换一种格式?
🙋♂️ 我: listpack 更省内存,也能避免连锁更新。
🧑💻 面试官: 连锁从哪里来?前一个元素变长,为什么后一个的头也要改?
🙋♂️ 我: ziplist 的条目保存了前一项长度。
🧑💻 面试官: 那 listpack 换成自己的长度以后,插入元素就完全不用搬数据了吗?
避免的是「长度元数据一路牵连」,不是把连续内存中的移动与扩容都消掉。
面试速答(60 秒版)
ziplist 和 listpack 都是紧凑的连续内存编码,可以减少每个元素独立节点和指针带来的开销。
ziplist 的条目包含前一个条目的长度信息。前项变大后,后项保存前项长度所需的编码可能变长;后项自身长度又跟着变,进而影响下一项,形成连锁更新。
listpack 在条目末尾记录本项编码与内容的长度信息,用于反向遍历。它不依赖前一项长度,所以前项变化不会因为这类元数据依赖一路传播。
不过连续内存仍可能在插入、删除时移动数据,扩容也可能复制。紧凑表示更适合满足大小条件的小集合,不是所有规模的通用替代。
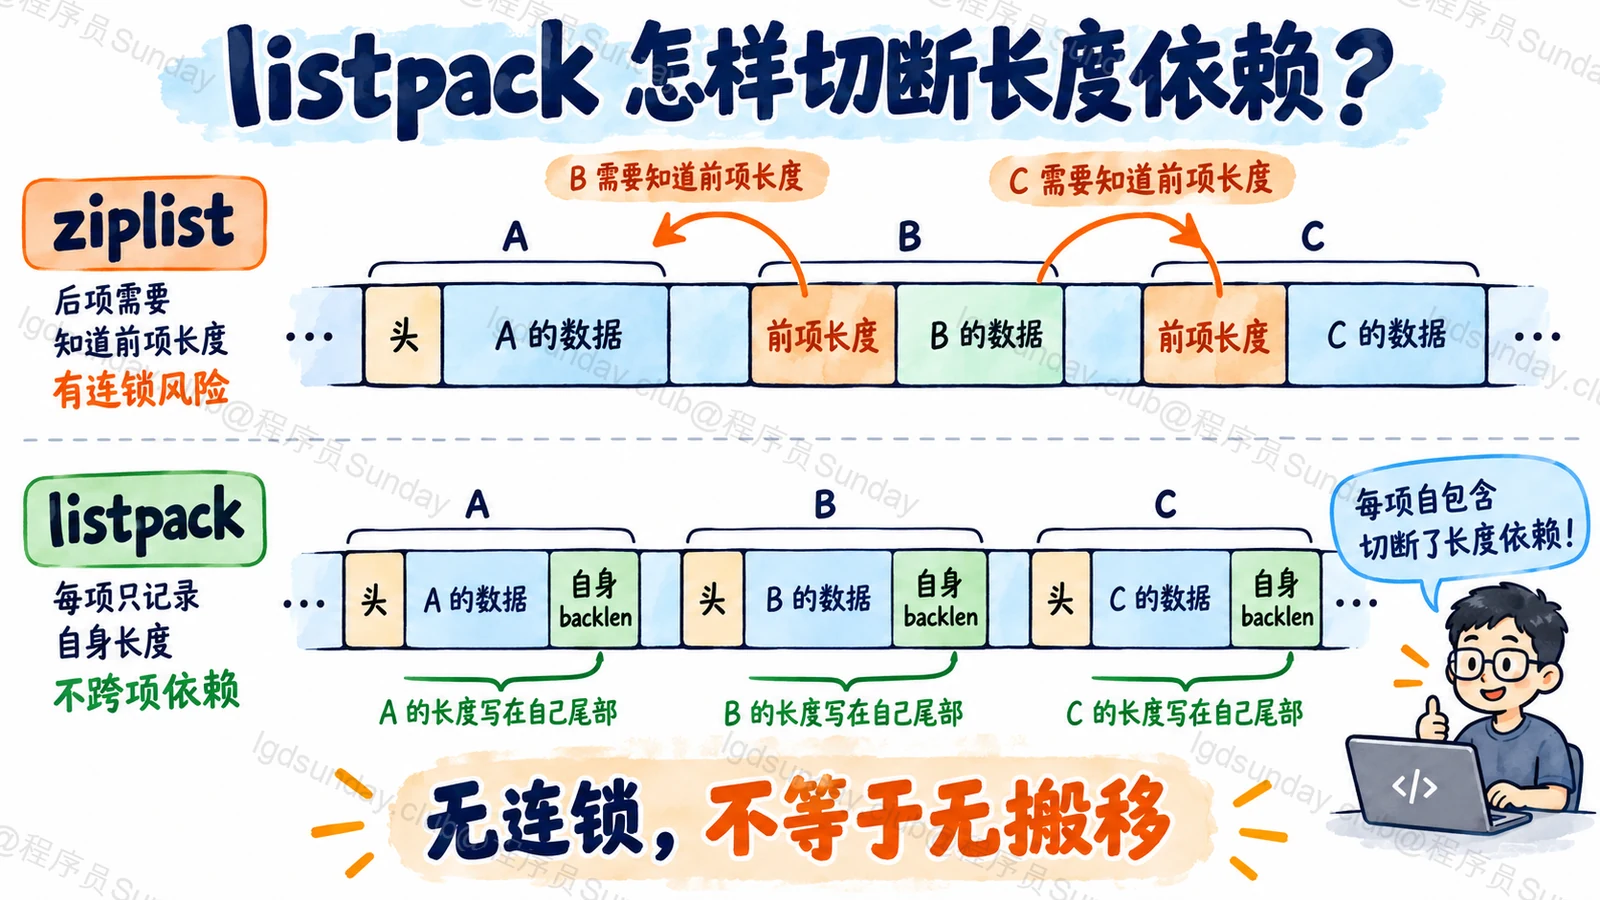
图:listpack 怎样切断长度依赖?。
知识点详解:反向找到上一项,需要把长度放在哪里?
为什么使用连续内存?
假设集合只有几个小值。如果每个值都建一个独立节点,再附上指针,结构开销可能相当明显。
紧凑编码把条目按顺序放在连续区域里,使用适合值大小的编码,减少额外节点。代价是某些修改需要移动后面的内容,查找也不天然得到哈希表那样的访问方式。
先理解这份取舍,才不会把“更紧凑”误读成“所有操作都更快”。
ziplist 的反向遍历为什么会牵连后面?
为了从某个条目找到前一个条目,ziplist 在当前条目里保存前项长度。
假设 A 变长,B 保存 A 长度的字段可能需要更大的编码。B 自己因此变长,C 保存 B 长度的字段又可能变大。满足相关边界条件时,变化就继续传下去。
不是每次修改都会发生连锁,也不是前项任意增加一字节,后面全部一定增加。触发取决于长度编码的边界与实际布局。图里展示的是可能触发的机制,不是假定每次都发生。
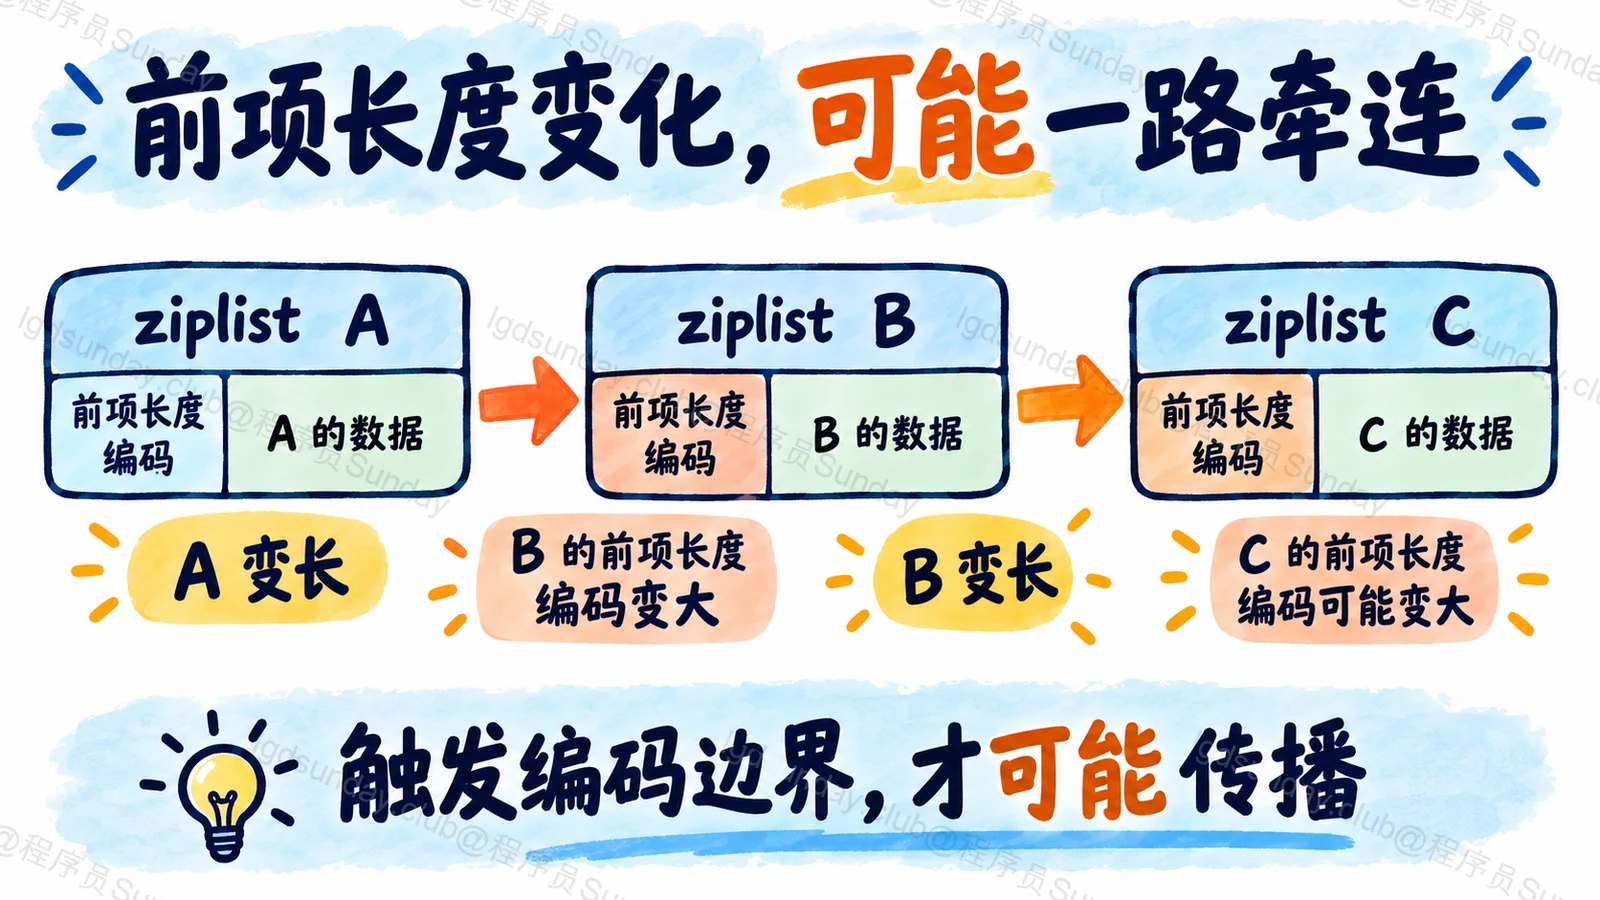
图:前项长度变化,可能一路牵连。
listpack 改变了长度依赖
listpack 条目的末尾放 backlen,记录本项前面的编码与内容所占长度,用于从末尾回退。它不把前项长度嵌进下一项头部。
A 变长时,需要更新 A 自己的相关信息,但不会因为“B 要描述 A,C 又要描述 B”产生相同的连锁依赖。设计理由见 listpack 原始格式说明。
要注意,backlen 不是把整张表的总长度重复记录到每一项里,也不是链表指针。具体字段长度和编码细节,应对照 Redis 8.2 listpack.c。
不连锁,为什么还是要移动?
三个条目连续放在一块内存里,在中间插入一个新条目,后面的字节仍需要腾出位置。原分配空间不足,还可能重新申请并复制。
所以,listpack 解决了一类元数据更新问题,不等于把插入变成常数时间,也不等于不需要扩容。
这也是紧凑编码常与大小条件一起使用的原因。集合增大后,系统会根据数据类型与配置采用其他表示。不要把用户层的 List、Hash、ZSet 与某个内部编码直接画等号。
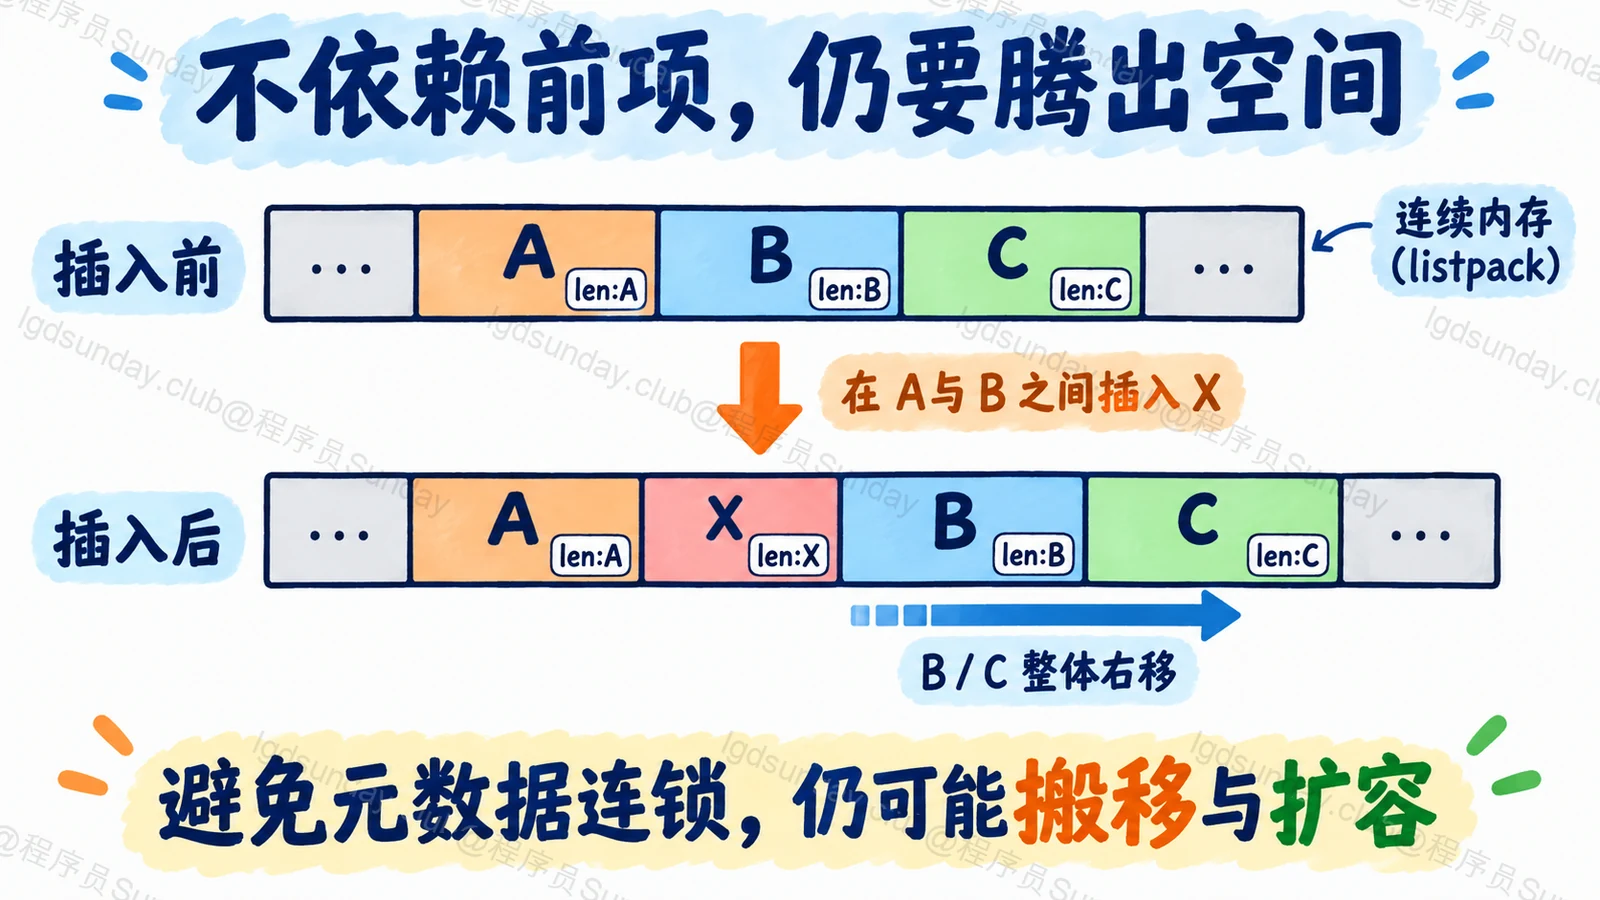
图:不依赖前项,仍要腾出空间。
面试解释到哪一层就够?
先讲紧凑内存为什么有价值,再说明前项长度依赖如何传播,最后讲 listpack 改成局部长度信息及其剩余成本。
没有必要一开始背全部位编码。只有追问具体格式时,再到固定版本源码里核对。本文不伪造 TS、Python 内存布局实现。
面试官继续追问
listpack 能直接代替跳表吗?
不能只按“更紧凑”替换。查找、排序、范围查询与修改复杂度各有要求,表示要服务数据规模与操作模式。
连锁更新没有了,还需要性能测试吗?
需要。实际成本还包含移动、分配和查询。减少一种风险,不代表整体收益无需验证。
面试速记卡
- 共同点:连续内存、紧凑编码,减少节点指针开销。
- ziplist:保存前项长度,边界变化可能产生连锁。
- listpack:本项尾部 backlen,不依赖前项长度。
- 剩余成本:插入搬移与扩容仍可能发生。
- 范围:内部编码不是用户数据类型,也不是通用替代。
公司面试真题
这道题暂未收录可核验的公司真题来源。你可以先阅读本文解析,或浏览已收录的公司面试真题。
浏览公司面试真题 →