
Redis 的大 Key 和热 Key 有什么区别?应该怎么发现和处理?
🧑💻 面试官:Redis 出现热 Key,拆成多个 Key 就解决了?
🙋♂️ 我:对,数据分散,单节点就没那么忙。
🧑💻 面试官:如果客户端还是只查同一个对象,改了名字真的会把访问分散吗?
🙋♂️ 我:那要区分容量大,还是访问多。
🧑💻 面试官:一个只有几百字节的值被每秒查很多次,你查 bigkeys 能发现核心问题吗?
大 Key 是单个对象太重,热 Key 是请求过于集中。它们可以同时存在,但定位数据和处理方向不同。
面试速答(60 秒版)
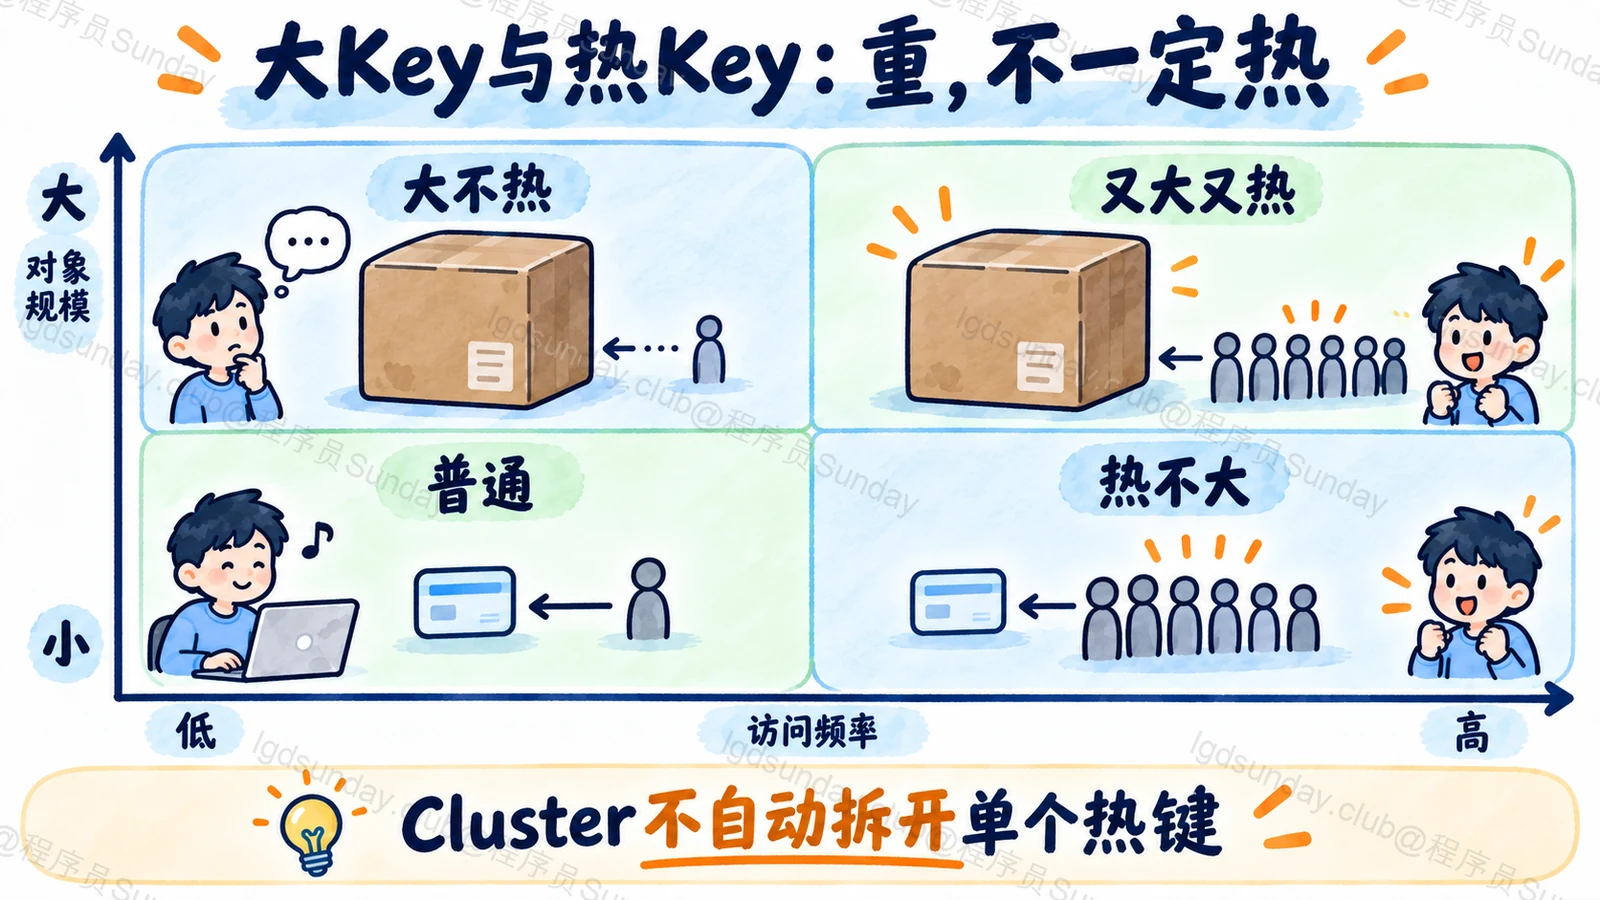
大 Key 指单键的数据量、元素量或操作代价过大;热 Key 指访问或修改集中在少数键。小值也能很热,大集合也可能几乎没人访问。
大 Key 会影响内存、网络、命令耗时和删除回收;热 Key 则可能让单节点、CPU 或网络成为瓶颈。Redis Cluster 按键分片,不会自动把一个热键拆到多台主节点。
排查时结合类型、元素数、内存使用、慢命令和请求频率,采用低风险采样或渐进扫描。不要直接在生产 KEYS * 或全量读取大集合。
读热点可以考虑本地缓存、请求合并和合理副本读;写热点需要重新设计拆分与聚合。所有方案都要说明失效、一致性和下游保护,不能只是换个键名。
知识点详解:先判断重在哪里,再选择拆法
大与热,是两条坐标轴
假设一个 Hash 塞了十万条任务,它可能是大 Key;但一天只读一次,未必是热 Key。另一个值只有几百字节,却被所有页面频繁读取,可能是热 Key,但不大。
“大”也不只看字节。包含大量元素的集合,一次全量遍历、排序或删除,可能产生长时间操作。评判要结合数据类型和命令成本,而不是一个通用 MB 阈值。
两者叠加最麻烦:又大又频繁全量返回,服务器、网络和客户端都会承压。
定位要同时拿到内容规模和访问分布
可以用 MEMORY USAGE、集合元素数及类型信息判断大小;通过应用统计、监控、慢日志和适用的热点分析看访问集中程度。
SCAN 提供渐进遍历,但不是零成本,也不提供稳定快照;结果可能重复,COUNT 不是严格单次条数上限。扫描还要限制节奏,避免加重实例负载。
MONITOR、全量读取以及大范围分析都有开销,不应该作为默认长期开关。高峰故障先控制风险,再收集必要证据。
大 Key 拆分,是缩小单次工作的边界
例如按时间或业务分区把一个巨大集合拆成较小集合,并提供有上限的分页读取。要考虑跨分片查询、过期与删除,不是简单从一个大键变成一万个难管理的键。
删除大对象时,可评估 UNLINK 等异步释放方式。它减少主线程同步释放的部分阻塞,但后台释放仍消耗资源,内存也不是调用成功那一瞬间全部归还。
更重要的是阻止它重新长大:明确元素上限、保留周期和写入规则。
热 Key 拆分,必须真的改变访问路径
只改键名而所有请求仍落到同一个键,热点不会消失。读热点可以短期本地缓存或合并并发加载,但要接受并管理一定的陈旧窗口。
从副本读可能分散读取,也会引入复制延迟和路由成本;写热点不能靠副本承担写入。拆分计数则要重新设计汇总和一致性。
Cluster 把一个键分配到一个槽,稳定时由对应主节点服务,不会把一个对象透明切成多个节点。验收应看单节点负载、热点请求量、缓存失效后的回源和正确性。
本题机制参考:SCAN、UNLINK、Cluster 规范、Redis 延迟诊断。
面试官继续追问
加 Redis 节点就能缓解单热键吗?
不自动能。一个键的槽仍有对应主节点,需要改变读路由或数据与访问设计。
UNLINK 能解决大值 GET 很慢吗?
不能。它处理删除释放的一部分开销,不减少 GET 的序列化、网络传输和客户端处理。
本地缓存为什么还需要回源保护?
多个实例同时失效可能一起请求 Redis 或数据库,应考虑抖动、请求合并与限流,不能只看正常命中时的速度。
面试速记卡
- 大:对象容量、元素量或操作代价。
- 热:访问或写入集中,不要求值很大。
- 定位:规模与频率分别采证据。
- 拆分:要改变单次工作和实际访问路径。
- 边界:Cluster 不会自动拆开一个热键。
公司面试真题
真题根据求职者公开面经整理,题意经过概括,非逐字原话或公司官方题库;本文为 Sunday 的独立解析。
美团 · 开发(含 AI 项目追问) · 原帖未明确批次
怎样处理 Redis 热 Key?(题意整理)
美团面经 ↗
原帖发布于 2025-09-09