
Redis 主从复制怎么工作?全量同步和增量同步如何切换?
🧑💻 面试官:Redis 从库断线重连,每次都要复制全部数据吗?
🙋♂️ 我:对,要重新发一份 RDB。
🧑💻 面试官:如果只断开一秒,主库还保留了这段写入呢?
🙋♂️ 我:那可以补增量。
🧑💻 面试官:能补多少,凭断线时间判断,还是凭复制历史和 offset 判断?
能不能增量补齐,要看复制历史是否匹配,以及缺失区间是否还在 backlog 中。断线短只是有利条件,不是保证。
面试速答(60 秒版)
Redis 复制通常先让从库获得基准数据,再持续接收主库的变更流。全量同步会传输数据集,并补上同步期间的后续变更。
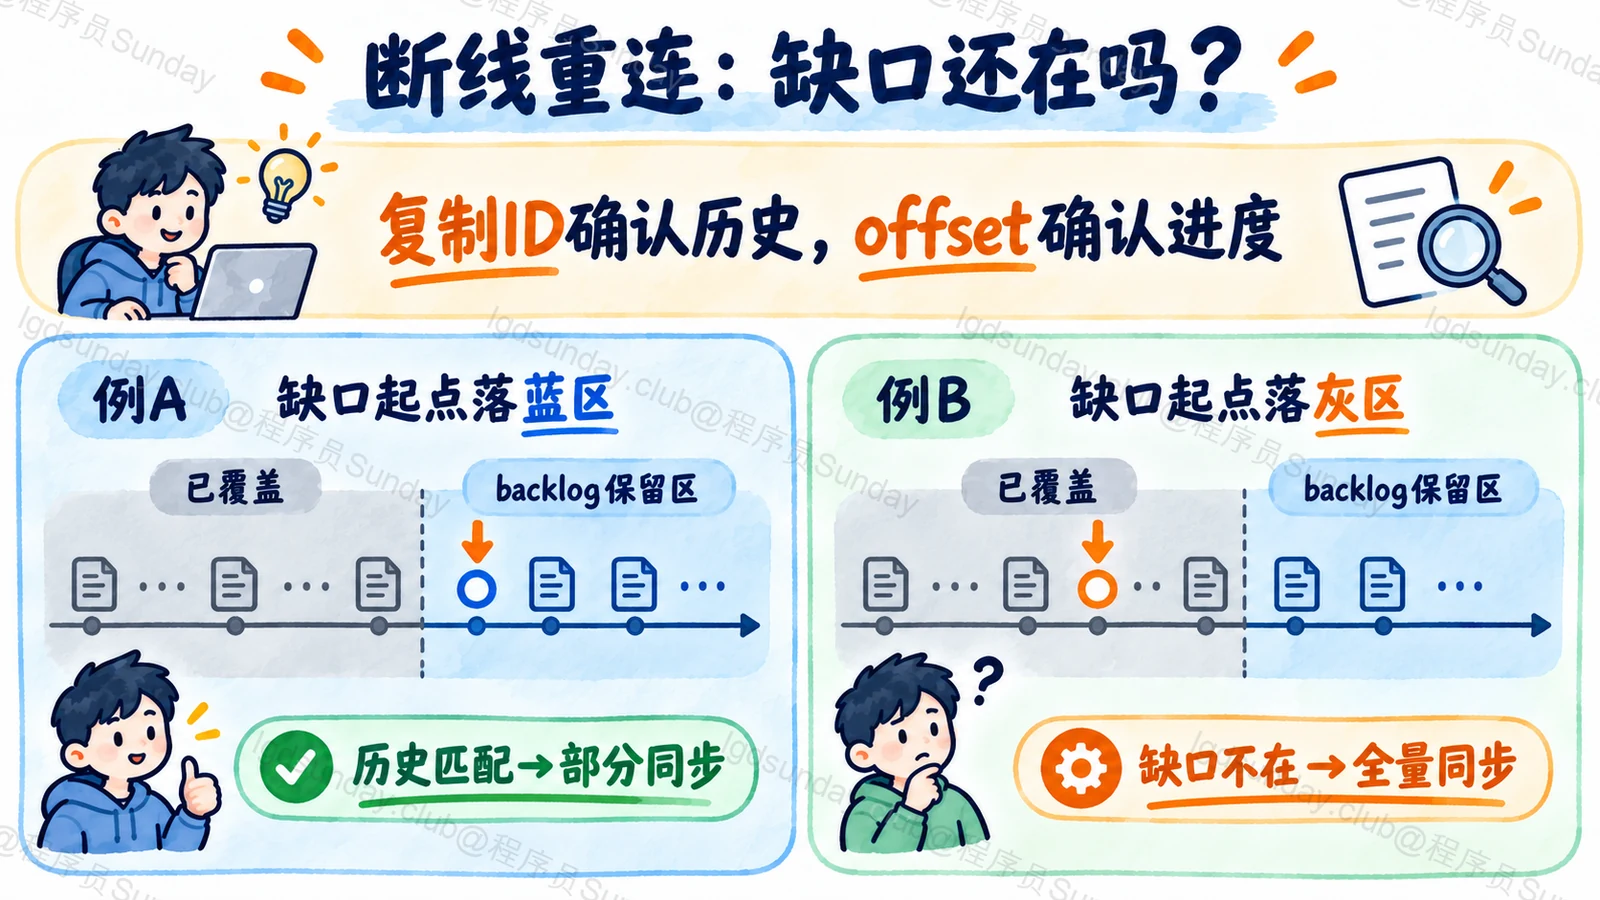
断线重连时,从库带着复制 ID 和已处理的 offset 发起 PSYNC。如果历史匹配、主库 backlog 仍覆盖缺失区间,就有机会部分同步;否则需要重新全量同步。
backlog 是保留最近复制流的一段缓冲,不是永久历史,也不是 AOF 文件。容量要结合写入流量和预期断线时间评估。
复制默认异步,所以写成功不代表所有从库都同步了。WAIT 可以等待复制确认,但不会把 Redis 自动变成强一致数据库,故障切换和持久化仍有边界。
知识点详解:全量基准和连续增量怎样接起来
从库首先需要一个共同起点
假设主库已经有一百万条缓存,从库是一台空实例。只从此刻开始转发新写入,从库仍然缺少之前的数据。
全量同步提供数据集基准,再把生成和传输期间积累的后续变更接上。基准不一定非要先落成磁盘文件再传输,具体可以有无盘复制等配置方式。
因此全量同步成本包括生成、传输、加载和积累增量,并不是只有“一次网络复制”。大数据集与频繁重连会影响资源和延迟。
复制 ID 标识历史,offset 标识进度
同样的数字 offset,在不同历史里没有相同含义。主从需要用复制 ID 确认历史,再用偏移确定从哪一段继续。
例如从库停在某个偏移,而主库最近仍保留后续所有字节,主库可以补上缺口。如果缺口的起点已被覆盖,不能靠猜测跳过,只能重新取得基准。
这是复制字节流的进度,不是业务记录条数。“落后一万 offset”不能直接翻译为少了一万条数据。
backlog 是有限窗口,不是备份
假设复制流平均每秒 2 MB,预计断线 30 秒,那么仅按平均值估算就需覆盖约 60 MB,还应考虑突发、增长和配置行为。这个数字是容量推演,不是性能实测或推荐默认值。
窗口太小,重连容易全量同步;窗口更大则占更多内存。要观察实际流量、部分同步成功率和资源余量。
AOF 用于持久化,是另一种职责。不能因为磁盘上还有 AOF,就认定主库能按任意历史 offset 给从库做部分同步。
复制确认不是所有故障的兜底
默认异步时,主库响应成功到从库应用之间有窗口。主库故障并切到落后的从库,已确认写入仍有丢失可能。
WAIT 可以让客户端等待此前同一连接的写入被一定数量副本确认,但应检查返回数量和超时。它不等于磁盘持久化确认,也不会改变所有切换场景的强一致保障。
读副本也可能得到旧值。关键读写、缓存重建和故障恢复,要根据允许损失与陈旧程度分别设计。
本题机制参考:Redis replication、WAIT、Redis persistence。
面试官继续追问
RDB 和复制 backlog 都保存数据,有什么不同?
RDB 是数据集快照,backlog 是最近复制流窗口,保存对象与用途不同。
主库切换后一定全量同步吗?
不一定。复制历史管理允许某些切换或重启条件下继续部分同步,仍要检查 ID、偏移和保留范围。
WAIT 返回达到要求,能承诺永不丢数据吗?
不能。需要结合持久化、实际副本和切换条件理解,文档明确它不把复制变成强一致方案。
面试速记卡
- 全量:先取得基准,再接后续变更。
- 部分同步:历史匹配,缺口仍在 backlog。
- offset:复制流进度,不是记录条数。
- backlog:有限窗口,不能代替 AOF 或备份。
- 异步:副本可落后,WAIT 不是强一致魔法。
公司面试真题
真题根据求职者公开面经整理,题意经过概括,非逐字原话或公司官方题库;本文为 Sunday 的独立解析。
美团 · 开发(含 AI 项目追问) · 原帖未明确批次
Redis 主从同步的流程是什么?(题意整理)
美团面经 ↗
原帖发布于 2025-09-09