
Google ADK 是什么?LlmAgent 和工作流 Agent 有什么区别?
下面是用于讲题的模拟面试对话。
🧑💻 面试官:ADK 的 SequentialAgent 里放了两个大模型,是不是两个模型商量着决定执行顺序?
🙋♂️ 我:它应该按开发者列出的顺序执行,里面的模型只负责各自的任务。
🧑💻 面试官:那第二个 Agent 怎么知道第一个写了什么?
🙋♂️ 我:需要明确传递结果,比如写入会话状态,再由下一步读取。
🧑💻 面试官:如果换成 ParallelAgent,第二个还能直接依赖第一个刚生成的结果吗?
ADK 里的名字都带 Agent,控制流程的方式却不一样。先看谁安排执行顺序,再看步骤之间怎样交接数据。
面试速答(60 秒版)
Google ADK 是一套构建、组合和运行 Agent 应用的开发框架。它既能让模型决定下一步,也能用明确的工作流组织多个步骤。
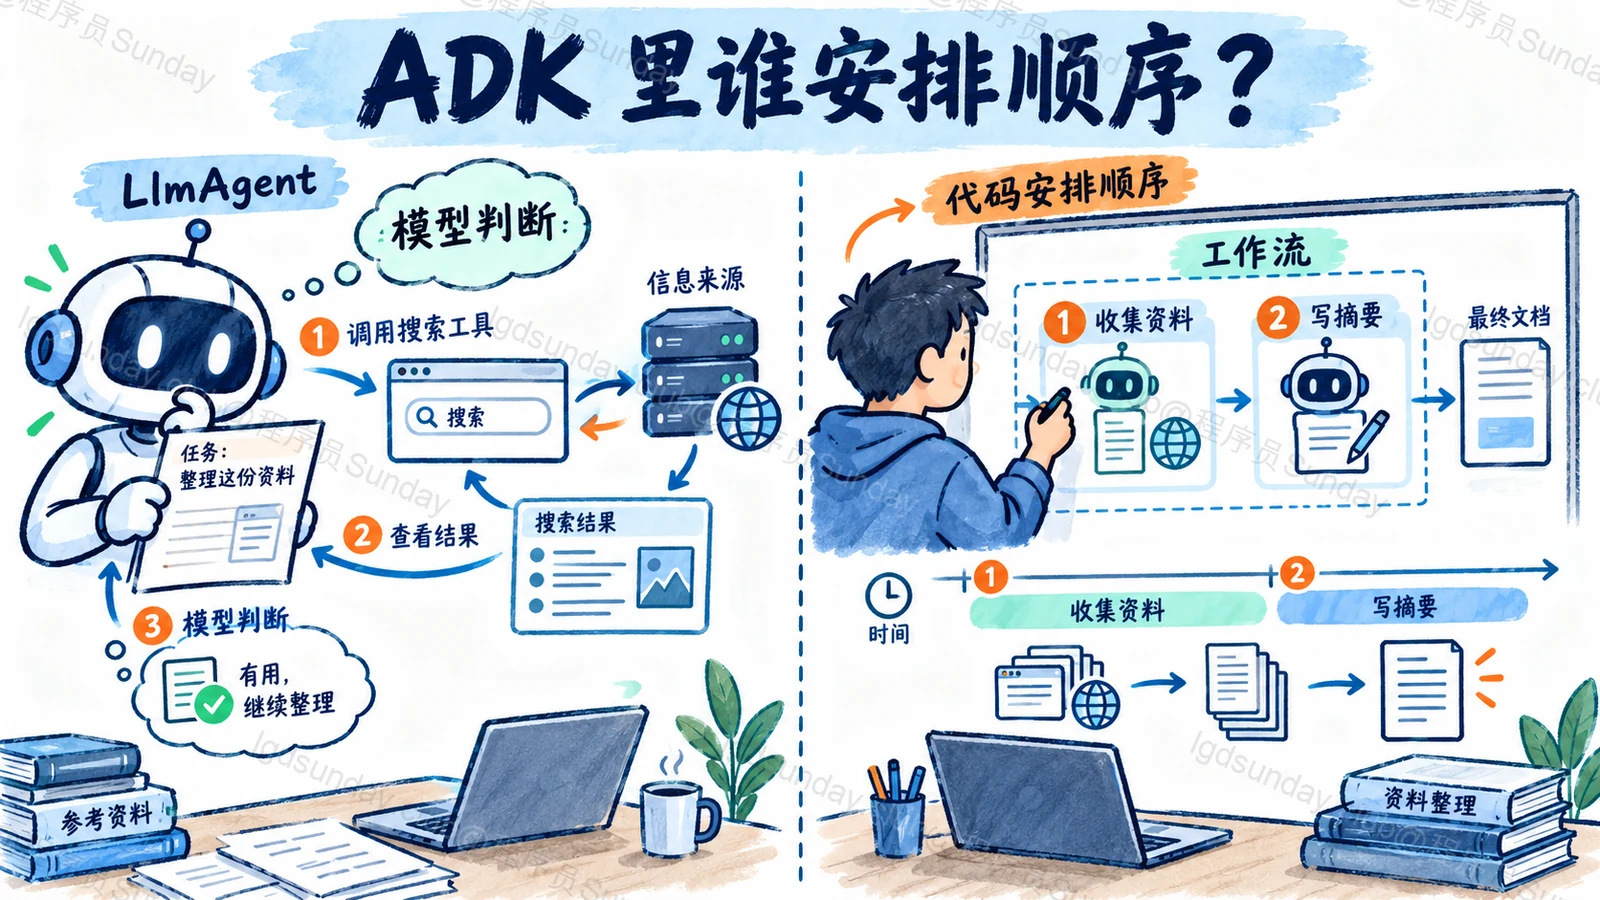
LlmAgent 负责根据指令和当前输入调用模型。需要使用什么工具、怎样继续完成当前目标,可以由模型参与判断。
工作流 Agent 则主要负责安排子 Agent 怎么运行。例如 SequentialAgent 按顺序执行,ParallelAgent 并行执行,LoopAgent 组织重复执行。流程组件本身不需要为了决定这些顺序再调用一次大模型,但它们里面可以包含 LlmAgent。
因此,两者完全可以组合。假设要先查资料,再写报告,可以让顺序工作流安排两步,让每一步的 LlmAgent 处理自己的开放任务。组合之前还要约定输入、输出和状态字段,不能因为画出了执行顺序,就认为数据也自动传好了。
知识点详解:工作流安排顺序,模型完成局部任务
先把一个资料整理任务拆开
假设用户要一份产品资料摘要,而且要求每条结论保留来源。开发者可以把任务拆成“收集资料”和“根据资料写摘要”。
收集资料时,模型可能需要判断搜索词是否合适、证据是否够用,这部分适合由 LlmAgent 处理。摘要 Agent 则读取已经收集的材料,组织内容。
但是,第二步必须等第一步有了结果。这个依赖已经确定,就可以交给顺序工作流安排。外层流程确定,并不会让里面的模型失去局部判断能力。ADK 的 Agent 概览也将模型执行单元和更大的工作流组合分开介绍。
三种模板,处理的是不同依赖
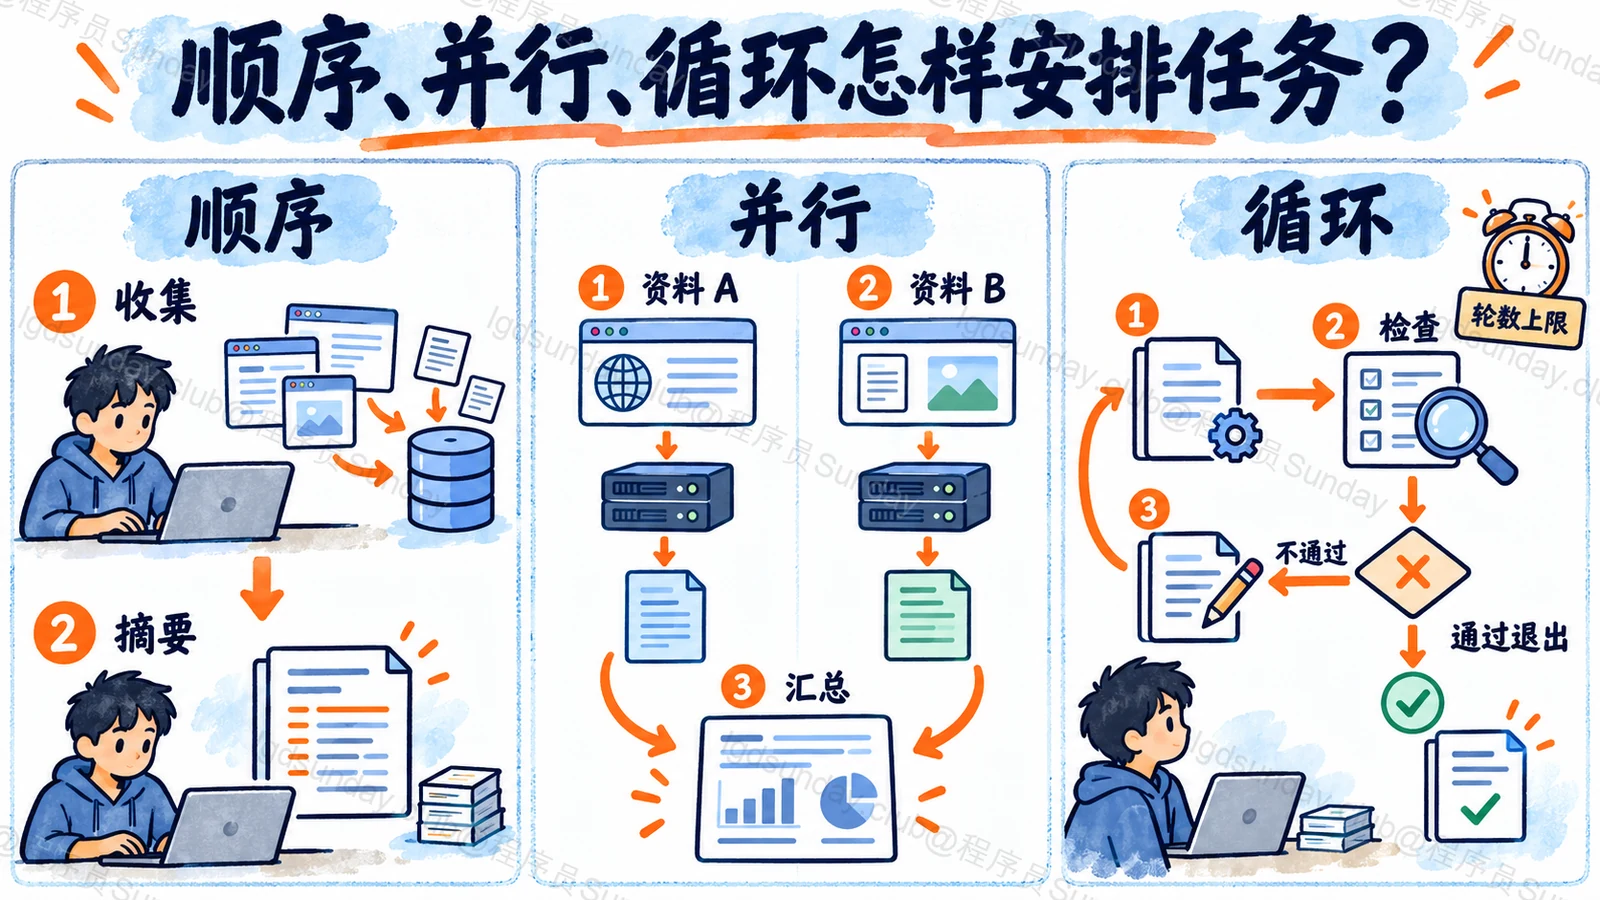
SequentialAgent 按配置顺序运行子 Agent。它适合“拿到材料以后才开始摘要”这种依赖。前一步失败以后是否继续,仍需要结合错误处理设计,不能把执行顺序当成成功保证。
ParallelAgent 适合互不依赖的工作。例如分别整理两家公司的公开材料。这里的两个分支都读取已经准备好的输入,然后各自写入独立结果;最后再由后续步骤汇总。不要让它们同时覆盖同一个“摘要”字段。
LoopAgent 重复运行内部步骤,适合生成后检查、需要时修改的过程。但是重复执行不等于一定会进步。必须规定怎样退出、最多执行多少轮,以及评审结果是否真的能够判断任务完成。
这些控制组件也称为 Template workflows。ADK 当前文档还包含其他工作流方式,面试回答不必把这三种模板说成整个框架的全部能力。
数据交接要单独写清楚
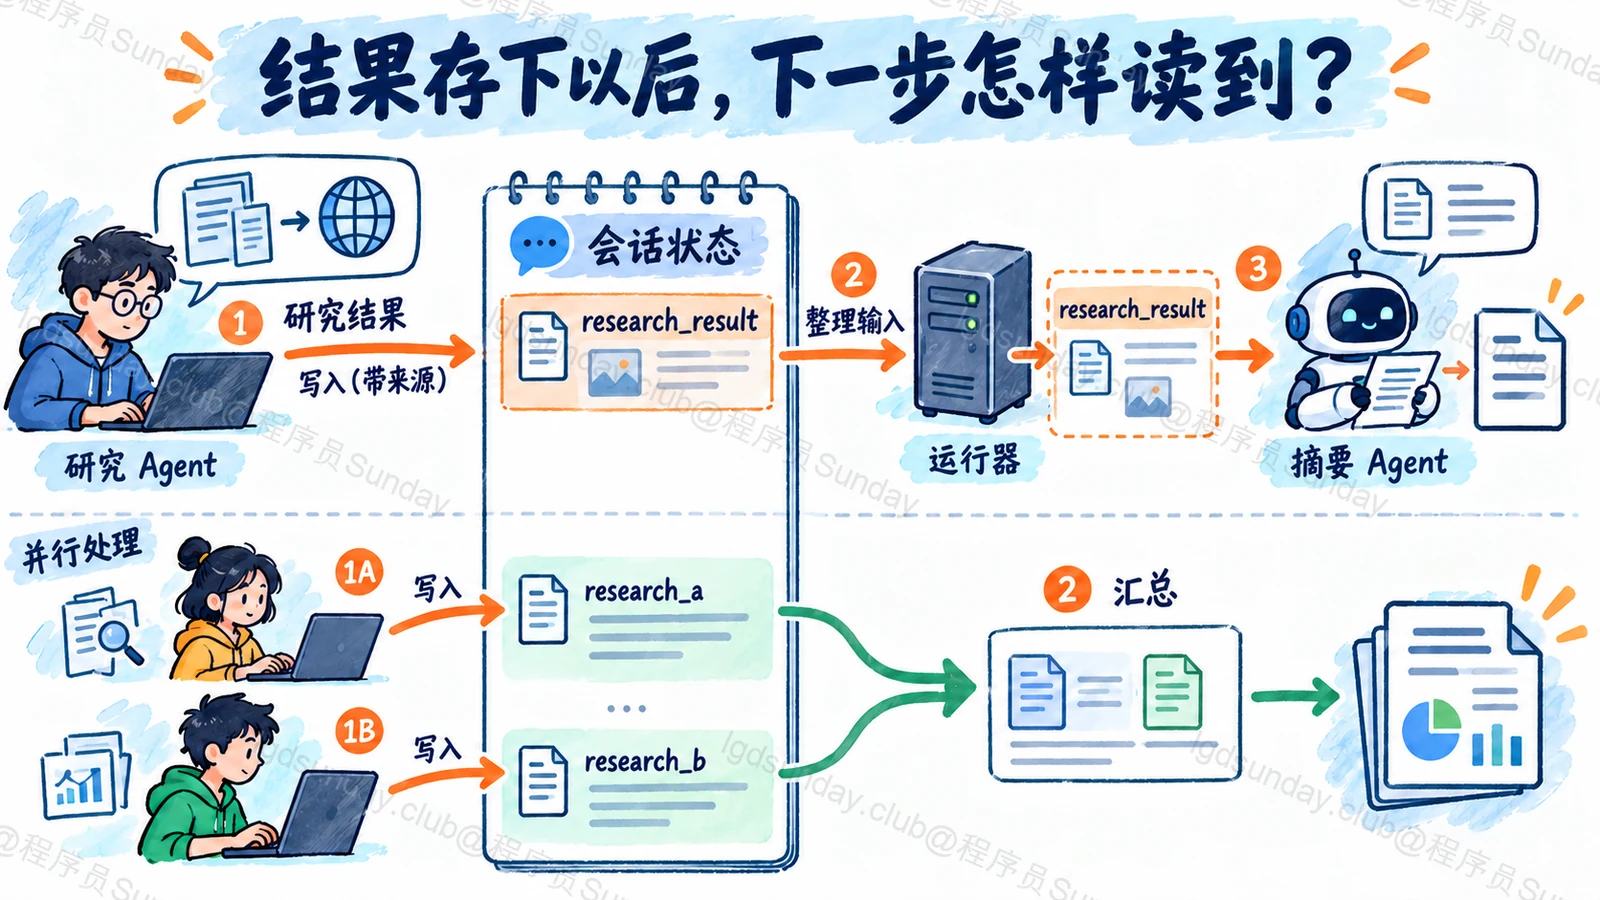
回到资料整理任务。收集步骤可以把结果保存为 research_result,摘要步骤明确读取它。ADK 的 LlmAgent 支持用 output_key 将最终输出放入会话状态,具体值的类型还与输出配置和语言实现有关,见 Simple agents。
注意,这里只完成了保存。后续 Agent 的输入还需要包含它所需的那部分材料。不能认为所有状态字段都会自动变成模型这一轮看见的内容。
同时,资料里应保留链接、取得时间和适用范围。只保存一段“研究已完成”,下一步没有依据可以用。并行时则使用 research_a、research_b 这样的独立字段,再由汇总步骤检查缺失或失败结果。
怎么检查组合有没有按预期运行?
先用固定输入替换真正的模型结果,检查顺序、字段传递和分支汇总。让收集步骤故意失败,确认系统不会把空材料当成完整证据。再给循环一个始终不通过的评审结果,确认达到轮数上限会明确返回失败或交给人工处理。
控制流正确以后,再接入真实模型,检查来源是否支持摘要。前一组测试证明流程接对了,后一组才检查模型任务做得怎么样。本文按核验日官方文档解释机制,没有把这些建议写成已经完成的模型实测。
面试官继续追问
既然 LlmAgent 能调用其他角色,为什么还用顺序工作流?
如果业务已经确定必须先收集、再摘要,就没有必要再让模型每次猜一次顺序。模型路由适合执行路径需要动态调整的地方,明确依赖则可以直接写在流程里。
并行是不是一定缩短耗时?
只有分支能够独立推进,而且模型配额、工具和下游容量允许并发时,才可能得到收益。汇总仍要等待必要分支,遇到限流还可能更慢。比较时要同时看完成时间、失败率和资源消耗。
能让两个分支同时修改一份共享材料吗?
要明确合并规则和写入顺序。更简单的方案是分支分别生成产物,再用一个汇总步骤合并。共享状态可以保存数据,不代表它会自动解决并发覆盖与语义冲突。
面试速记卡
- LlmAgent 让模型参与当前任务的判断。
- 工作流 Agent 安排子步骤的执行方式。
- 顺序处理依赖,并行处理独立分支,循环必须有退出条件。
- 执行顺序与数据交接分别设计,保存状态后仍要组织模型输入。
- 先验证控制流,再检查模型结果和来源质量。
公司面试真题
这道题暂未收录可核验的公司真题来源。你可以先阅读本文解析,或浏览已收录的公司面试真题。
浏览公司面试真题 →