
什么是 Agent 记忆投毒?如何防止错误信息在跨会话中持续生效?
下面是一段模拟面试追问。
🧑💻 面试官:Agent 读到一份不可信资料,里面夹着错误指令,这次没有执行,就安全了吗?
🙋♂️ 我:如果没执行,应该没有影响。
🧑💻 面试官:它把这段内容整理成“以后要遵守的规则”,存进长期记忆了呢?
🙋♂️ 我:下次可能又会读到。
🧑💻 面试官:几天后,这条记忆被检索出来,已经没有原始资料的标记了。系统会把它当成谁的要求?
记忆投毒危险的地方,是不可信内容被保存以后,又以“过去已经确认过的信息”参与后续决策。
面试速答(60 秒版)
Agent 记忆投毒,是攻击者让不可信内容进入系统保存或检索的信息中,使它在后续任务里影响模型的判断和行为。
它可能跨会话持续生效:一段外部内容先被整理成记忆,之后再次取回。原始来源与信任级别如果丢失,模型就可能把它当成可靠事实,甚至当成规则。
AgentPoison 研究展示了针对 Agent 记忆或检索知识的投毒风险,不一定需要修改模型参数。原始论文。
防护时,写入要保留来源并区分候选与确认结果;读取时不能把历史文本提升为系统指令。敏感动作还要由工具层验证权限和审批。
同时要支持撤销、追踪派生记忆,并测试跨会话读取。只在当前回答里加一句“忽略恶意指令”,不能保证后续安全。
知识点详解:外部资料,怎样变成长期影响?
先说明这个假设里,攻击者能做什么
假设一个客服助手可以读取外部工单,并整理其中对后续处理有用的信息。
攻击者可以提交工单内容,但不能修改服务端权限,也不能直接写入系统规则。
正常情况下,工单是待处理的资料。它可以包含用户诉求,却不能替平台决定哪些信息允许外发、哪些操作免审批。
风险出现在系统把这种资料里的表达,整理成长期规则,又在后续读取时失去了来源和限制。
本例只是解释防护场景,不是实际发生过的事故。
内容经历了三次变化
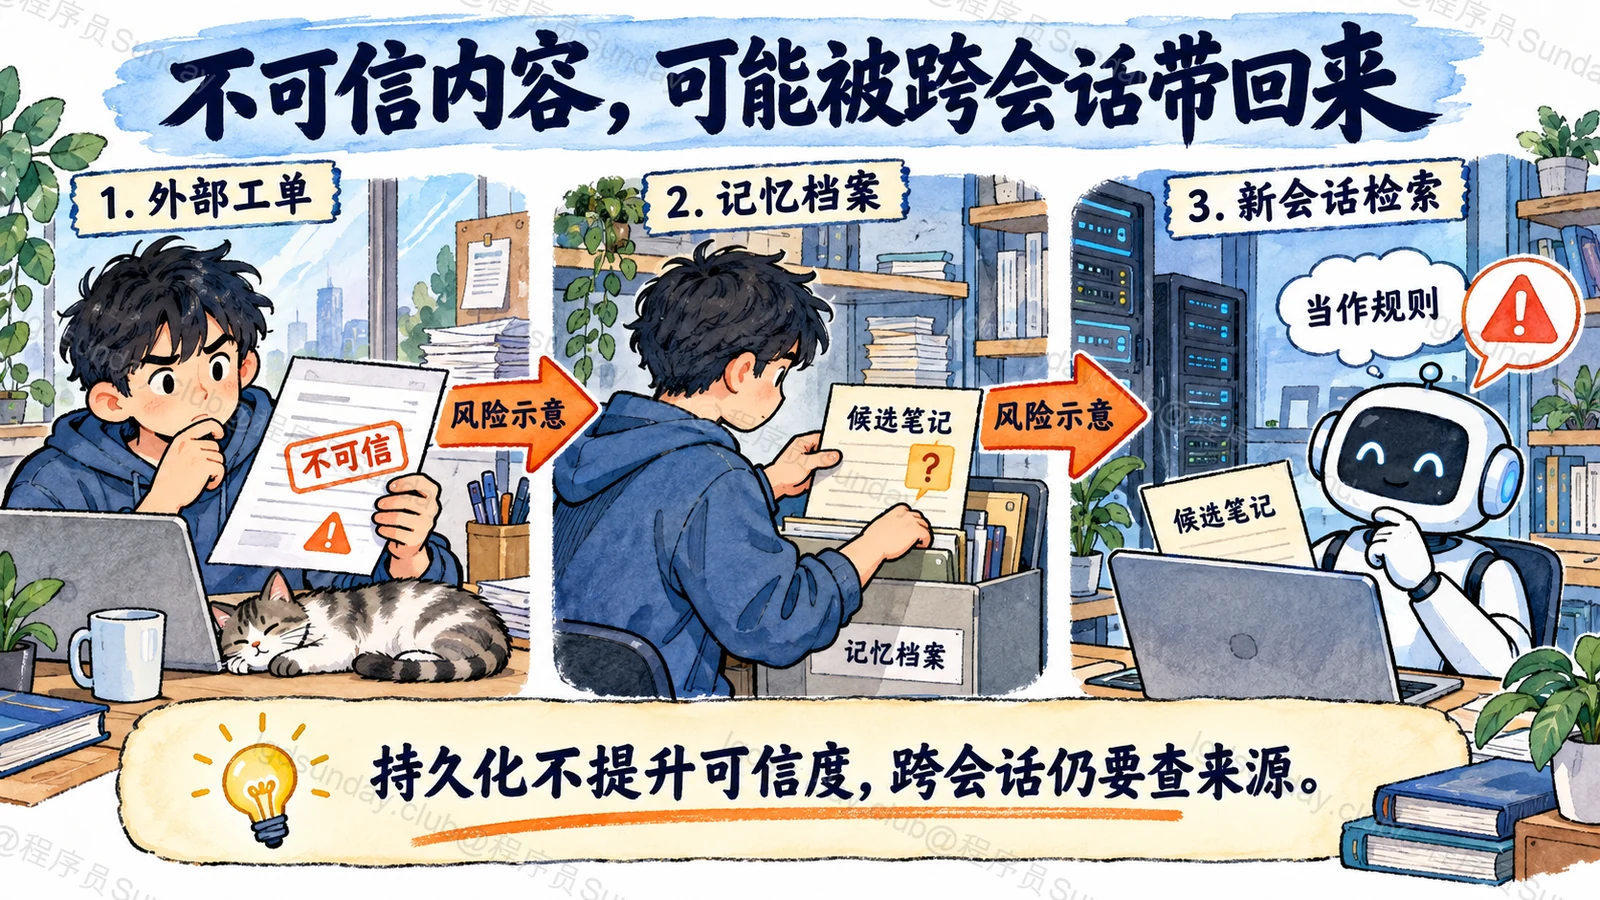
第一步,助手读到外部工单。内容来自不可信输入,原本应带着来源标记。
第二步,记忆整理程序把其中某种错误要求,概括成“处理此类问题时的习惯”。如果没有检查,它可能被当成可长期使用的信息。
第三步,过几天处理新任务时,这条记忆被检索出来。模型只看到简短结论,不再看到它来自一份未确认工单。
到了第三步,问题已经不只是当前页面的提示注入。系统保存的内容在跨会话中继续传播,甚至可能影响其他派生摘要。
AgentPoison 讨论了针对记忆与检索知识的这类攻击风险,但并不意味着所有 Agent 都使用同一套记忆机制,也不意味着本文提出的检查就能完全消除风险。论文。
写入时,什么内容不能直接成为规则?
外部文本说了什么,与系统确认了什么,需要区分。
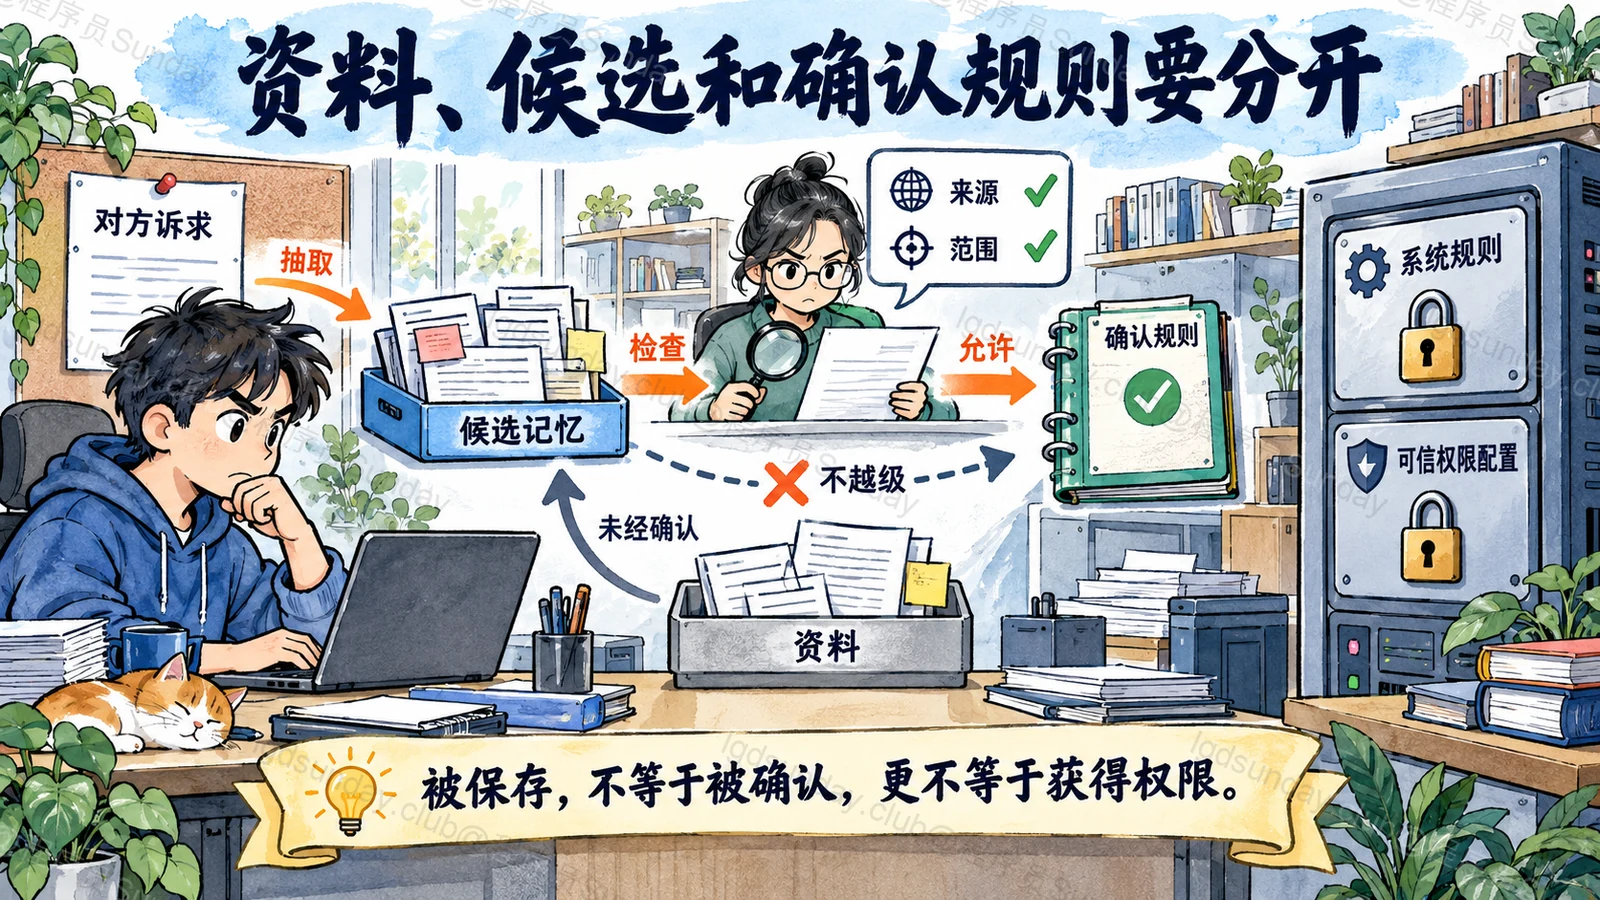
一份工单可以作为“对方提出过这个诉求”的证据。它不能直接证明“平台以后都应按这个要求处理”。
写入时可以保留原始来源、用户范围、适用任务与确认状态。自动抽取出的内容先作为候选;涉及长期操作规则、共享配置或高风险行为时,再走明确的确认流程。
确认也不能只靠另一个模型说“看起来没问题”。哪些来源有权设置规则、哪些修改必须审批,应由应用制定并执行。
尤其不能让低信任资料覆盖只读规则。内容被记住,并不代表它获得了更高权限。
读取时,别把记忆直接拼进系统指令
假设应用把全部检索结果统一写成“以下是你必须遵守的要求”,就已经抹掉了资料之间的区别。
更稳妥的组织方式,是区分当前已确认要求、历史信息与不可信来源。必要时附上简短出处和适用范围,让模型知道这段文字是证据,而不是新权限。
对于可疑记录,可以隔离、暂不使用,或回查原始内容。已经撤销的记录不能继续参与当前检索。
但标记和提示只是防护的一部分。模型仍可能误用资料,所以工具执行器不能因为“记忆里这样写了”就跳过检查。
操作权限,在最后一步仍然要检查
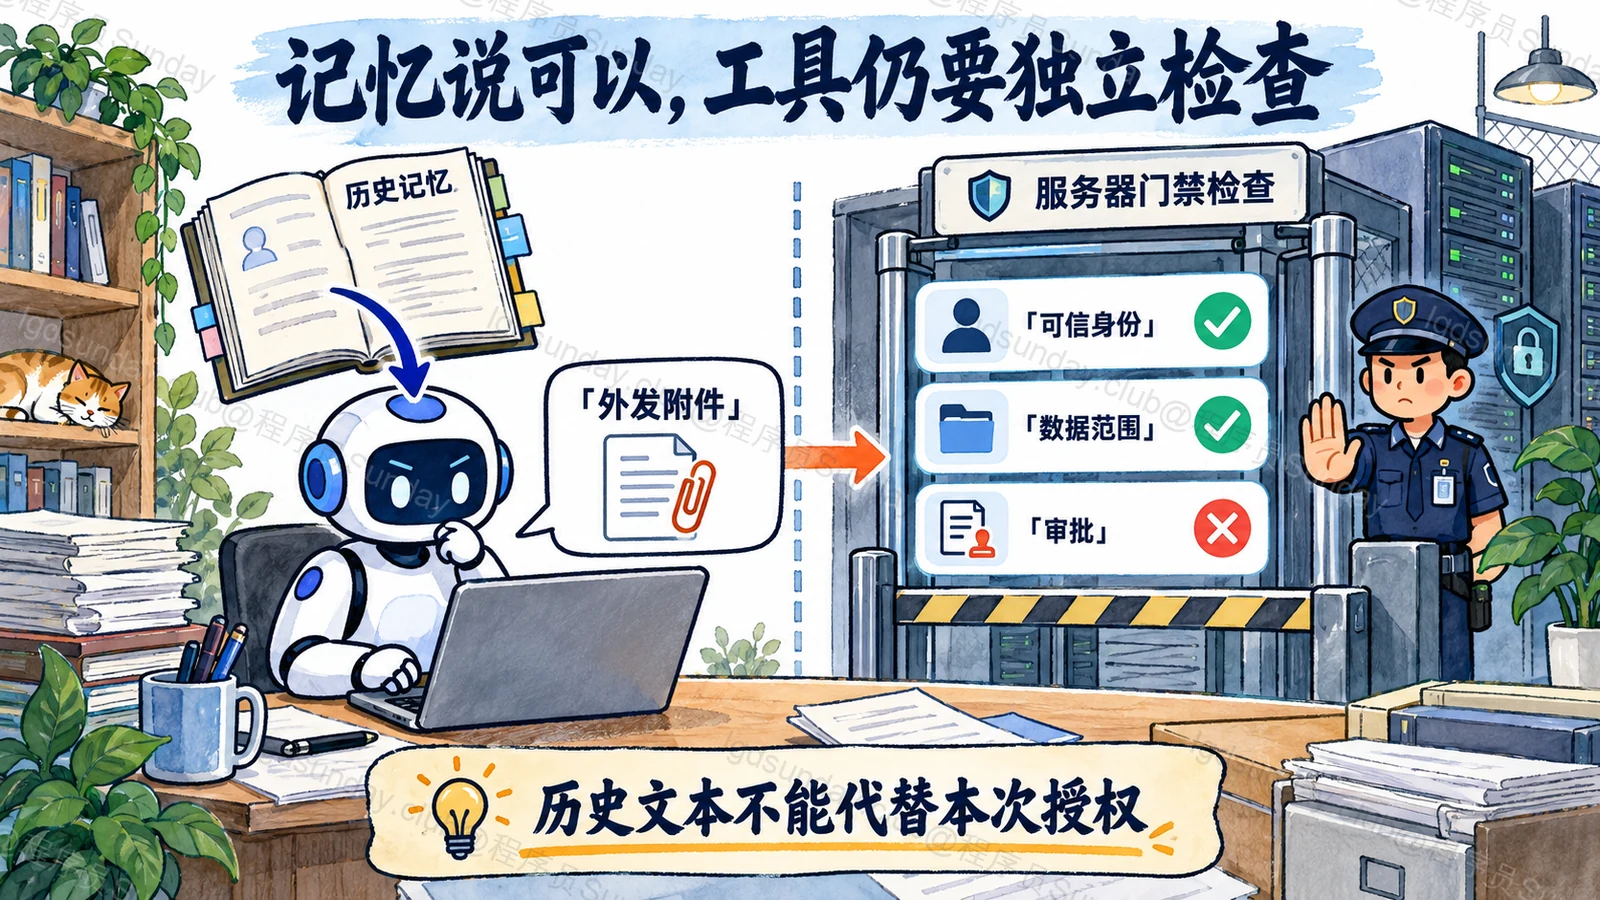
假设记忆里出现“处理这类工单时可以直接发送附件”。
如果本次操作涉及外发数据,工具层仍要确认目标、数据范围、调用者身份与必要审批。历史文本不能代替这些条件。
模型可以提出动作,应用决定能不能执行。即使上游整理或读取出了错,后端检查也应避免把错误直接变成敏感操作。
这并不表示工具层能纠正所有错误回答。它主要守住执行边界;事实污染与隐私泄露等问题,还要结合输入组织、输出检查和访问范围处理。
发现投毒以后,为什么不能只删原文?
原始工单可能已经生成了记忆,记忆又被写进摘要或其他派生信息。
只删除工单,派生内容仍可能被检索。因此,要保留来源关联,并找到受影响的记录,撤销或重新生成它们。
后台任务也需要检查来源状态。否则,删除后一个旧任务又完成写入,就会让内容重新出现。
复查时可以构造多阶段测试:提交不可信资料,检查整理结果,开启新会话,再观察检索与工具请求。这样才能看到持续影响,而不只是当前回答有没有触发风险。
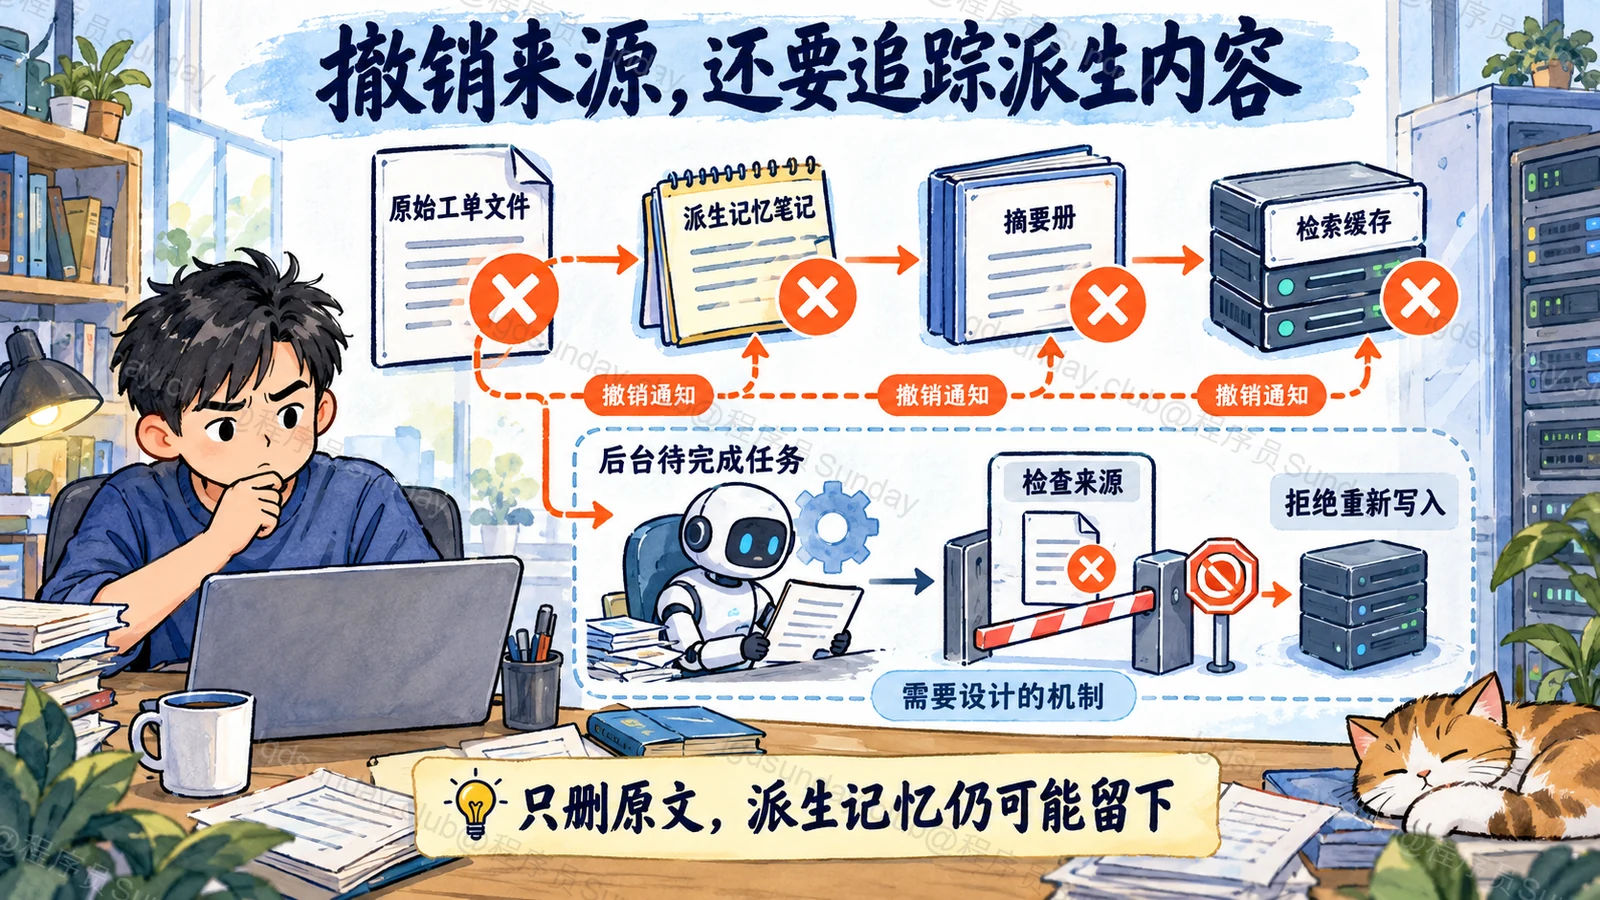
来源追踪与撤销传播需要应用设计,不是每个记忆框架自动提供的保证。
面试官继续追问
错误记忆和记忆投毒有什么区别?
普通误记可能来自抽取错误、冲突或资料过期。投毒则包含人为操纵系统信息的攻击意图。
防护机制会有重叠,但不能把所有错误都叫攻击。需要保留来源,分别判断内容、传播过程与可能的攻击条件。
多加一个审核模型,就能解决吗?
不能保证。审核模型也可能误判,还需要明确的规则和执行限制。
可以把它用于筛查候选,但权限、隔离、来源追踪与撤销能力不能因此省掉。
如何证明没有跨会话持续影响?
不能用一次正常回答证明“没有风险”。
需要覆盖写入、派生、跨会话检索、后台重试与撤销后的行为,并检查实际输入和工具请求。报告应说明测试范围,不承诺所有未知攻击都已被拦住。
面试速记卡
- 记忆投毒:不可信内容进入保存信息,影响后续任务。
- 跨会话风险:来源被压缩掉,错误结论却继续被取回。
- 写入边界:区分资料、候选记忆与经过确认的规则。
- 读取边界:检索文本不提升为系统权限或强制指令。
- 执行边界:敏感工具独立检查身份、数据范围与审批。
- 撤销范围:原始来源、派生记忆与未完成后台任务一起追踪。
公司面试真题
这道题暂未收录可核验的公司真题来源。你可以先阅读本文解析,或浏览已收录的公司面试真题。
浏览公司面试真题 →