
Agent 长期记忆怎么评测?LongMemEval 和 LoCoMo 分别测什么?
下面是一段模拟面试追问。
🧑💻 面试官:你说 Agent 有长期记忆,怎么证明它真的好用?
🙋♂️ 我:隔几天问它之前的事情,看看能不能答出来。
🧑💻 面试官:旧偏好后来被纠正了,它应该回答哪个?历史里根本没有答案,它会不会编一个?
🙋♂️ 我:还要测更新和不知道的情况。
🧑💻 面试官:最后答错了,是没存进去、没取回来,还是取回来以后理解错了?
长期记忆评测不能只问“记不记得”,还要问:记对了没有、条件变了怎么办,以及缺少证据时会不会乱答。
面试速答(60 秒版)
Agent 长期记忆评测,需要把多次交互中的历史信息与后续问题对应起来,检查系统是否能找到并正确使用证据。
LongMemEval 原始基准关注信息提取、跨会话推理、知识更新、时间推理和无答案时的拒答。LoCoMo 则围绕长跨度、多会话对话构造问答等任务,可以帮助检查系统对历史信息的理解。LongMemEval、LoCoMo。
不过,基准分数不能代替自己业务中的验证。需要另外覆盖用户隔离、项目切换、偏好修改、来源撤销和敏感操作。
出现错误时,把写入、检索和回答分开排查。最后还要记录成本与延迟,注明数据集、模型和系统版本,不把不同条件下的分数直接比较。
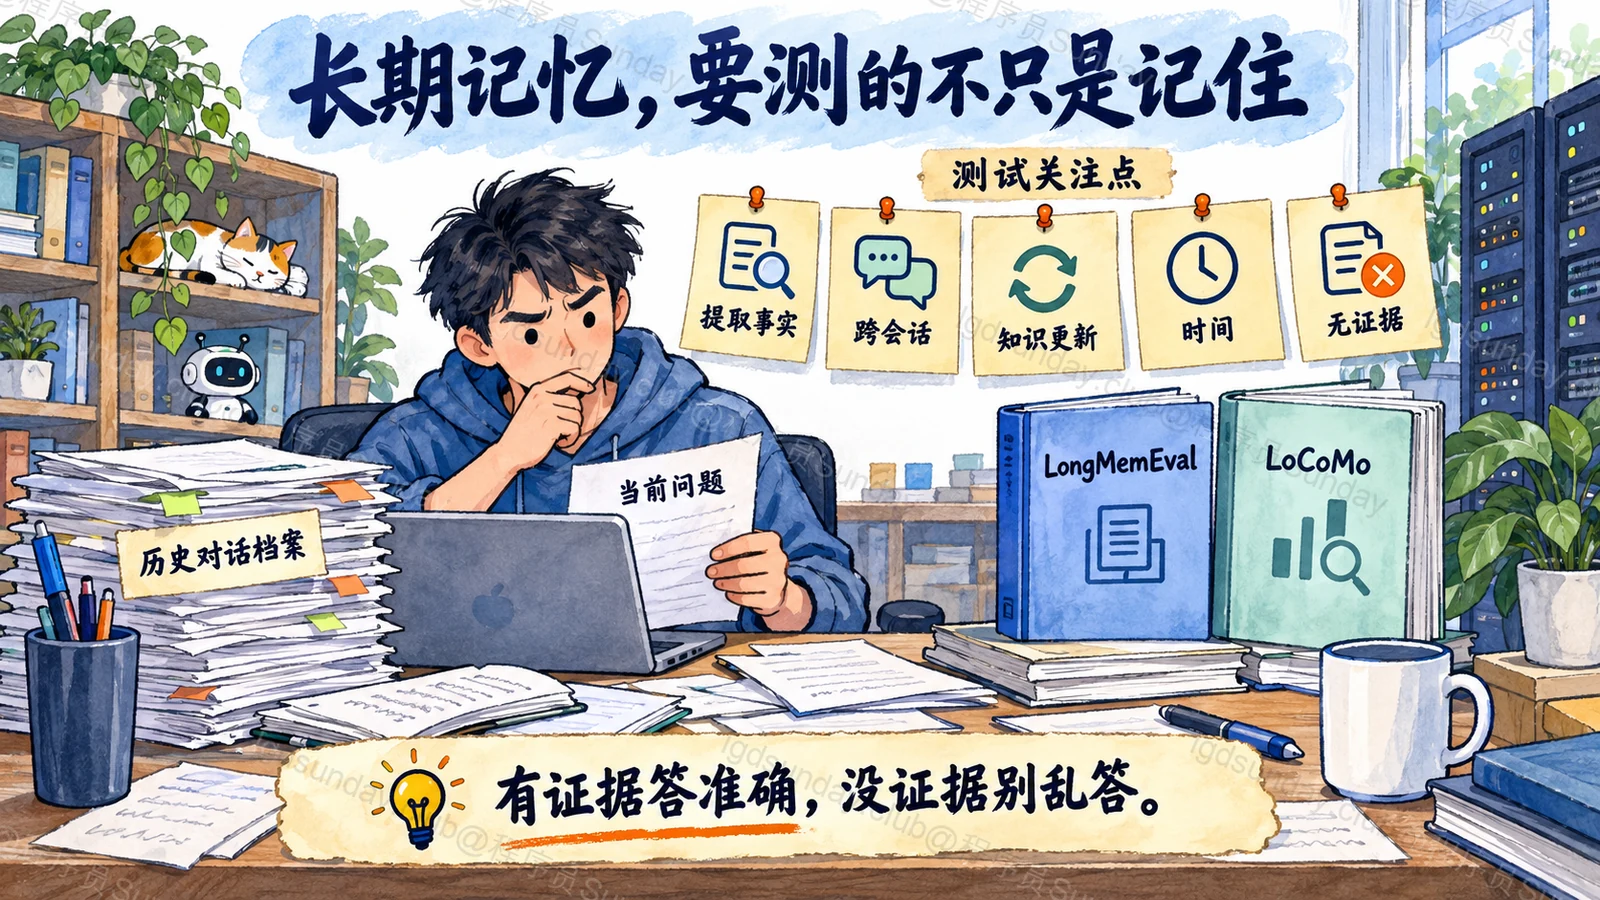
图中列的是本篇的测试关注点,不表示 LongMemEval 与 LoCoMo 使用完全相同的任务分类。
知识点详解:一条历史信息,从保存到答对,要经过哪些检查?
先为问题确定正确证据
假设我们测试一个学习助手,给它连续提供三条信息:
- 三月:用户平时偏好 TypeScript。
- 六月:项目 A 已改用 Python。
- 七月:用户确认,项目 A 的教程也用 Python,但其他项目没有统一要求。
接下来,可以问“项目 A 的新示例用什么语言”“三月通常偏好什么语言”“项目 B 已经确定用哪种语言了吗”。
第一题应结合项目 A 的更新。第二题要回答历史情况。第三题缺少项目 B 的确定要求,不应把项目 A 的规则直接搬过去。
测试前就要标明答案、适用范围与来源消息。不能先看模型答了什么,再临时判断“感觉也合理”。
以上是教学用的小样例,不是本文实际运行过的评测结果。
两个公开基准,侧重点不完全一样
| 基准 | 本题使用的范围 | 可以帮助发现什么 |
|---|---|---|
| LongMemEval | 原始 ICLR 2025 基准 | 跨会话事实、知识更新、时间关系与无答案问题是否被正确处理 |
| LoCoMo | 原始项目中的长期对话问答设置 | 对多会话内容及时间、跨段关联等信息的理解是否可靠 |
LongMemEval 项目后来还发布了新的版本;LoCoMo 也有不同任务与评测设置。因此,报告里要写清版本和子任务,不把不同设置的结果混成一个“长期记忆分数”。
这两个基准都是测试材料,不是记忆存储框架。跑得高,也不能据此保证跨用户隔离或业务权限正确。
先查写入,再查检索,最后查回答
假设系统把项目 A 的新示例写成了 TypeScript。
第一步,检查新要求是否被保存。原始消息存在,但整理后的记忆漏掉了“项目 A”,就可能在写入阶段已经出错。
第二步,检查回答时的候选与最终输入。正确记录可能存着,却没被检索到;也可能已经命中,但在截取或拼装时被挤掉。
第三步,检查模型怎样使用证据。它看到了新要求,仍按旧偏好回答,就属于使用过程中的错误。
这三种情况都表现为“最后答错了”,需要的修改却不同。只看最终正确率,很难找到具体原因。
可以分别保存来源消息 ID、生成的记忆、检索候选与最终输入,并把它们关联到同一条测试任务。
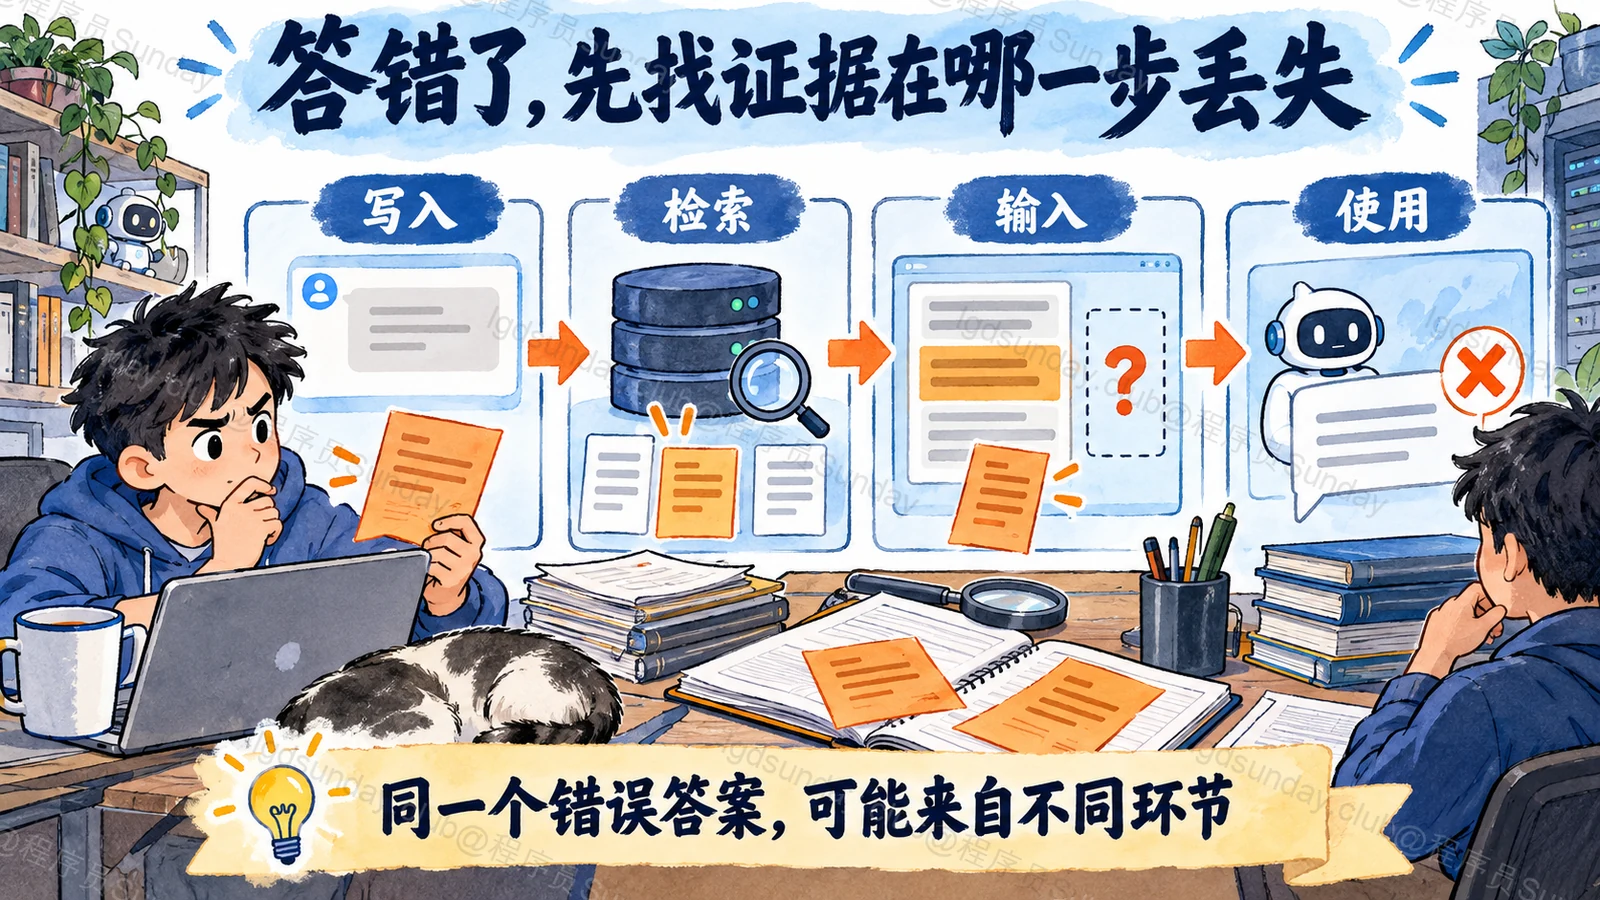
给足证据以后,还答错吗?
为了判断检索是否拖了后腿,可以增加一组诊断:直接把人工标明的必要证据交给回答模型,看看它能否完成同一道题。
如果直接给证据能答对,正常检索却答错,就继续检查读取链路。如果给足证据仍答错,再分析条件理解和推理。
LongMemEval 提供了证据会话等评测设置,可以帮助做这类对比。项目说明。
但“给足证据”也是一种实验设置。它不能代替真实检索,更不能因为这一组成绩好,就宣称系统已经能自动找齐证据。
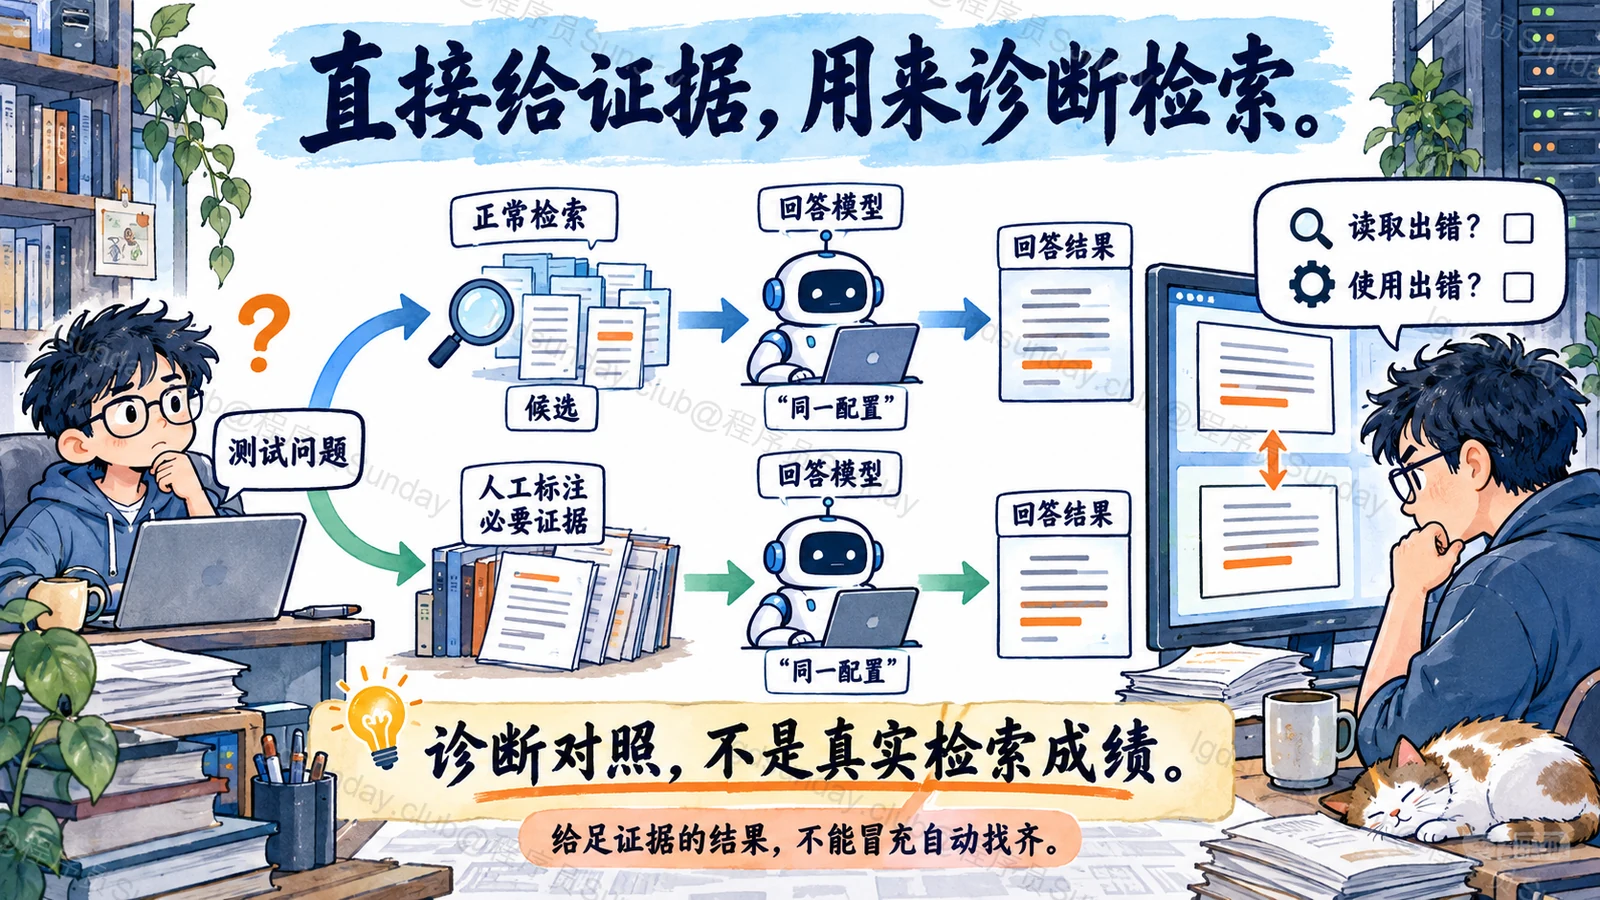
直接给必要证据是诊断对照,不能当成正常检索链路的成绩。
业务评测还要补哪些情况?
至少补上真实系统里的边界问题。
例如两位用户提到同名项目,系统不能串用记忆;用户删除一项偏好,旧后台任务不能重新写回来;请求缺少可靠历史,助手应澄清或说明不知道。
涉及高风险动作时,还要检查是否把历史关系误当成当前授权。这类问题应单独列出,不能被大量普通问答的平均成绩冲淡。
同时记录写入耗时、检索与生成开销、记忆可见延迟,以及重复执行的稳定性。
自动判分可以帮助处理大量结果,但要抽样人工检查。表达不同但事实正确,和语气肯定却证据错误,是两种情况。
面试官继续追问
只测检索命中率,够不够?
不够。命中了正确记录,模型可能没看到,或者理解错了。
要区分候选命中、最终证据是否完整与最终回答是否正确。权限和敏感内容也要单独检查。
正确率提高,成本翻倍,算不算优化成功?
要看业务要求。不能只凭一个指标下结论。
在相同任务和版本条件下比较质量、延迟与成本,再确定提高是否值得。不能把更大的输入预算带来的收益,全部归因于记忆算法。
测试里能使用真实用户历史吗?
需要满足授权和隐私要求,尽量脱敏并限制访问。
没有合适权限时,可以构造明确标注的测试历史。不要为了看起来像真实数据,就虚构用户案例并声称已经在线验证。
面试速记卡
- 测试内容:记住事实、跨会话关联、更新、时间与无答案情况。
- 基准区分:LongMemEval 与 LoCoMo 要注明版本和任务设置。
- 错误定位:分别检查写入、检索、最终输入与回答。
- 证据对照:给足证据用于诊断,不冒充自动检索效果。
- 业务边界:用户隔离、删除撤销与敏感操作单独测试。
- 报告要求:固定条件,记录质量、成本、延迟与人工复查结果。
公司面试真题
这道题暂未收录可核验的公司真题来源。你可以先阅读本文解析,或浏览已收录的公司面试真题。
浏览公司面试真题 →