
Mem0 是什么?如何从对话中提取并检索 Agent 的长期记忆?
下面是一段模拟面试对话。
🧑💻 面试官:给 Agent 接入 Mem0,就能记住用户了吗?
🙋♂️ 我:把聊天传给 Mem0,之后检索相关记忆给模型就行。
🧑💻 面试官:用户说“这次用 Python 举例”,你会把它保存成长期偏好吗?
🙋♂️ 我:不应该直接这样理解,得保留这次任务的范围。
🧑💻 面试官:那记忆写入请求已经返回,下一轮就一定能查到吗?查询结果又会自动出现在模型输入里吗?
Mem0 帮应用处理记忆,但“值得记什么、写完没有、这一轮怎样使用”,仍然需要分开确认。
面试速答(60 秒版)
Mem0 是面向 AI 应用的记忆组件,可以从交互内容里提取事实、偏好等信息,保存后供后续任务检索。它同时提供托管 Platform 和自行运行的开源方案。Mem0 Add 文档。
接入时可以把它分成两条链路。写入链路接收对话,形成记忆;读取链路根据当前问题和用户范围检索,再由应用把合适的结果整理进模型输入。
所以,保存成功不等于模型已经知道。模型只有在这一轮拿到了相关记忆以后,才有机会使用它。
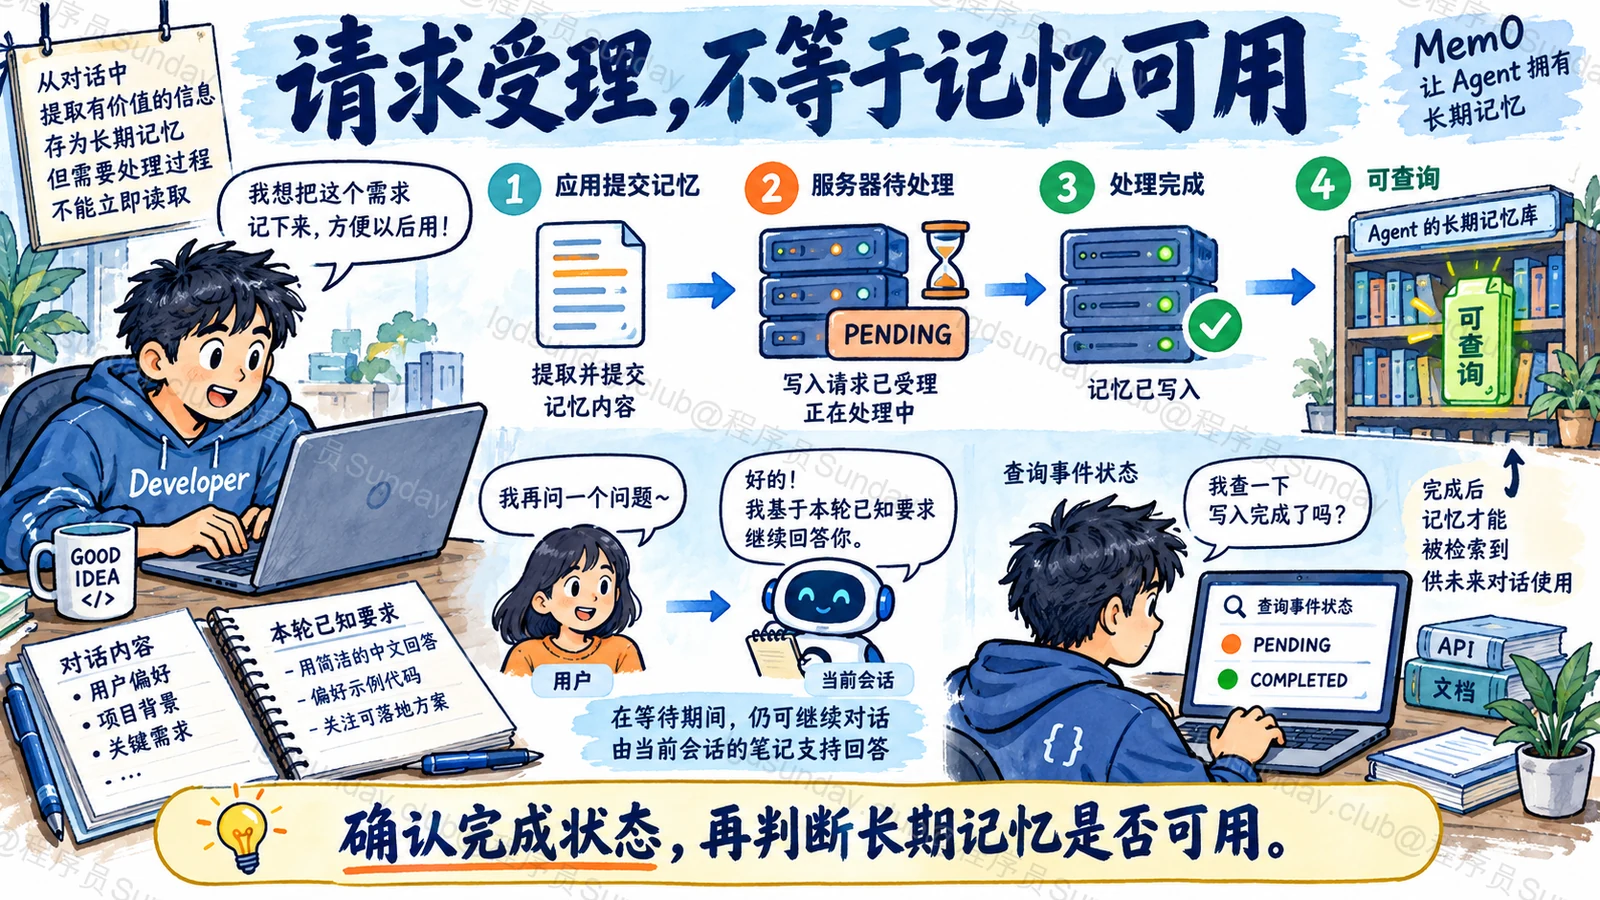
另外,当前 Platform 的写入可能先返回待处理事件,应用需要确认完成状态,不能刚提交就假设下一轮一定查得到。抽取结果和检索范围也需要检查,尤其不能把临时要求变成长久偏好。
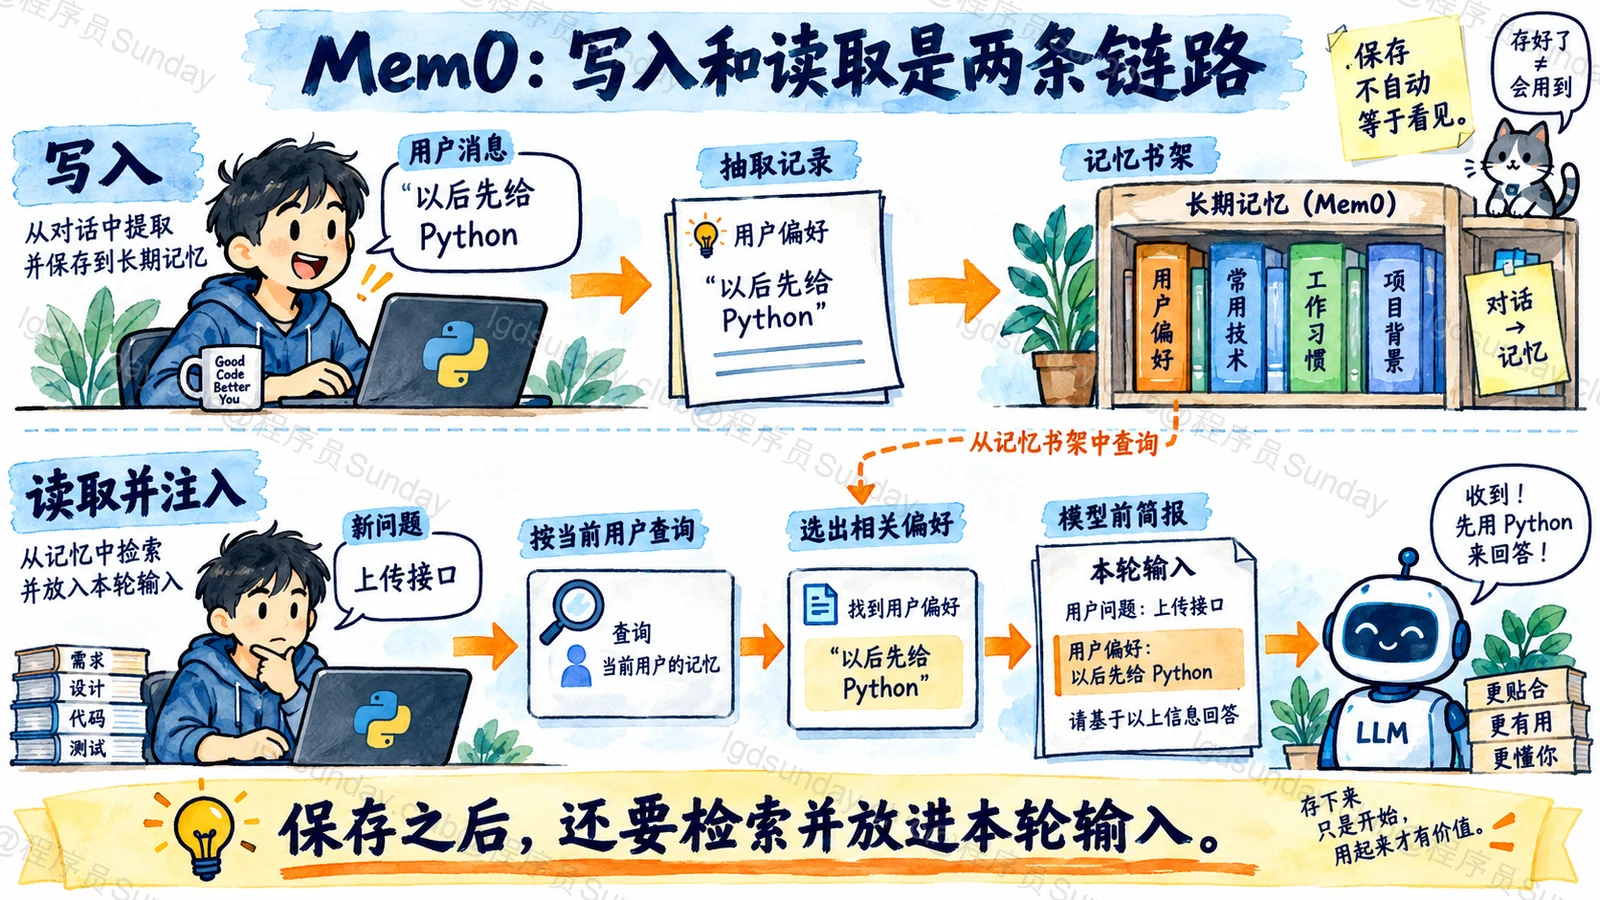
知识点详解:一次对话怎样变成下一次能用的记忆?
第一步,先确认用户究竟表达了什么
假设咱们在做一个编程学习助手。用户说:“以后讲解代码时,希望先给 Python 示例;TypeScript 可以放在后面。”
这和“这道题先用 Python”不一样。前者明确表达了一般偏好,后者可能只影响当前任务。
应用可以把相关对话交给记忆抽取组件,但抽取出来的内容仍然需要符合保存策略。比如只允许保存用户明确表达的偏好,不推测职业、身份或其他敏感信息。
这里的策略是应用要求,不是说 Mem0 默认替所有项目完成同样的审核。
第二步,提交写入以后,要看实际状态
当前 Add 文档把写入描述为抽取后追加保存,并明确提醒新增记忆不会通过这一操作自动覆盖或删除既有记忆。不要拿旧教程里的更新流程,推断今天所有版本的 add 都有相同行为。当前写入说明。
对于 Platform,文档给出的提交结果可以是 PENDING 和 event_id,随后查询事件确认处理是否完成。
因此,在应用里至少要分清“请求已受理”和“记忆已可用”。如果用户下一句话立刻依赖刚才的要求,可以先从当前会话状态读取,不必等待长期记忆索引处理完才继续对话。
也不要因为助手回复了“我记住了”,就把这句回复当作保存成功的证据。
第三步,读取要带着正确范围
接下来用户问:“怎样实现一个上传接口?”
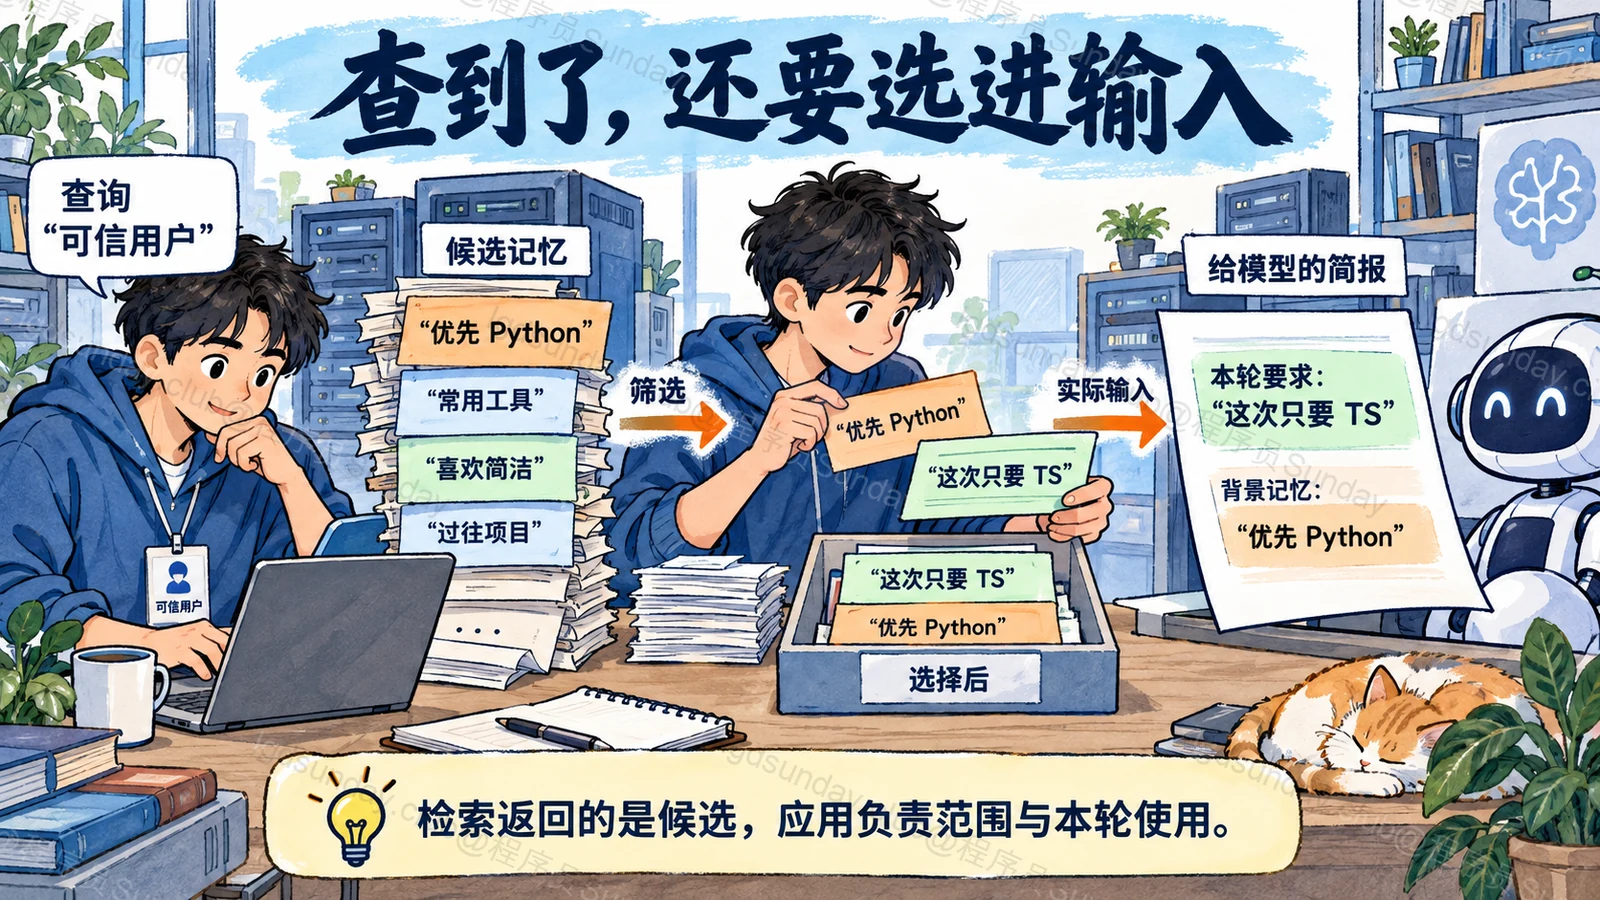
应用应该检索与这个问题有关的记忆,而不是把该用户全部历史都搬进输入。同时,用户标识要来自可信登录信息,不能让模型或客户端随意指定他人的 ID。
下面只展示 Mem0 Platform 的读取调用,按 2026-10-09 官方 Python 和 JavaScript 示例核对。TypeScript 使用 JavaScript SDK;Python 使用 Python SDK。示例没有实际调用远程服务,也没有声称完成跨语言运行测试。Mem0 Search 文档。
import { MemoryClient } from "mem0ai";

const apiKey = process.env.MEM0_API_KEY;
if (!apiKey) throw new Error("缺少 MEM0_API_KEY");

const client = new MemoryClient({ apiKey });
const userId = "demo-user"; // 演示值;生产环境从可信登录身份取得
const memories = await client.search("代码示例的语言偏好", {
  filters: { user_id: userId },
});
// 接下来由应用检查结果,并选择要加入模型输入的内容
import os
from mem0 import MemoryClient
client = MemoryClient(api_key=os.environ["MEM0_API_KEY"])
user_id = "demo-user" # 演示值;生产环境从可信登录身份取得
memories = client.search(
"代码示例的语言偏好",
filters={"user_id": user_id},
)
# 接下来由应用检查结果,并选择要加入模型输入的内容这两段代码只是取得候选记忆,不包含回答生成。过滤字段也不能脱离 SDK 版本照搬;Platform 与 OSS 的参数和返回结构应分别核对。
第四步,应用把记忆和新问题一起交给模型
假设结果里确实有“示例优先使用 Python”,应用可以把它标成用户偏好,连同本轮上传接口问题一起提供。
如果用户本轮明确要求“这次只要 TypeScript”,就以本轮要求为准。长期偏好是背景,不应该压过当前清楚的选择。
出现错误时,沿链路查:原话有没有被误抽取,写入有没有完成,查询范围是否正确,结果有没有进入本轮输入,以及模型是否按适用范围使用。
面试官继续追问
Mem0 和向量数据库是不是一回事?
不是。
向量数据库主要提供存储与检索能力。Mem0 还提供面向交互内容的记忆处理接口。选型时仍要看所用版本到底包含哪些处理能力,不能只按名字判断。
用户改口了,直接再 add 一次就够吗?
不能先做这个假设。
需要核对当前版本的更新、失效和检索语义,再检查旧偏好是否仍会被拿来回答。通用长期记忆维护方案可以接着看 Q060。
怎样验证接入有没有效果?
准备跨会话测试,分别覆盖明确偏好、临时要求、用户纠正和无关任务。记录原始来源、写入状态、候选结果与实际模型输入。
如果测试只能证明“接口返回了数据”,还不能证明助手正确记住并使用了用户信息。
面试速记卡
- Mem0:提供交互信息的记忆处理与检索能力。
- 两条链路:先形成记忆,再按任务检索和注入。
- 写入状态:提交受理不等于记忆已经可用。
- 用户范围:检索身份来自可信应用信息,不由模型决定。
- 使用边界:长期偏好不能盖过本轮明确要求。
公司面试真题
真题根据求职者公开面经整理,题意经过概括,非逐字原话或公司官方题库;本文为 Sunday 的独立解析。
阿里巴巴 · 基础平台研发 · 实习(原帖提及实习时长)
是否了解 Mem0?(题意整理)
阿里巴巴控股一面-基础平台研发(已挂) ↗
正文记录 5 月 28 日面试,页面显示 06-10 编辑;未明确年份美团 · Agent开发(Keeta 智能客服) · 原帖未明确批次
介绍项目中使用的 Mem0 记忆系统。(题意整理)
美团Keeta Agent开发(智能客服方向)一面面经 ↗
页面显示 04-28 发布,未明确年份