
AI 编程助手如何检索代码上下文?代码库索引和 Grep 搜索有什么区别?
下面是一段模拟面试追问。
🧑💻 面试官:用户只说“登录后偶尔跳回登录页”,AI 编程助手怎么找到要看的代码?
🙋♂️ 我:先把代码库向量化,然后做语义检索。
🧑💻 面试官:如果用户已经给出了函数名,为什么还要做语义检索?
🙋♂️ 我:这种情况可以直接搜索函数名。
🧑💻 面试官:搜索命中了一个登录函数,就能开始改了吗?它的调用方和测试要不要看?如果索引里的代码还是旧分支呢?
找到相似代码,只是拿到了线索。能不能据此修改,还要看当前文件、调用关系和验证结果。
面试速答(60 秒版)
AI 编程助手检索代码上下文,通常需要结合具体问题选择搜索方式。
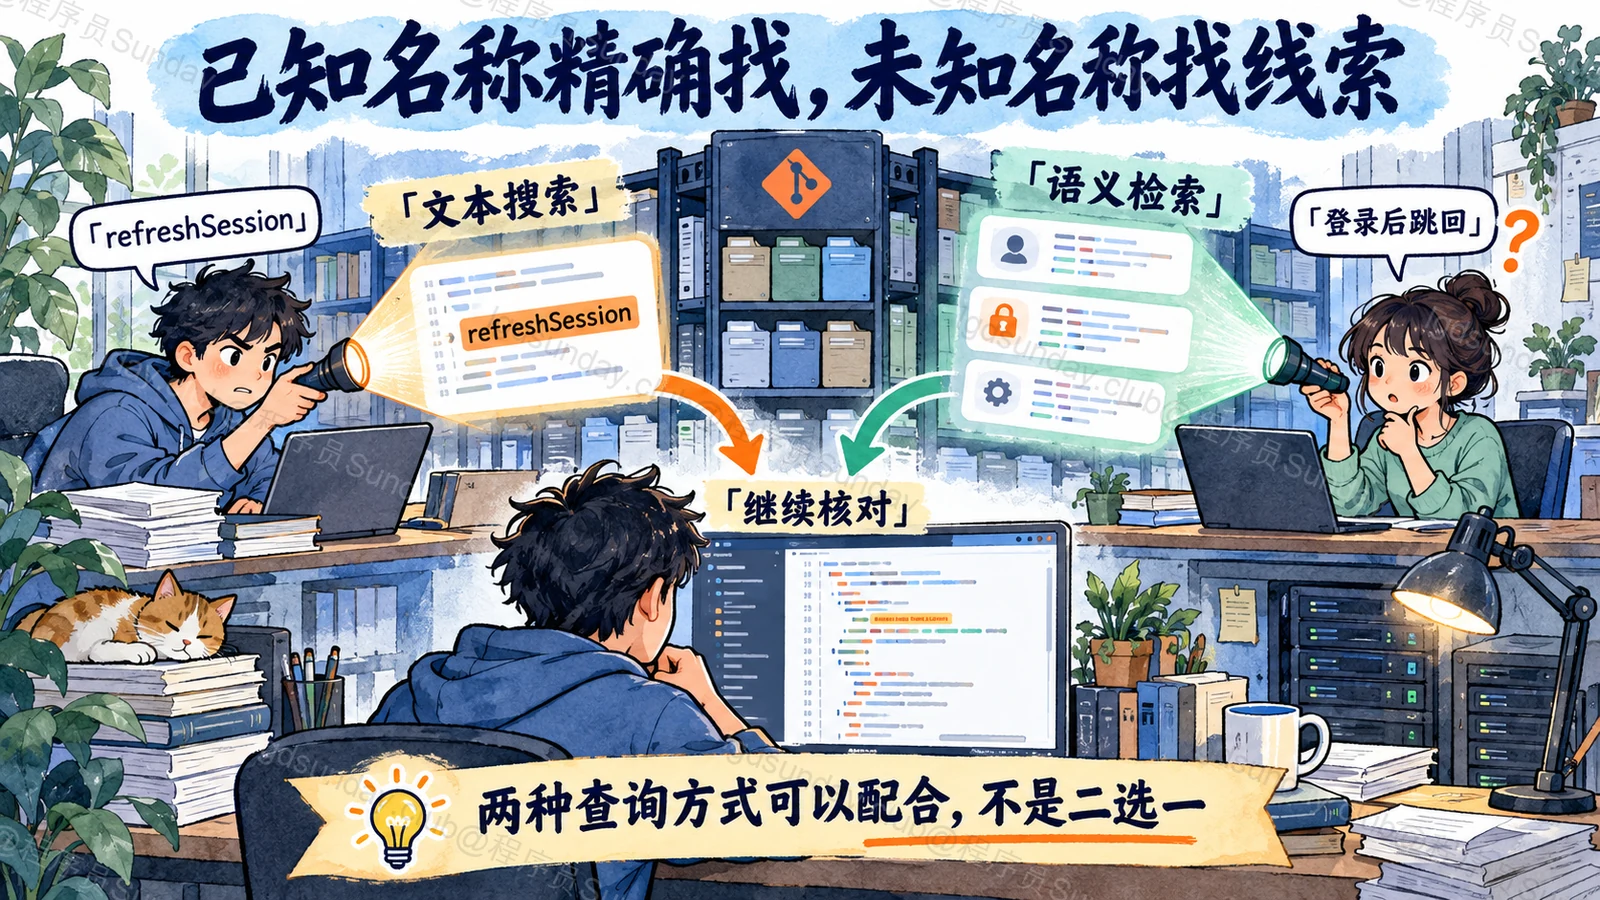
如果已经知道函数名、错误信息或配置字段,可以先用 Grep 一类文本搜索,直接定位这些内容。如果只知道功能描述,不清楚对应的名称,语义检索可以帮助找到候选代码。
不过,“代码库索引”并不等于“向量数据库”。索引也可以记录符号、引用和文本;语义检索只是其中一种方式。
拿到候选以后,还要读取当前版本的文件,继续检查调用方、配置与测试。最终交给模型的内容,应足以解释问题,也要控制范围,不能把整个仓库都塞进去。
所以,选型时不要只比较“有没有向量化”,还要看定位是否准确、索引是否及时更新,以及模型拿到证据以后能不能完成修改。
知识点详解:从一句报错描述,走到可以修改的代码
已知名称和未知名称,需要不同的找法
假设用户说:“登录后偶尔跳回登录页,帮我排查一下。”
我们暂时不知道问题在登录请求、Token 保存,还是路由守卫。直接搜索“登录后偶尔跳回登录页”,不一定能在代码中找到原话。
这时,语义检索可以根据功能描述,提供认证、会话和路由相关的候选。模型先读这些代码,再缩小范围。
但如果日志已经给出了 refreshSession,或错误明确提到 TOKEN_EXPIRED,搜索这些精确名称往往更直接。先做一轮语义检索,反而可能多绕一步。
Cursor 在 2025 年的工程文章中介绍过语义检索与 Grep 配合的做法。这可以帮助理解两种工具怎样互补,但不能据此认定所有编程助手、所有后续版本都使用同一套实现。工程说明。
代码库索引,不只有向量这一种形式
索引的作用,是提前整理信息,让后续查询更方便。至于整理什么,要看我们想回答什么问题。
| 想找什么 | 可以使用的方式 | 仍然需要注意什么 |
|---|---|---|
| 一个错误字符串在哪里出现 | 文本搜索或文本索引 | 同名内容可能分布在多个文件 |
| 某个方法定义在哪里、谁引用它 | 符号与引用索引 | 动态调用、生成代码可能不完整 |
| “自动刷新登录状态”可能在哪里实现 | 语义检索 | 意思相近不代表就是当前故障位置 |
这几种方式可以组合使用。比如语义检索先找出会话模块,再用名称搜索找调用方,最后读取相关测试。
因此,面试官问“代码库索引和 Grep 有什么区别”时,也要先说明索引的类型。不能把所有索引都当成向量检索,再得出“索引懂语义,Grep 不懂语义”的结论。
命中一个函数,为什么还不够?
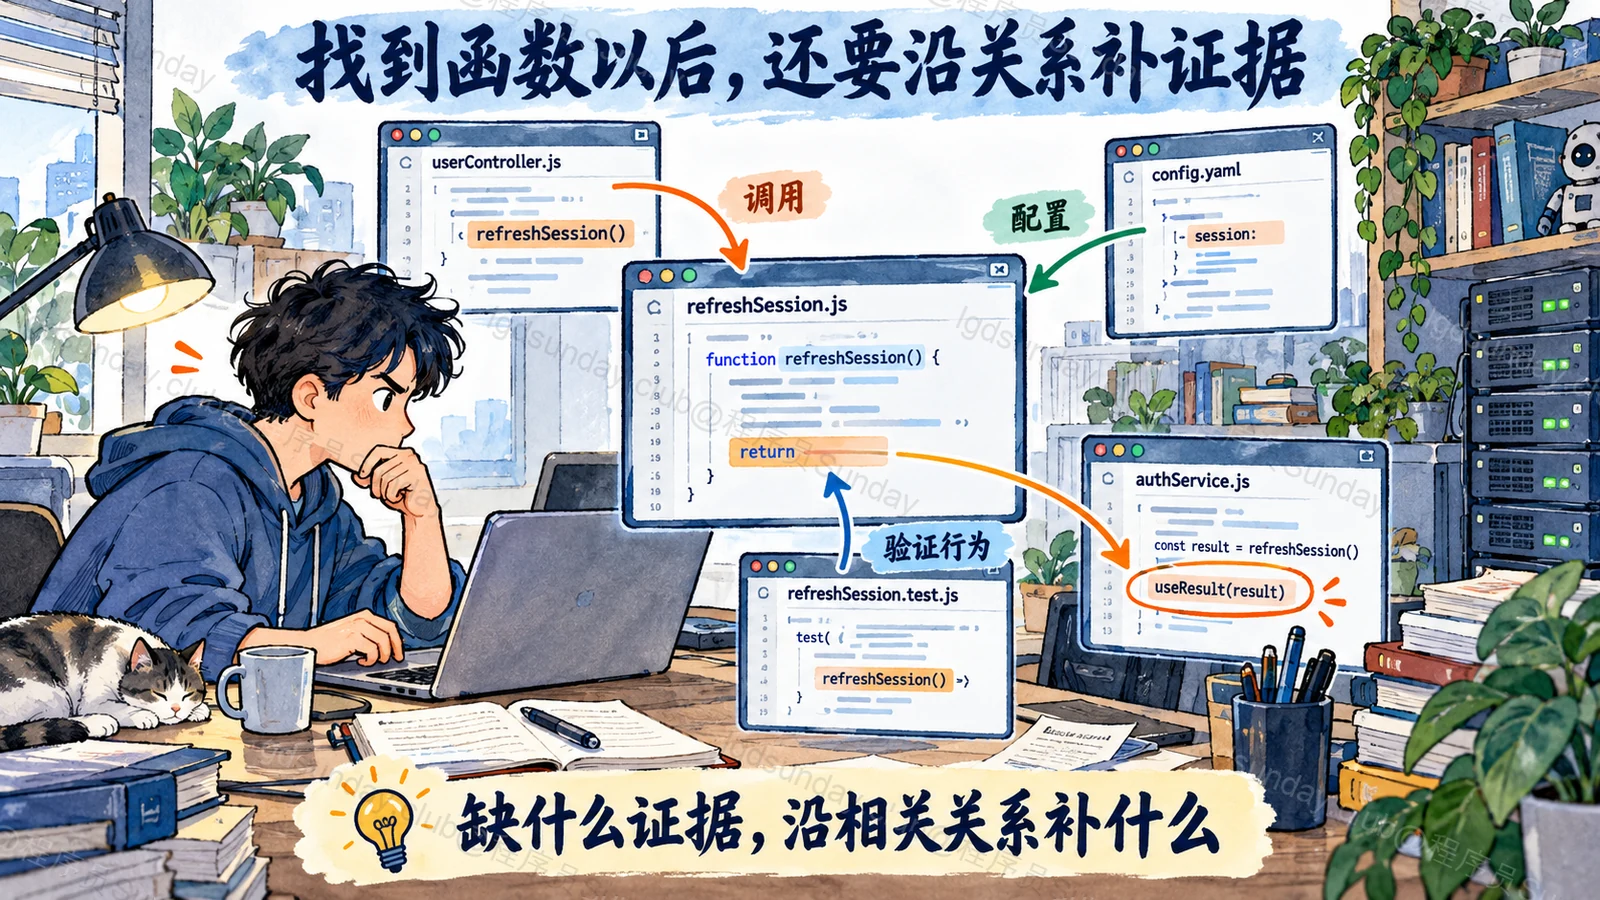
假设模型找到了 refreshSession。它看到函数返回失败,就想把失败分支改成重新登录。
但是,调用方可能已经有重试逻辑;路由守卫可能在刷新结束之前就读取了旧状态。真正的问题不一定在这个函数内部。
我们还需要继续看:谁调用它,返回值怎样被使用,异步状态怎样变化,以及测试对这些行为有什么要求。
这里没有一套固定的“每次都读五个文件”的流程。缺什么证据,就沿着相关关系补什么。证据已经足够,也不需要把整个依赖树展开。
索引负责提供线索,当前工作区负责确认内容
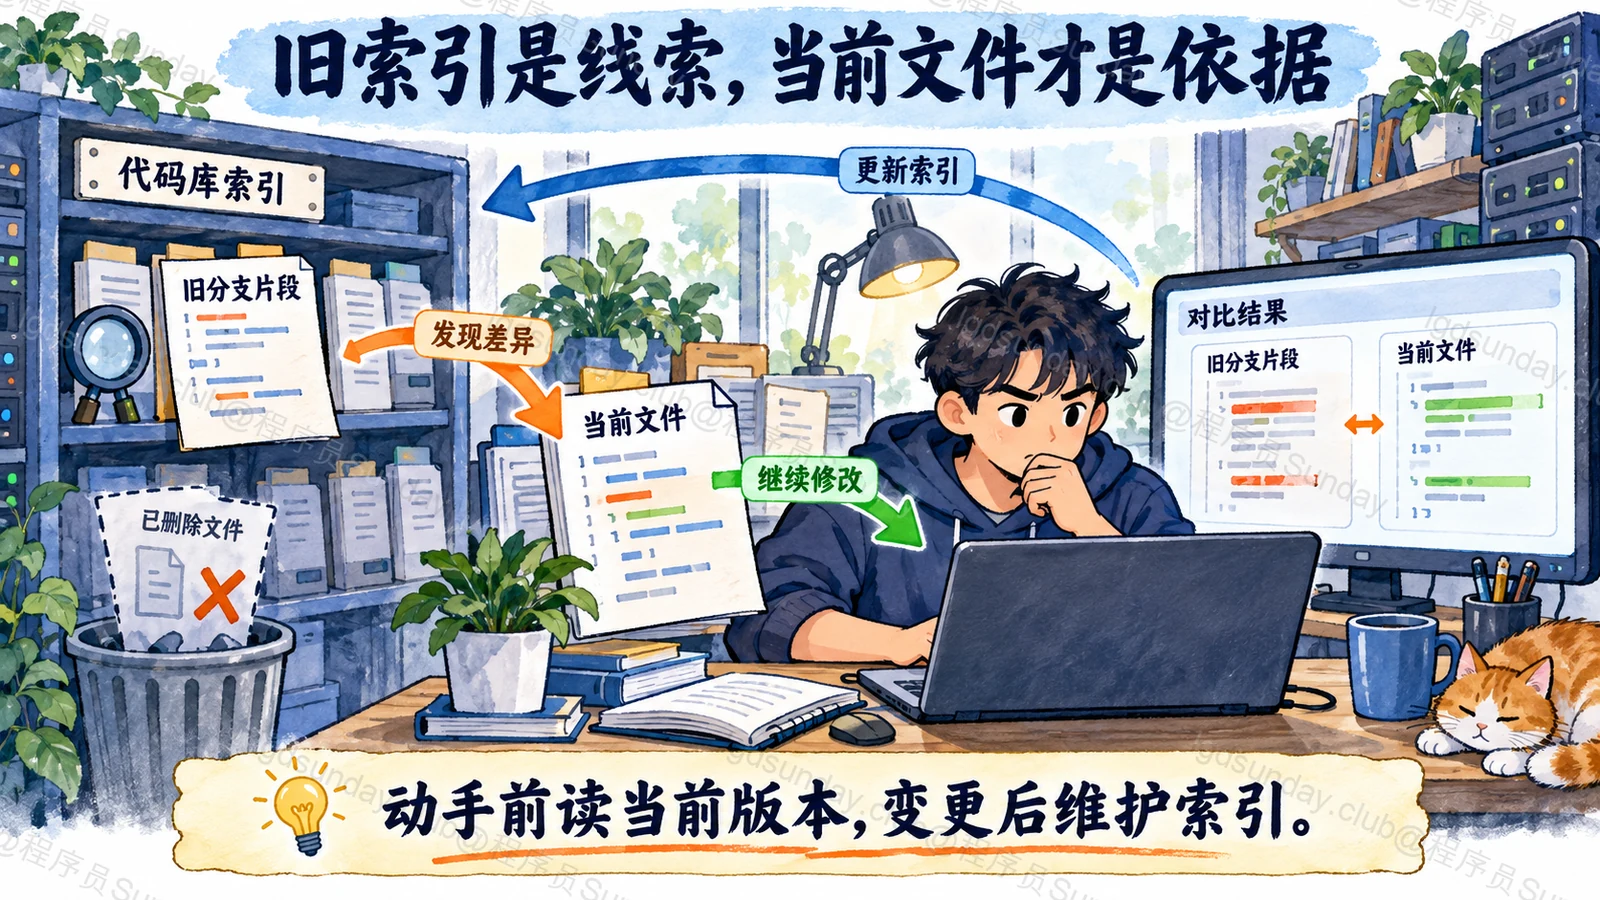
假设索引建立在主分支上,但用户已经在本地修改了路由守卫。
如果模型直接按索引里的旧片段生成修改,可能会覆盖当前改动,或者针对一个已经不存在的问题动手。
一种做法是:检索结果保留文件位置与版本信息;修改前重新读取工作区;文件发生变化时更新索引或改用当前文件搜索。删除文件也需要从索引中清理,不能继续被当作有效候选。
Cursor 的 2026 年代码索引文章介绍了利用文件变化检测与增量同步维护索引的设计。这里引用的是那个时间点的工程方案,不是对当前产品行为的保证。索引工程说明。
权限同样不能留给相似度处理。不属于当前用户、仓库或可访问范围的代码,应该在检索阶段就被排除。
面试官继续追问
仓库不大,还需要建立语义索引吗?
不一定。文本搜索、文件目录与语言服务如果已经能稳定定位问题,就可以先用这些。
是否引入语义索引,可以用固定任务比较定位时间、修改成功率、维护开销与敏感代码处理要求。不要只因为功能描述用了自然语言,就认为必须向量化。
上下文窗口很大,直接放整个仓库不行吗?
大窗口能容纳更多内容,但不代表所有文件都相关。
无关代码会增加成本,也会让旧实现、测试夹具与实际实现混在一起。仍然应该先定位,再补充必要的调用关系与约束。
怎么判断是检索失败,还是模型改错了?
先看正确文件和关键证据有没有进入模型的实际输入。
如果没进去,排查定位、过滤和内容截取。如果证据完整,再看模型是否理解了调用关系、是否误改,以及测试为什么没有发现问题。
面试速记卡
- 精确搜索:名称、错误信息已知时,先找明确线索。
- 语义检索:功能已知、名称未知时,帮助寻找候选。
- 代码索引:可以是文本、符号、引用或向量,不是向量数据库的同义词。
- 修改依据:读当前文件,再补调用关系、配置与测试。
- 验证重点:定位准确、版本一致、权限正确,最后用测试检查修改。
公司面试真题
真题根据求职者公开面经整理,题意经过概括,非逐字原话或公司官方题库;本文为 Sunday 的独立解析。
数字马力 · 开发(含 AI 工程与 AI 编程) · 校企合作(原帖标题)
Claude Code 使用 grep 检索代码,与 RAG 的检索方式有什么区别?(题意整理)
数字马力校企合作面经 ↗
页面显示 06-14 发布,未明确年份