
MemGPT 是什么?为什么要让 Agent 主动管理分层记忆?
下面是一段模拟面试追问。
🧑💻 面试官:一次对话越来越长,MemGPT 是怎么处理的?
🙋♂️ 我:把旧消息放到外部存储,需要的时候再拿回来。
🧑💻 面试官:那外部存储里有几万条消息,每次都拿回来吗?
🙋♂️ 我:只取当前需要的。
🧑💻 面试官:谁判断需要什么?模型取回了错误片段,或者一直查下去,又由谁控制?
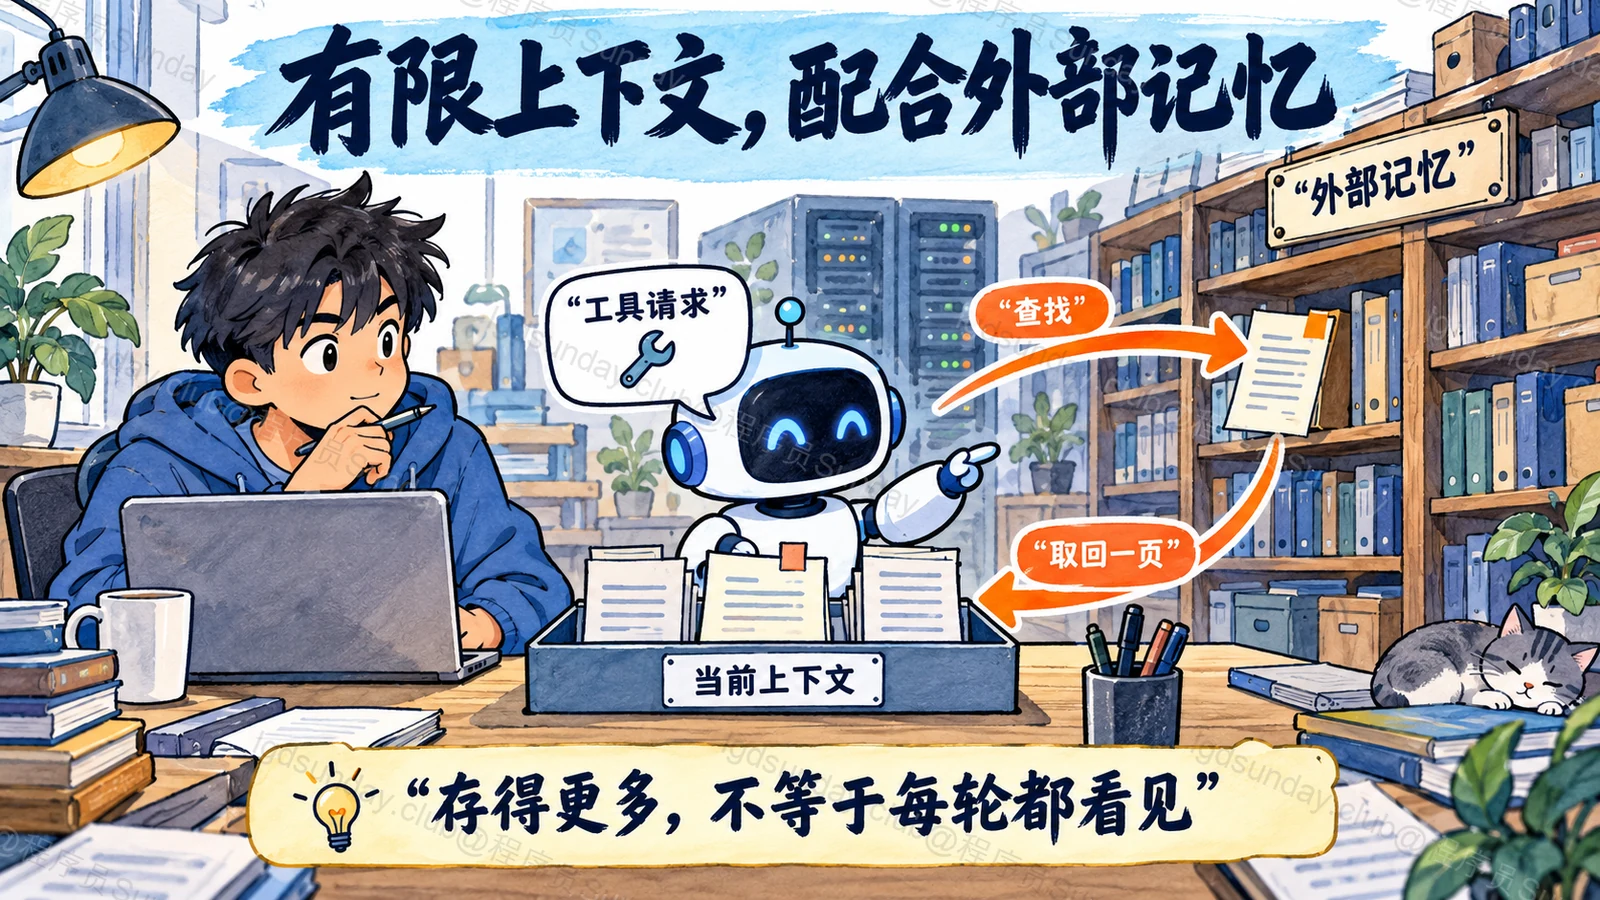
分层记忆解决的不是「存得无限多」,而是「有限的当前上下文,怎样持续使用外部信息」。
面试速答(60 秒版)
MemGPT 是一种让大模型参与管理分层记忆的设计。它把当前能直接看到的上下文,与外部保存的信息区分开,再通过工具让模型读写部分记忆。
模型不需要每轮看到全部历史。它可以保留当前任务需要的信息,在缺少背景时检索外部记录,再把结果带入后续判断。
不过,这并没有让模型的上下文窗口变成无限,也没有把历史内容写进模型参数。外部信息仍然需要被取回,进入当前输入,模型才能使用。
实际实现时,还要限制哪些内容可写、每次读取多少,以及最多执行多少轮。分层提供的是组织信息的办法,不保证模型一定记得正确,也不代替权限与运行控制。
知识点详解:存下来的内容,怎样重新被模型用到?
先区分“模型现在看到什么”和“系统已经存了什么”
假设一个学习助手,已经陪用户完成了许多次练习。系统保存了历史对话,但这次模型输入里只放了当前问题和近期消息。
那么用户三周前提到的错误,并不会因为数据库里有记录,就自动出现在模型眼前。
如果当前问题需要那段经历,系统要先找到记录,再把必要内容放进本轮上下文。这里的“记忆”不是模型凭空回忆,而是应用把已保存的信息重新交给它。
MemGPT 的原始论文借用了操作系统分层管理存储的思路:当前上下文容量有限,外部存储保存更多信息,模型通过特定操作在两者之间转移内容。MemGPT 论文。
两层信息,承担不同的任务
我们可以先用一个简化的教学划分理解它:
| 位置 | 可以放什么 | 模型怎样使用 |
|---|---|---|
| 当前上下文 | 当前目标、近期交互、正在使用的资料 | 本轮直接读取 |
| 外部存储 | 历史消息、归档资料与较长期的信息 | 先检索,再放入上下文 |
这个表不是原论文所有区域的完整定义。论文还区分了指令、可编辑工作信息、消息队列,以及不同类型的外部存储。
尤其需要注意,可编辑记忆不等于所有输入都能被模型随意修改。论文中的系统指令有自己的保护范围;工程实现也应明确哪些区域只读,哪些操作可以由模型提出。
模型怎样“主动”管理记忆?
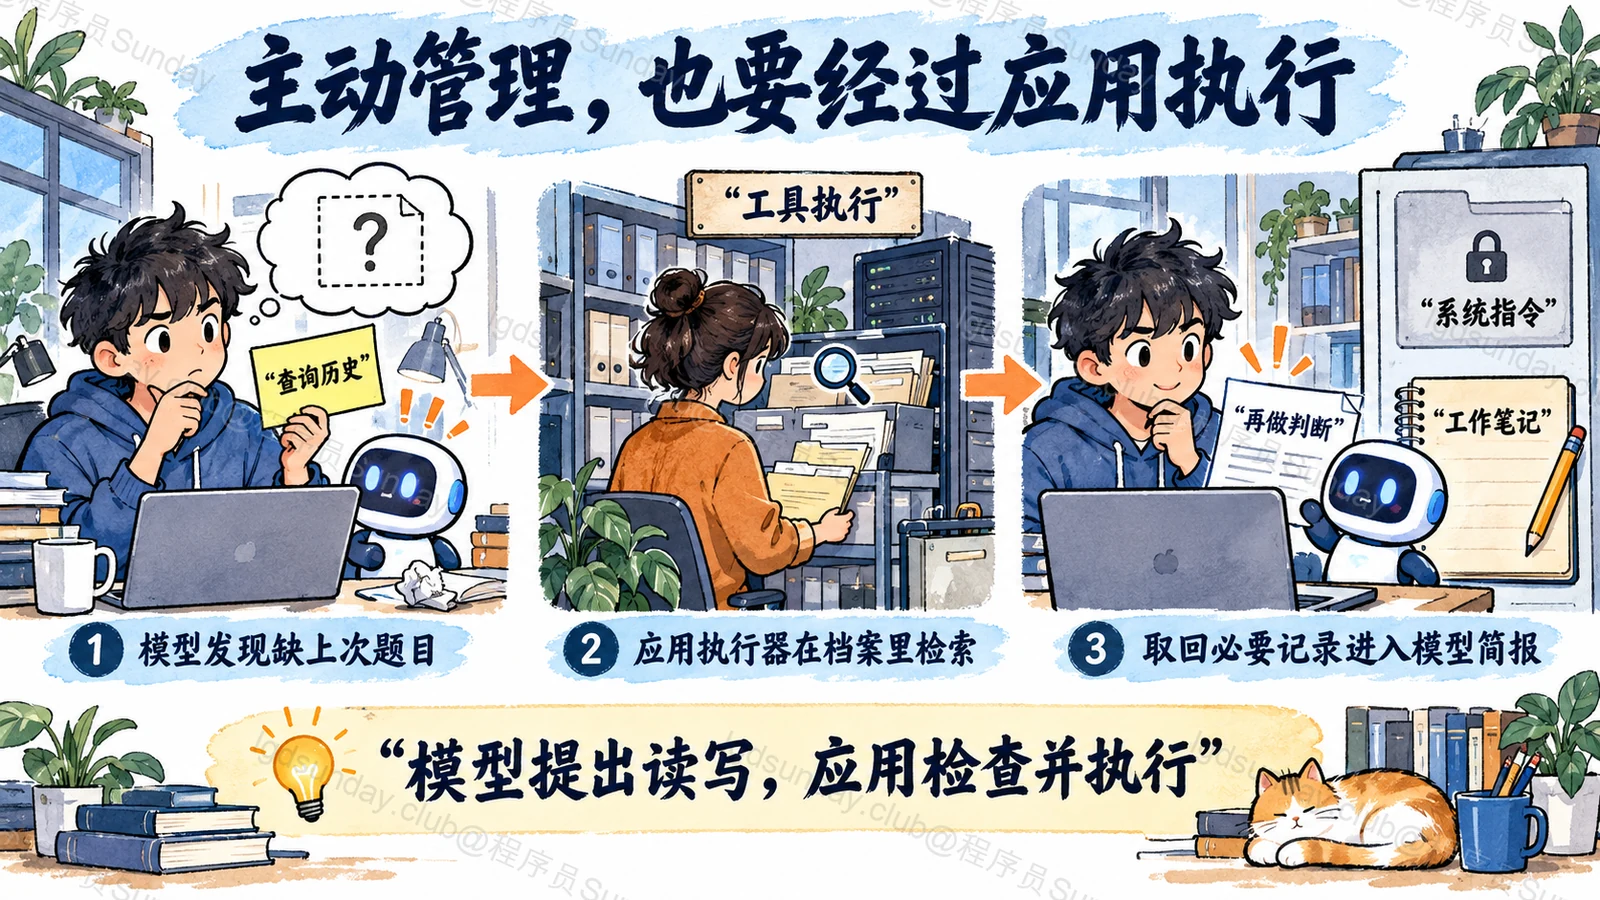
继续假设用户说:“这道题跟我上次不会的那道很像,你换个讲法。”
模型当前看不到上次的题目,就可以提出查询历史的工具请求。运行器执行查询,把候选记录返回给模型。
模型读完以后,可能已经能确定是哪道题,也可能发现结果太多,需要进一步缩小范围。必要内容进入上下文后,它才继续讲解。
模型也可以提出保存信息的请求,例如把经过确认的学习偏好留在允许写入的区域。但最终写入什么、有没有越权,仍然由应用检查和执行。
所以,“主动”说的是模型参与决定读什么、写什么,不是它绕过程序直接操作数据库。
当前上下文满了,怎么办?
如果近期消息不断增加,就需要腾出空间。可以保留当前目标与必要约束,对已经结束的部分做摘要,把原始记录放在外部。
但是摘要不能代替所有原文。用户问“我当时具体说了什么”,可能仍要回查原始消息。如果压缩时丢掉了重要条件,外部存储里有完整记录,也不代表模型一定会主动去找。
因此,至少要检查两件事:哪些内容不能在整理时丢失;遇到什么情况应该返回原始记录核实。
不要把“有外部记忆”理解成对摘要损失的自动补救。
分层以后,为什么还需要运行限制?
模型可能反复检索相似记录,也可能把不相关的片段不断放回上下文。
运行器需要限制调用轮数、读取大小与总预算。结果不足时,可以让模型向用户确认,或者明确说明没有找到可靠记录,而不是无限查询。
写入也应该保留来源和适用范围。否则,一次误解被长期保存,后续会话又不断读到,问题就会持续存在。
本题讲的是原始 MemGPT 的记忆管理思路,不把后续框架的 API 或功能直接当成原论文定义。
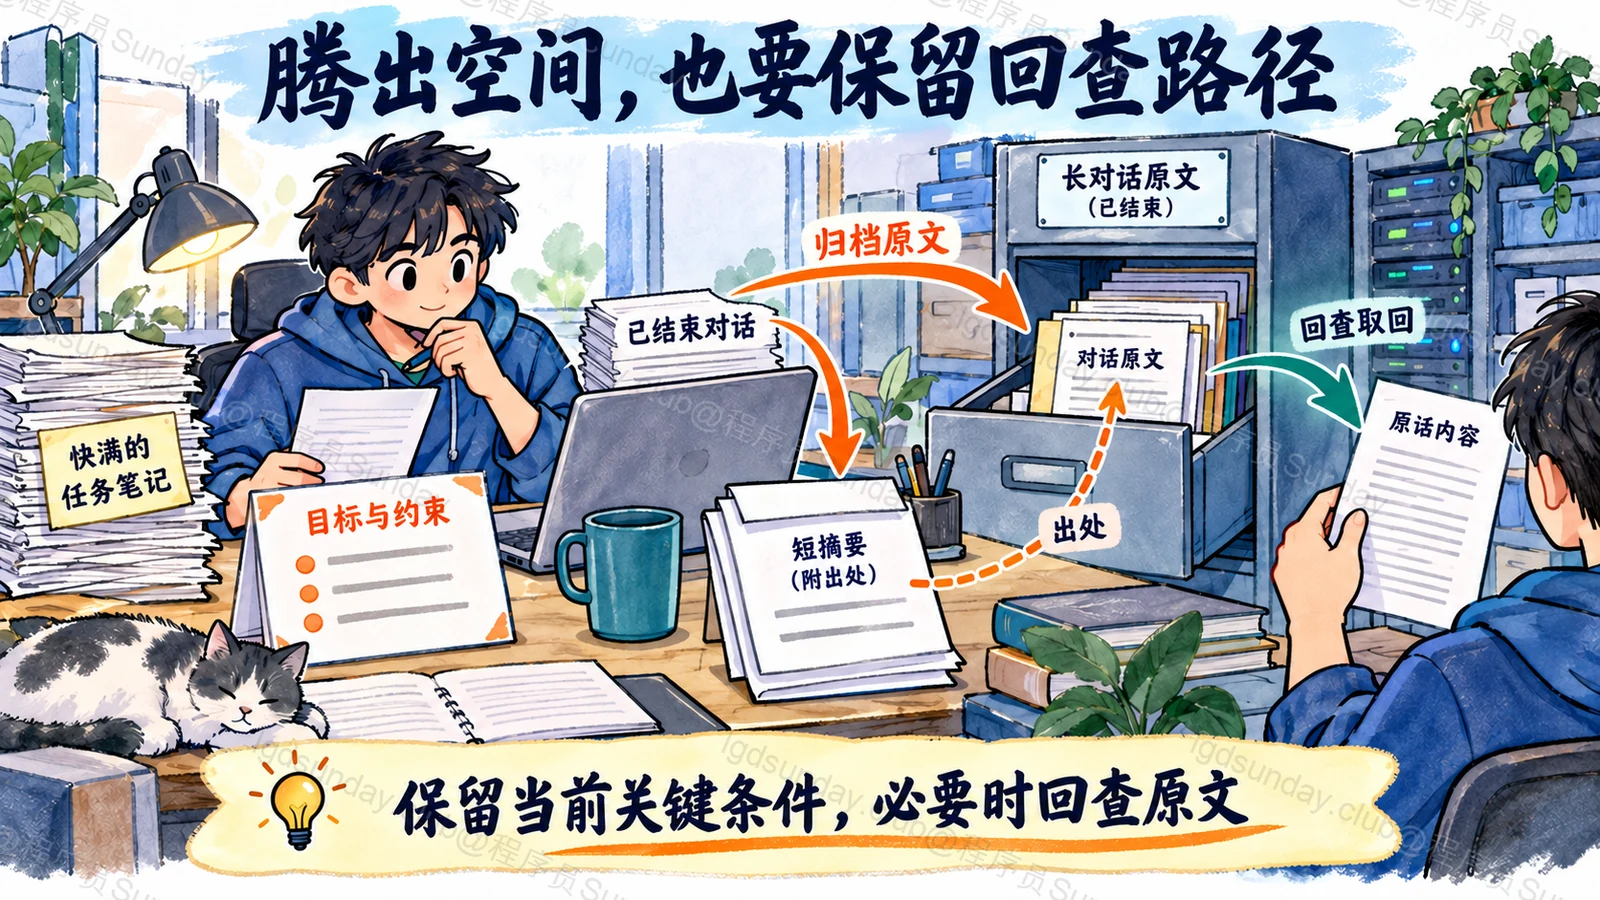
目标与约束仍留在当前任务中,摘要整理的是已结束历史;需要原话时回查归档。
面试官继续追问
MemGPT 和普通 RAG 是二选一吗?
不是。RAG 描述检索信息后辅助生成的过程,MemGPT 讨论分层信息怎样被管理。
外部记忆读取可以使用检索;区别需要落到具体实现,看谁触发读取、怎样更新当前信息,以及有哪些管理操作。
让模型自己决定保存什么,会不会存错?
会。模型提出的写入内容只是候选,不应直接当成经过确认的事实。
可以针对不同内容设置检查与确认要求,并保存来源。涉及长期约束或高风险动作时,不能让一条自动生成的记忆改变系统权限。
怎样验证分层设计确实有用?
准备跨会话任务,分别检查是否取回了必要历史、是否正确使用,以及读写开销。
还要加入“历史不存在”“摘要丢条件”“检索多次仍无结果”的情况,看看系统能否停止、澄清或承认不知道。
面试速记卡
- 分层对象:当前可见上下文与外部保存的信息。
- 使用过程:外部内容要先被取回,才能进入模型当前判断。
- 主动管理:模型提出读写请求,应用负责执行与边界检查。
- 能力边界:没有无限窗口,也没有自动修改模型参数。
- 工程控制:保留必要约束,限制读写与轮数,验证取回和使用是否正确。
公司面试真题
这道题暂未收录可核验的公司真题来源。你可以先阅读本文解析,或浏览已收录的公司面试真题。
浏览公司面试真题 →