
Embedding 模型如何训练?正负样本和对比学习分别有什么作用?
以下对话为教学模拟,不是真实面经。
🧑💻 面试官:Embedding 模型为什么能把意思相近的句子放得比较近?
🙋♂️ 我:训练时让相似句子的向量接近,不相似的远离。
🧑💻 面试官:两个句子都说“退款”,一个问到账时间,另一个问怎么申请,算不算正样本?
🙋♂️ 我:要看检索任务需要什么结果。
🧑💻 面试官:如果把其实相关的文档当负样本,会发生什么?
向量空间学到什么,取决于训练样本怎样定义“相关”,不只是句子有没有相同词语。
面试速答(60 秒版)
Embedding 模型把文本编码成向量。训练时,我们会根据任务准备正负样本,让查询与相关内容更容易匹配,让查询与不相关内容更容易区分。
例如知识库检索,用户问“退款多久到”,解释到账时间的文档可以是正样本;只介绍申请入口的文档未必是正样本,即使两者都包含“退款”。
对比学习通过比较这些候选的相对得分来更新模型。批内负样本可以增加训练效率,难负样本可以帮助模型分清容易混淆的内容,但错误的负样本也会损害效果。
因此,我会先检查样本定义和质量,再用独立检索数据评测。训练损失下降,不代表真实问题已经检索得更好。
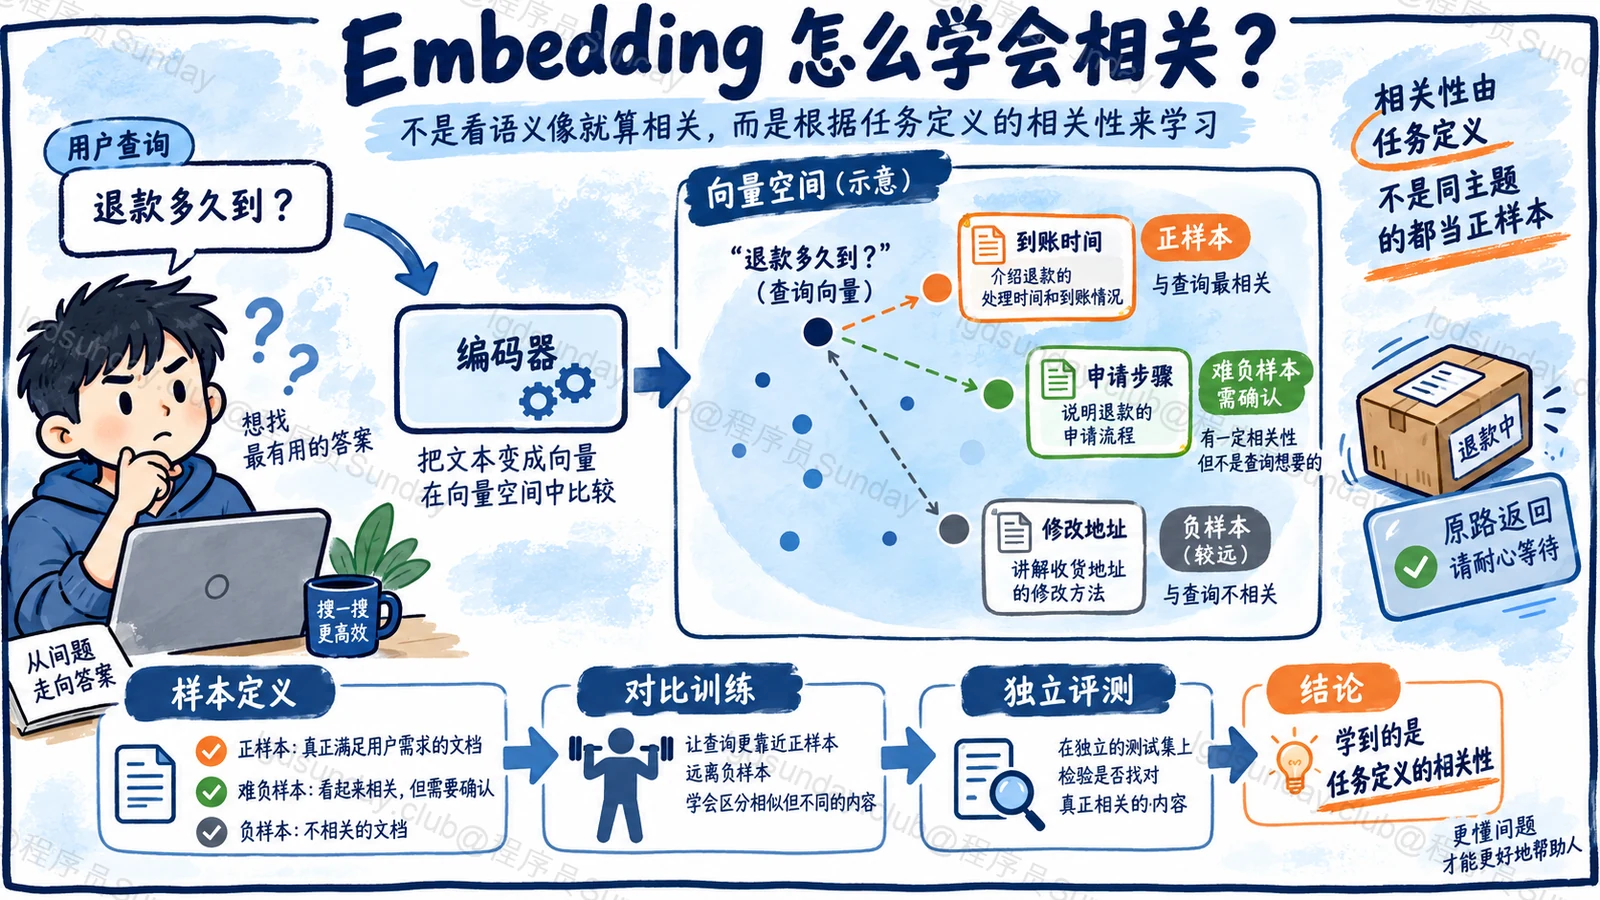
知识点详解:正负样本怎样改变向量之间的关系
检索训练,先定义“什么应该被找出来”
咱们假设知识库里有三段内容:A 解释退款到账时间,B 介绍退款申请步骤,C 介绍修改收货地址。
对于“退款多久到”这个查询,A 是明确相关的内容,C 通常不相关。B 与查询共享主题,却未必能够回答问题。
这就是训练样本需要表达的区别。所谓正样本,不是“长得像查询的文本”,而是按任务标准应该排在前面的内容。如果产品希望召回退款流程全貌,B 的标签又可能改变。因此,标签必须和检索目标一致。
Sentence Transformers 的训练概览列出了不同训练数据形式。句子相似度、查询与文档配对、三元组等数据,不能不看目标就混在一起。
对比学习比较的是候选之间的得分
模型先把查询和文档编码成向量,再计算匹配得分。训练损失会鼓励相关文档相对不相关文档获得更高得分。
可以把它理解成一次排序练习:对这个查询,A 应当比 B、C 更容易被选中。模型通过反向传播调整参数,使以后遇到类似问题时,也能分清这些内容。
这里说“正样本拉近、负样本推远”方便理解,但不能当成所有损失函数都直接最小化欧氏距离。实际训练可能使用余弦相似度、点积和温度等设置,应看具体损失的定义。官方损失函数说明给出了这些实现的输入与约束。
批内负样本省工作,也带来误标风险
假设一批数据有三个查询,以及各自的正确文档。训练时,可以把其他查询的文档作为当前查询的候选负样本,这样一次编码就能产生更多比较。
但是,其他查询的正确文档不一定与当前查询无关。例如同一批里有“退款多久到”和“退款为什么还没到”,两份文档都可能相关。直接把其中一份当成负样本,就会鼓励模型区分本来应该同时召回的内容。
因此,要检查重复内容、近似问题和一对多相关关系。批量越大,不代表标签越正确;需要结合所选损失的要求组织批次。
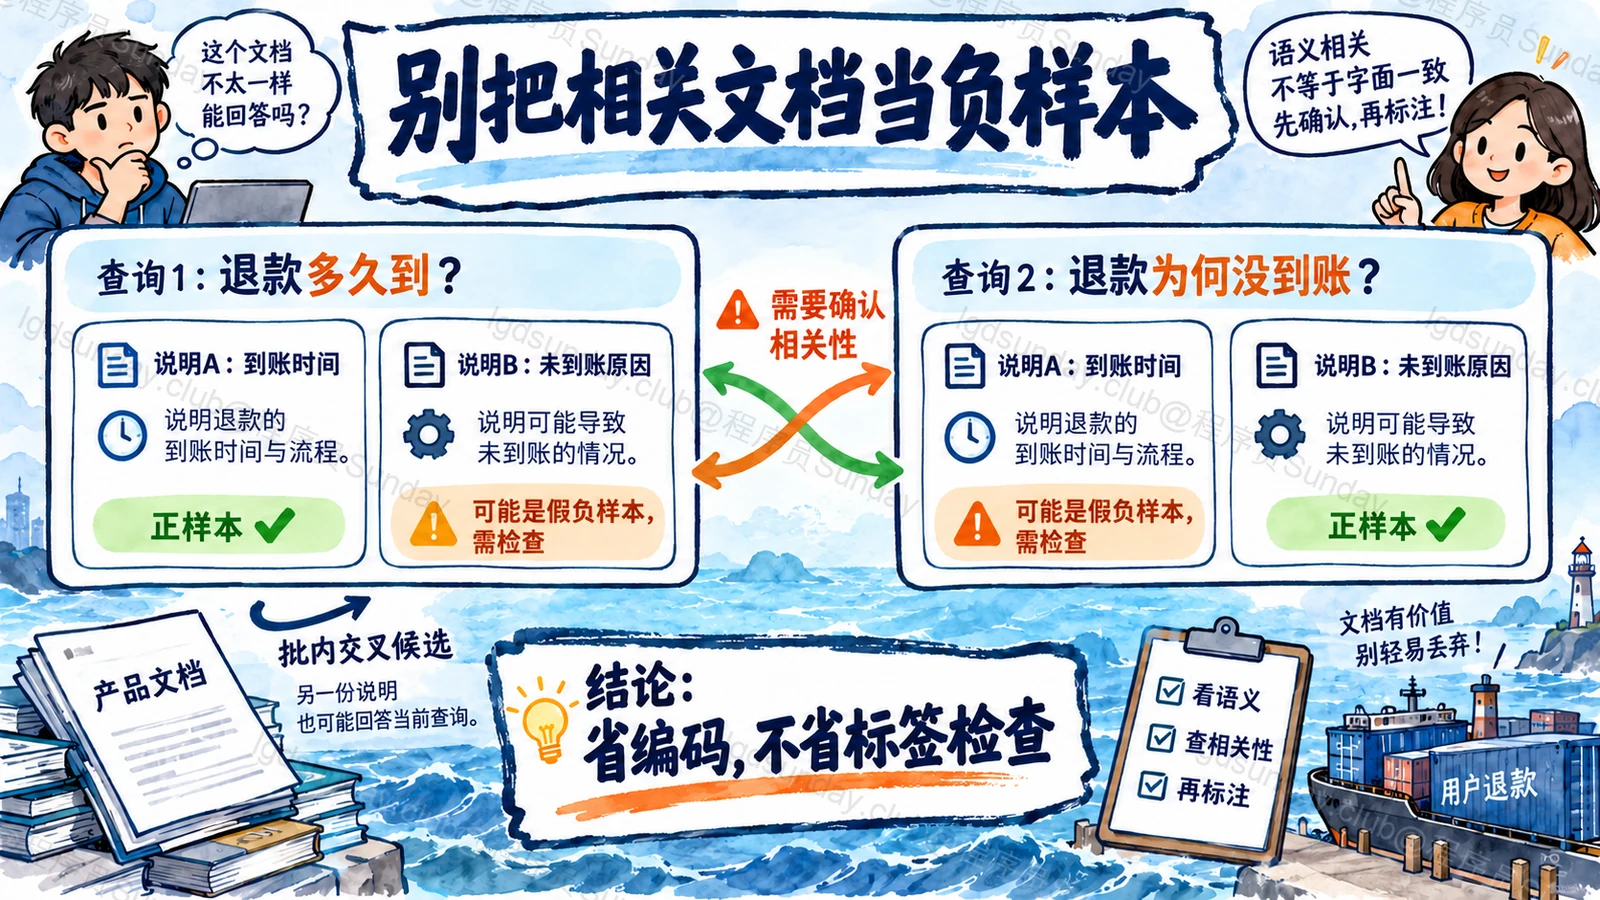
难负样本要“容易混淆,但确实不相关”
前面的退款申请文档 B,可以成为一个候选难负样本,因为它和查询共享大量词语,模型可能误召回。
但难负样本不是“当前模型没排第一的文档”。它首先必须经过相关性判断。如果内容真的能够回答用户问题,只因为排名不同就把它标为负样本,会破坏训练目标。
可以从当前检索结果中收集容易混淆的候选,再通过人工规则或经过验证的标注流程筛选。训练集与评测集也要按来源和近似文本去重,避免同一段制度文件改个措辞就同时出现在两边。
怎样知道训练有用
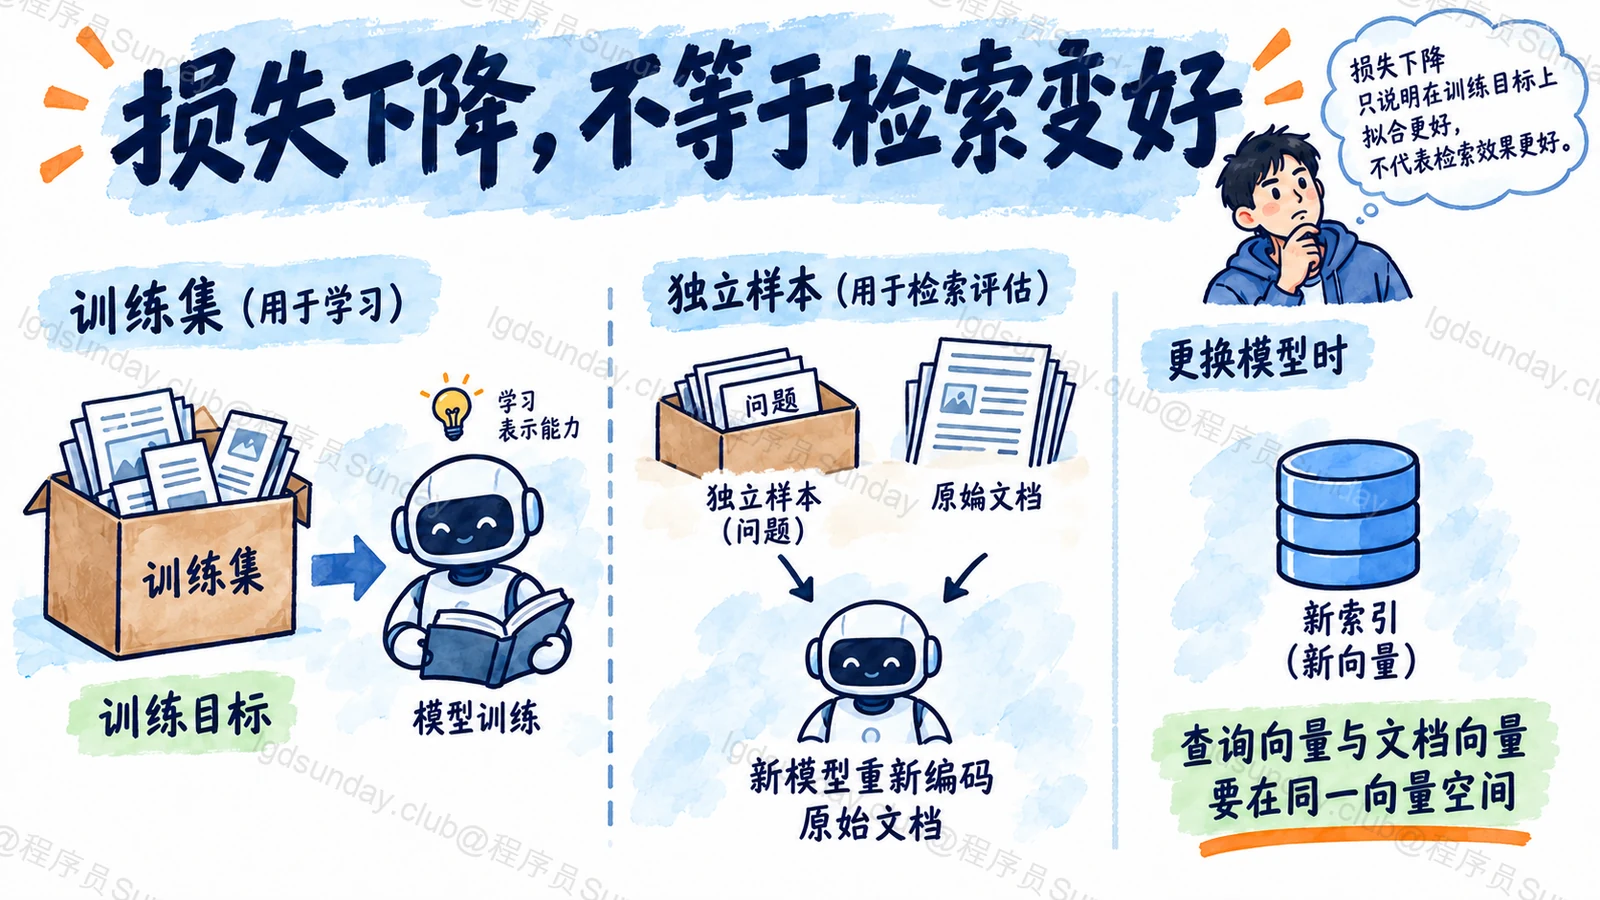
训练损失只能说明模型更符合当前训练目标。真实检索还要看独立问题能否找到正确内容,以及正确内容的排名是否改善。
可以记录 Recall@K、MRR 或 nDCG,但要先明确相关文档标注和 K 的意义。同时检查新增困难样本有没有带来退化,例如只改善退款主题,却让其他领域检索变差。
索引端和查询端也应使用兼容的编码方式。更换模型后,旧文档向量通常不能直接与新查询向量混用;应重新编码并验证。否则,训练本身有效,线上检索却可能因为向量空间不一致而变差。
面试官继续追问
负样本越多,效果越好吗?
不一定。错误负样本、重复数据和领域不匹配会影响训练。数量增加之前,先检查相关性定义和样本质量。
查询和文档必须用同一个输入格式吗?
不一定。某些模型为查询、文档要求不同前缀或编码方式。应遵循所用模型说明,并保持训练、评测和上线一致。
Embedding 训练以后还需要重排吗?
可以需要。双塔向量检索适合快速筛选,重排模型可对少量候选做更细的判断。是否使用重排,仍要看质量改善和延迟成本。
面试速记卡
- 正样本:按任务标准应该被找到的内容。
- 负样本:与当前查询不相关的候选,不等于其他所有文档。
- 对比学习:优化相关内容相对候选的匹配得分。
- 难负样本:容易混淆,但必须确认确实不相关。
- 验收标准:独立检索评测,而不是只看训练损失。
公司面试真题
这道题暂未收录可核验的公司真题来源。你可以先阅读本文解析,或浏览已收录的公司面试真题。
浏览公司面试真题 →