
推理模型和普通大模型有什么区别?Agent 一定要用推理模型吗?
以下对话为教学模拟,不是真实面经。
🧑💻 面试官:Agent 是不是都应该用推理模型?
🙋♂️ 我:推理模型想得更多,应该更容易完成复杂任务。
🧑💻 面试官:如果任务只是提取订单号,还需要等它长时间推理吗?如果工具返回了错误信息,想得更久就一定能纠正吗?
先看任务是否需要额外推理,再看它带来的收益能否覆盖等待和成本。
面试速答(60 秒版)
推理模型通常通过专门训练和推理阶段的计算,让模型在回答前进行更多问题求解。它与普通大模型的区别,不是有没有推理能力,也不是回答里有没有很长的思考文字。
对于多约束规划、复杂代码排查等任务,额外推理可能提高完成质量。但简单分类、字段提取和明确规则的工具选择,不一定需要这种计算投入。
如果是给 Agent 选模型,我会在相同工具和任务样本下,比较最终完成率、工具选择错误、延迟和成本。也会检查模型使用工具的能力,而不只看通用榜单。
推理模型可以负责难决策,普通模型处理简单步骤。是否混用,需要证明实际收益,不能默认越会思考就越适合所有环节。
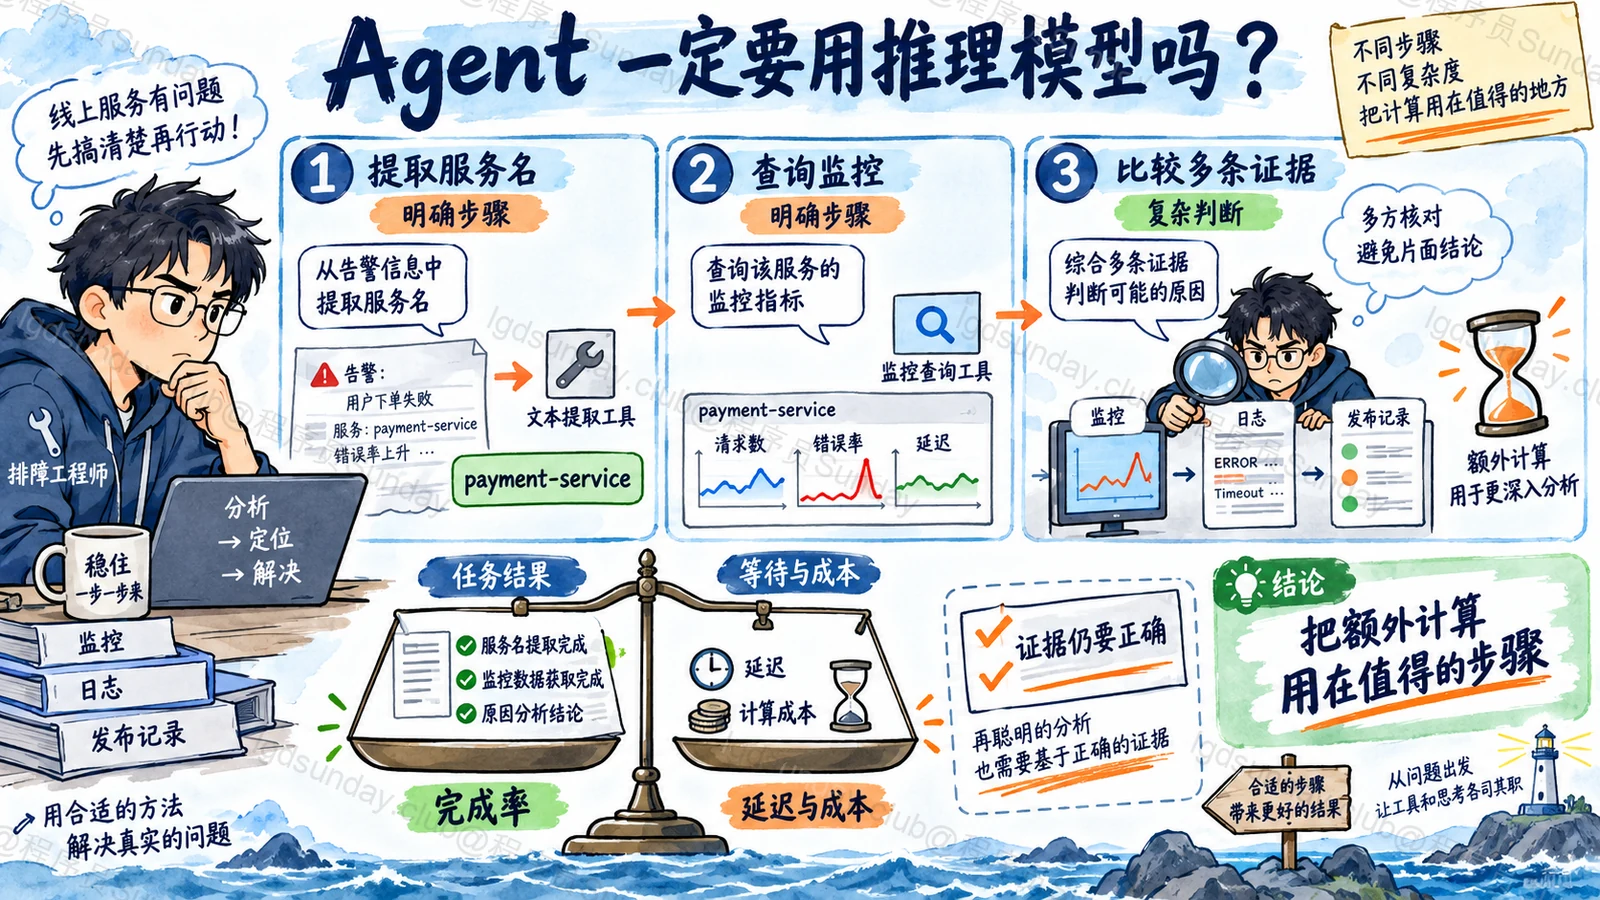
知识点详解:推理能力,和 Agent 的任务结果之间还有几层
“普通模型不推理”这个说法不准确
普通大模型也可以完成推理任务。所谓推理模型,通常是在训练与使用方式上,更强调多步问题求解,并允许在推理阶段投入更多计算。
DeepSeek-R1 论文提供了强化学习与推理能力训练的具体研究实例;不同供应商的推理实现、预算接口和输出方式并不完全相同。因此,这里讨论的是能力和计算方式,不把所有产品当成同一种架构。
也不能通过“思考过程很长”判断模型是否可靠。输出一段推理解释,与实际执行更多计算不是同一件事;用户能够看到的文字也不一定是模型完整的内部过程。
同一个 Agent,不同步骤需要的能力不同
咱们假设做一个排查接口变慢的助手。它可能需要完成三类动作:
第一类是整理用户输入,例如提取服务名称和时间范围。输入清楚时,这通常是一个比较明确的任务。
第二类是查监控、查日志。关键在于工具参数和调用权限,模型并不需要自己计算监控数据。
第三类才是根据多个证据判断原因。例如延迟上升、慢 SQL 增多、发布记录变化同时出现,需要排除其他解释,并决定下一步查什么。
第三类更值得评估额外推理。前两类是否需要推理模型,要看实际错误和执行成本。不能因为整个产品叫 Agent,就让每一次字段提取都使用最高预算。
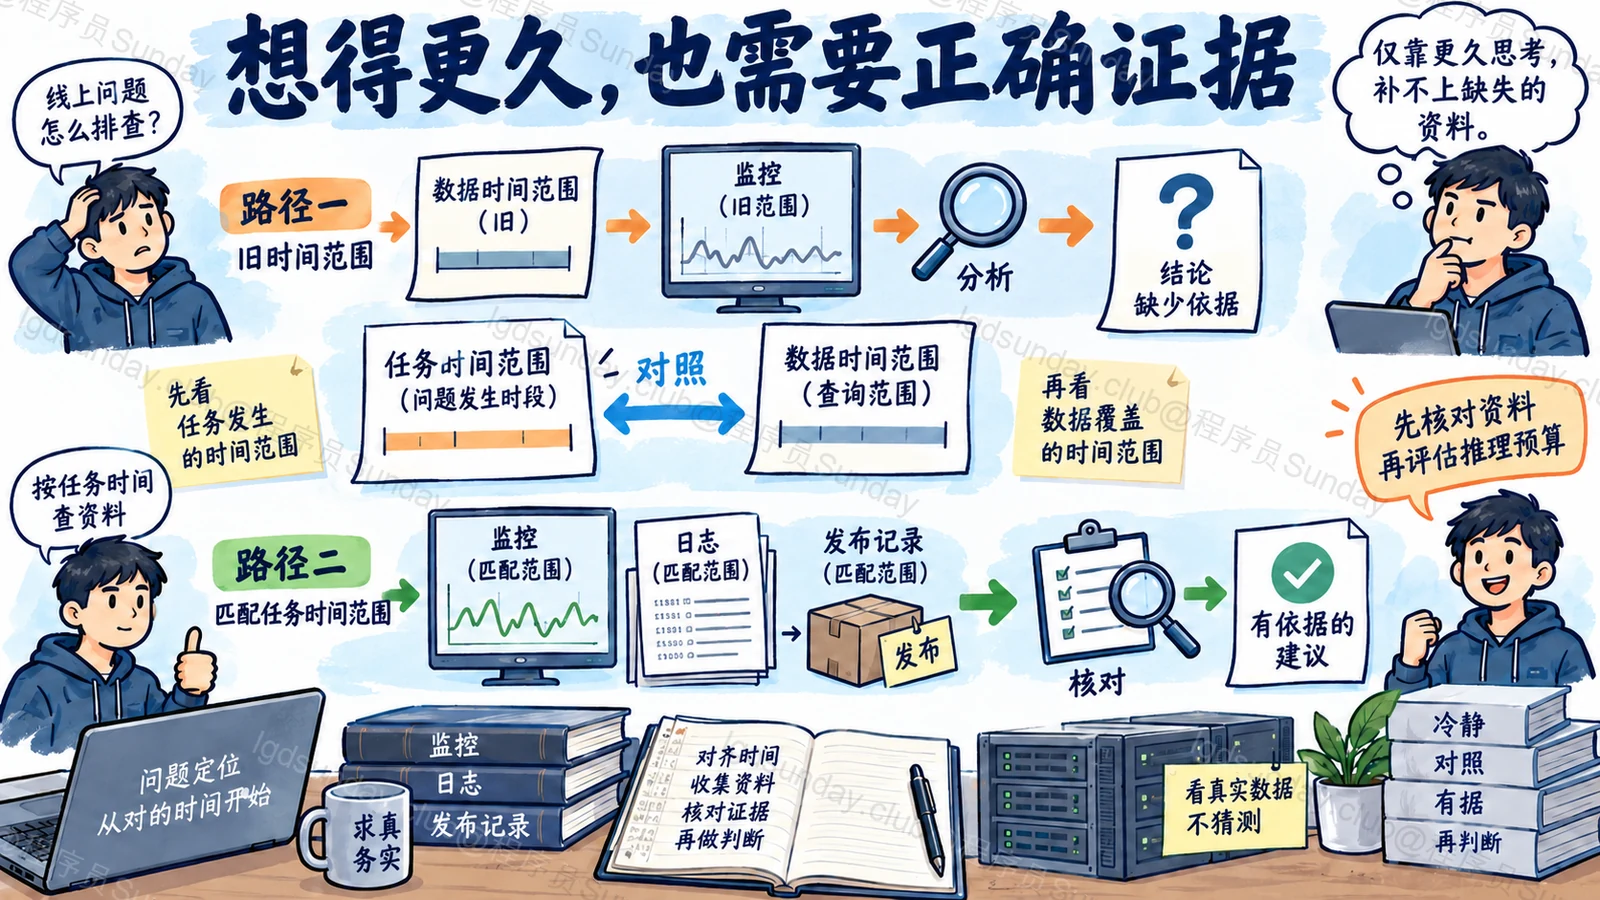
想得更久,不会自动补上不存在的证据
如果查询工具返回的是昨天的数据,而任务要求最近半小时,模型即使投入更多计算,也可能围绕错误材料得出完整却错误的结论。
所以,结果质量至少受三部分影响:可用信息是否正确、模型是否理解信息、执行动作是否可靠。推理模型主要改变其中一部分,并不能替代资料更新、工具校验和权限设计。
实际回答可以要求模型列出“已确认事实”和“仍需验证的解释”。这样便于检查证据,没必要要求它公开完整内部思考。Anthropic 的扩展思考文档也体现了不同接口下预算与工具使用的具体约束;这些应按目标模型核对,不能直接套到所有服务。
怎样验证额外计算值不值
先保持工具、提示词和任务输入一致。准备简单提取、多证据判断、信息不足和工具失败等样本,分别运行候选模型。
不要只比较最后一句话是否“像答案”。需要检查任务目标、事实错误、无必要调用、高风险动作以及耗时。使用供应商的预算控制时,还应记录实际设置,否则无法解释效果差异。
如果推理模型只在复杂排查中明显改善结果,就可以只让这类步骤使用它。混用之后还要再测一次,因为路由可能误判难度,模型之间交接也可能丢失约束。
这里不能承诺“换成推理模型成功率提升多少”。只有实际样本和测试结果,才能支持这个结论。
面试官继续追问
能不能根据问题长度选择模型?
可以作为辅助信号,但不可靠。很短的问题也可能包含复杂约束;很长的文档提取任务可能只是机械抽取。最好结合任务类型、历史错误和可检查的复杂度。
推理预算越高越好吗?
不一定。收益可能变小,延迟和费用却继续增加。应比较多个预算下的实际任务结果,找到能满足目标的配置。
面试中应该展示模型完整思考吗?
更适合展示依据、验证步骤和决策边界。完整内部思考并不是稳定、必要的产品接口,也不能代替可追踪的工具记录。
面试速记卡
- 普通模型:也具备推理能力,不是只会直接回答。
- 推理模型:通常更强调专门训练与推理阶段的计算投入。
- 适用任务:多证据、多约束问题值得重点评估。
- 不能替代:正确资料、工具校验和权限控制。
- 选型依据:任务结果、错误类型、延迟和成本共同判断。
公司面试真题
这道题暂未收录可核验的公司真题来源。你可以先阅读本文解析,或浏览已收录的公司面试真题。
浏览公司面试真题 →