
MHA、MQA、GQA 有什么区别?为什么 GQA 能减少 KV Cache?
下面是一段教学用的模拟面试。
🧑💻 面试官:MHA、MQA、GQA 的区别是什么?
🙋♂️ 我:主要是多个查询头怎样使用键和值。MHA 各自配一套,MQA 共享一套,GQA 按组共享。
🧑💻 面试官:MQA 只剩一个注意力头,所以更省显存,对吗?
🙋♂️ 我:查询头仍然可以有多个,减少的是 K、V 头。
🧑💻 面试官:那八个查询头配两个 KV 头,缓存能省多少?模型全部显存都会变成四分之一吗?
别把“头变少了”当成完整回答。要分清保留的查询头、共享的 KV 头,以及显存里究竟哪一部分变小。
面试速答(60 秒版)
这三种注意力结构,主要区别在 K、V 怎么被查询头使用。
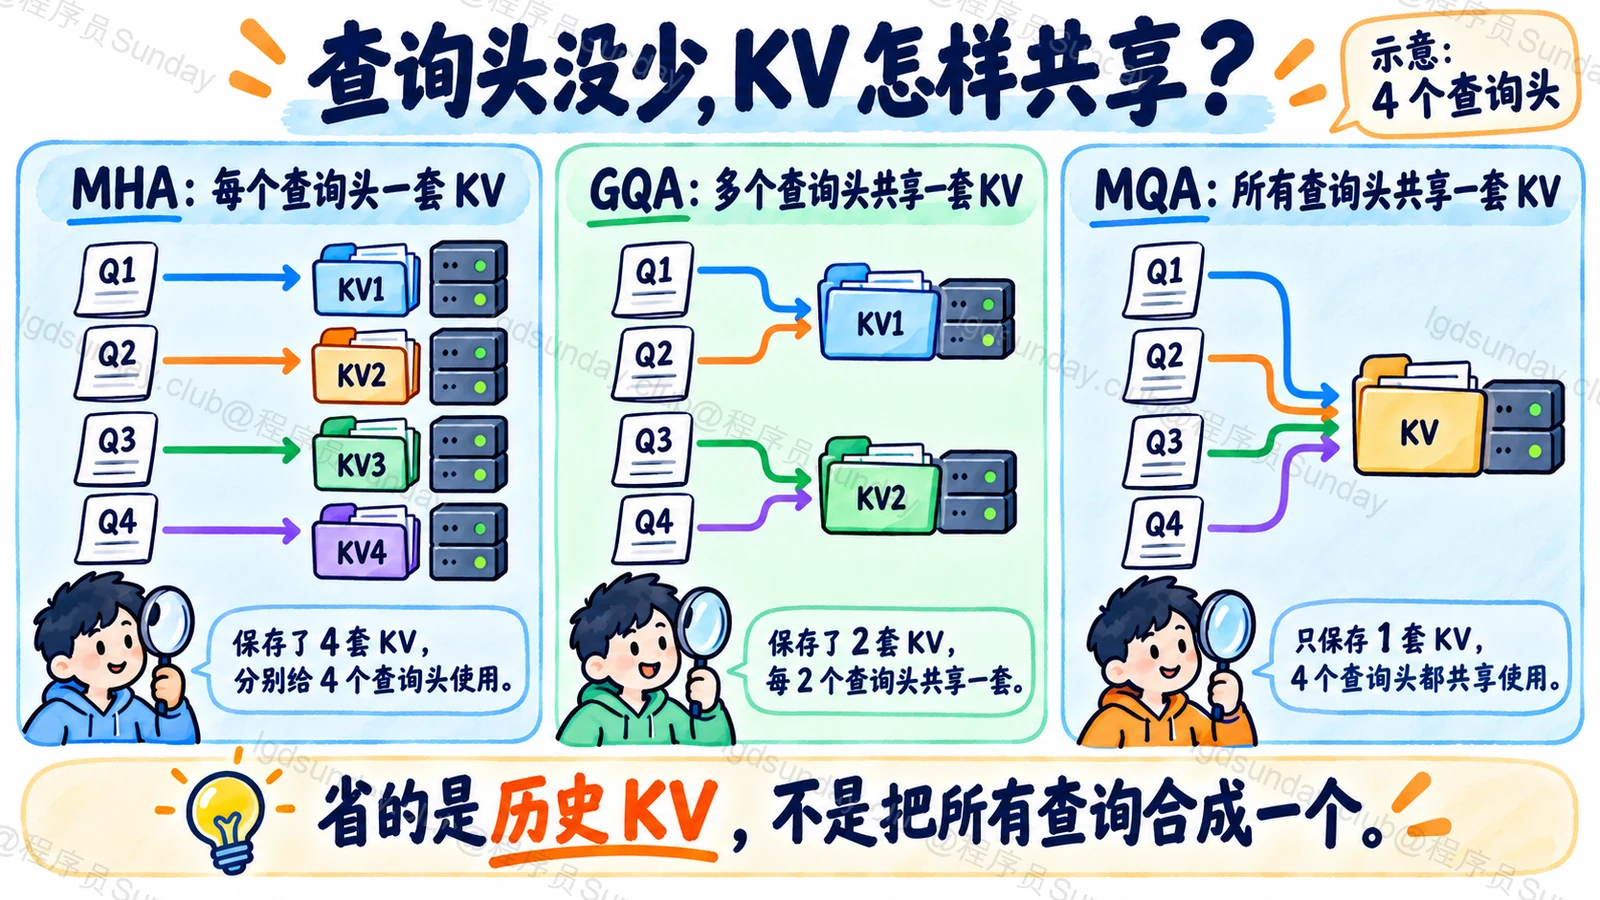
MHA 中,每个查询头都有对应的 K、V 头。MQA 保留多个查询头,但让它们共享一套 K、V。GQA 则把查询头分成几组,每组共享一套 K、V,是两者之间的一种安排。
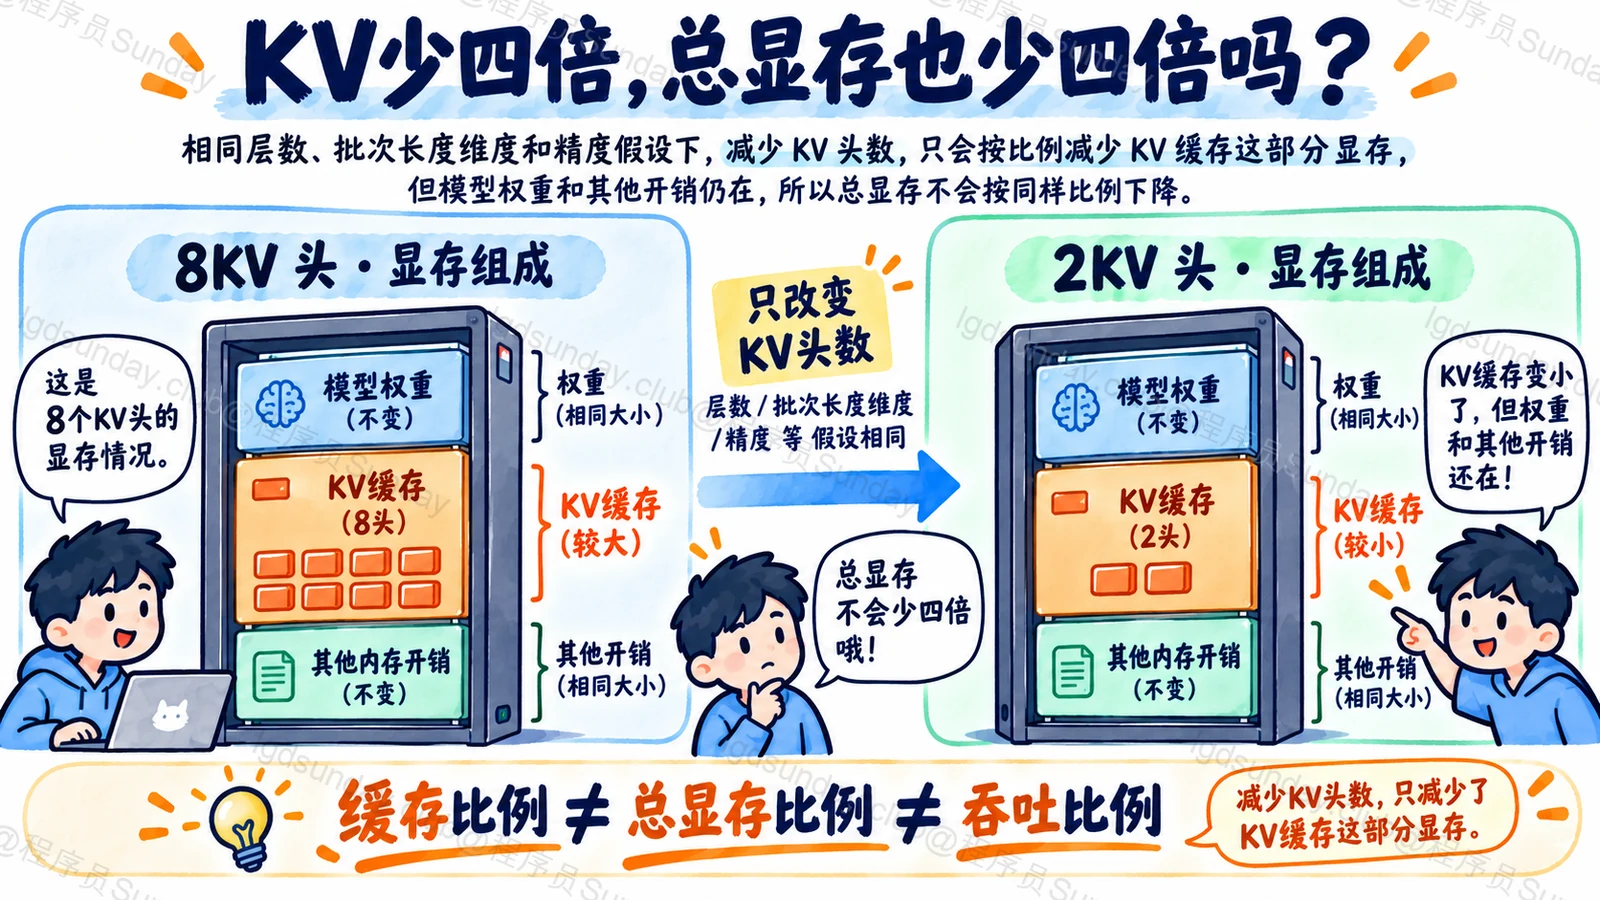
自回归生成时,历史 K、V 需要缓存起来。KV 头越少,在其他条件相同时,这部分缓存就越小。比如八个查询头使用两个 KV 头,理论 KV 数据量是八个 KV 头时的四分之一。
但这不是总显存变成四分之一,模型权重和其他运行开销还在。共享得更多也可能影响质量,因此需要比较任务效果、真实吞吐和内存占用,不能只凭缓存比例选模型。
知识点详解:查询头没少,缓存为什么变小了?
先理解一层注意力里有哪些头
假设咱们看一个有八个查询头的解码器层。每个查询头会从自己的角度计算相关性,再参与后续输出。
在 MHA 中,可以把它画成八条对应关系:Q1 使用 K1、V1,Q2 使用 K2、V2,依次类推。
这里“对应”说的是投影与计算结构,不是每个头只看一个词。每个查询头仍然需要比较允许读取的历史位置。
MQA 和 GQA 改了哪条关系?
MQA 让八个 Q 头使用同一套 K、V。不同 Q 依然可以算出不同的注意力权重,因为 Q 本身并不相同。
GQA 则可以把八个 Q 头分成两组:前四个使用第一套 K、V,后四个使用第二套 K、V。它没有把四个 Q 平均成一个 Q。
| 结构 | 查询头示例 | KV 头示例 | 使用关系 |
|---|---|---|---|
| MHA | 8 | 8 | 每个 Q 配对应的 KV |
| GQA | 8 | 2 | 每组 Q 共享一套 KV |
| MQA | 8 | 1 | 所有 Q 共享一套 KV |
这只是为了理解关系设置的例子,不代表所有模型都使用这些数量。原始 GQA 论文 也讨论了两端的关系:组数等于查询头数时对应 MHA,只有一组时对应 MQA。
为什么主要影响 KV Cache?
模型生成下一段内容时,不必重新计算所有历史位置的 K、V,可以读取已保存的缓存。随着历史变长,每层需要保存的 K、V 也不断增加。
一个简化的理论数据量关系是:
KV 字节数 ≈ 2 × 层数 × 批大小 × 序列长度
             × KV头数 × 每头维度 × 每元素字节数
前面的 2 表示 K 与 V 两类数据。在其他因素相同的前提下,八个 KV 头改成两个,就是这部分理论数据量减少到四分之一。
Q 通常只需要用于当前计算,不像历史 K、V 那样长期累积。因此不能把缓存公式中的 KV 头数直接换成查询头数。
实际系统还会有分页块、对齐、并行切分、临时张量和预分配空间。最终显存应测量,不能拿这个简化公式当监控读数。
为什么共享更多,未必越好?
减少 KV 头,相当于限制了多个查询头可使用的键值表示。不同头仍有自己的查询,但它们看到的 K、V 表示变得更加共享。
因此,缓存和读取带宽可以受益,表示能力与训练适应也需要考虑。GQA 提供的是一个可调安排,不是对 MHA 在所有任务上的绝对替代。
已有 MHA 模型也不能在推理时随便删掉几组 K、V 权重,就当成原本训练好的 GQA。结构转换之后通常需要相应训练和质量验证。
选型时,应该看哪些结果?
同一硬件和相同任务下,分别比较长上下文、并发量和生成长度。记录峰值显存、每秒生成量、请求延迟,以及回答质量。
如果工作负载主要受模型权重或其他计算限制,KV Cache 变小带来的速度提升可能没那么明显。如果需要容纳很多长会话,缓存规模则可能直接决定能否运行。
还有一点要确认:执行内核是否真正按共享 KV 结构实现。如果中间又物理展开了重复数据,理论节省未必全部保留下来。
面试官继续追问
GQA 和 KV Cache 量化能一起用吗?
可以是不同维度的优化。GQA 改变 KV 头的组织方式,量化改变每个元素的表示精度。二者都需要验证质量和实现支持。
MQA 的所有查询头,结果会一样吗?
不会仅因为共享 K、V 就相同。不同 Q 会产生不同匹配权重,后续计算也有各自结构。
缓存少四倍,吞吐就高四倍吗?
不能这样换算。吞吐还受计算、内存带宽、内核效率、批处理与调度影响,得用真实负载测。
面试速记卡
- 比较重点是 KV 的共享方式,不是把查询头全部合并。
- MHA 每头对应,MQA 全部共享,GQA 按组共享。
- 历史 K、V 要缓存,Q 通常不按历史长期累积。
- 同条件下,KV 理论数据量与 KV 头数成正比。
- 缓存比例不是总显存比例,也不是吞吐比例。
- 结构、质量、执行内核与负载一起决定收益。
公司面试真题
真题根据求职者公开面经整理,题意经过概括,非逐字原话或公司官方题库;本文为 Sunday 的独立解析。
字节跳动 · 风控算法 · 原帖未明确批次
MQA 与 GQA 有什么区别?(题意整理)
字节风控算法面经 ↗
原帖发布于 2025-09-21