
Decoder-only 是什么?和 Encoder-only、Encoder-Decoder 有什么区别?
下面是一段教学用的模拟面试。
🧑💻 面试官:Transformer 为什么会分成三类架构?
🙋♂️ 我:可以只用编码器、只用解码器,或者两者一起用。
🧑💻 面试官:这只是名字。编码一句话时,每个位置能看见什么?生成一句话时又能看见什么?
🙋♂️ 我:编码器通常能读取整个输入,生成用的解码器通过因果掩码限制未来位置。
🧑💻 面试官:Decoder-only 没有单独编码器,为什么仍然能理解问题?翻译又为什么常用 Encoder-Decoder?
三类架构的区别,要从信息怎样流动讲起:读完整个输入,还是根据已有前缀继续生成,输入与输出是否分成两条路径。
面试速答(60 秒版)
Encoder-only 主要把输入处理成上下文表示。常见编码器允许一个位置读取整个输入,因此适合文本分类、实体识别等需要理解完整文本的任务。
Decoder-only 则根据已有前缀预测后面的内容。生成时使用因果注意力,不能偷看尚未生成的未来 Token。用户问题也作为前缀进入同一套模型,所以没有独立编码器,不代表它不能理解输入。
Encoder-Decoder 把两条路径分开:编码器处理输入,解码器一边看已经生成的输出,一边通过交叉注意力读取编码结果。翻译、摘要这类输入到输出的转换,比较容易按这种结构组织。
但架构只是选型的一部分。训练目标、数据、模型规模和实际评测同样重要,不能把三类模型硬分成“只理解”“只生成”“只能翻译”。
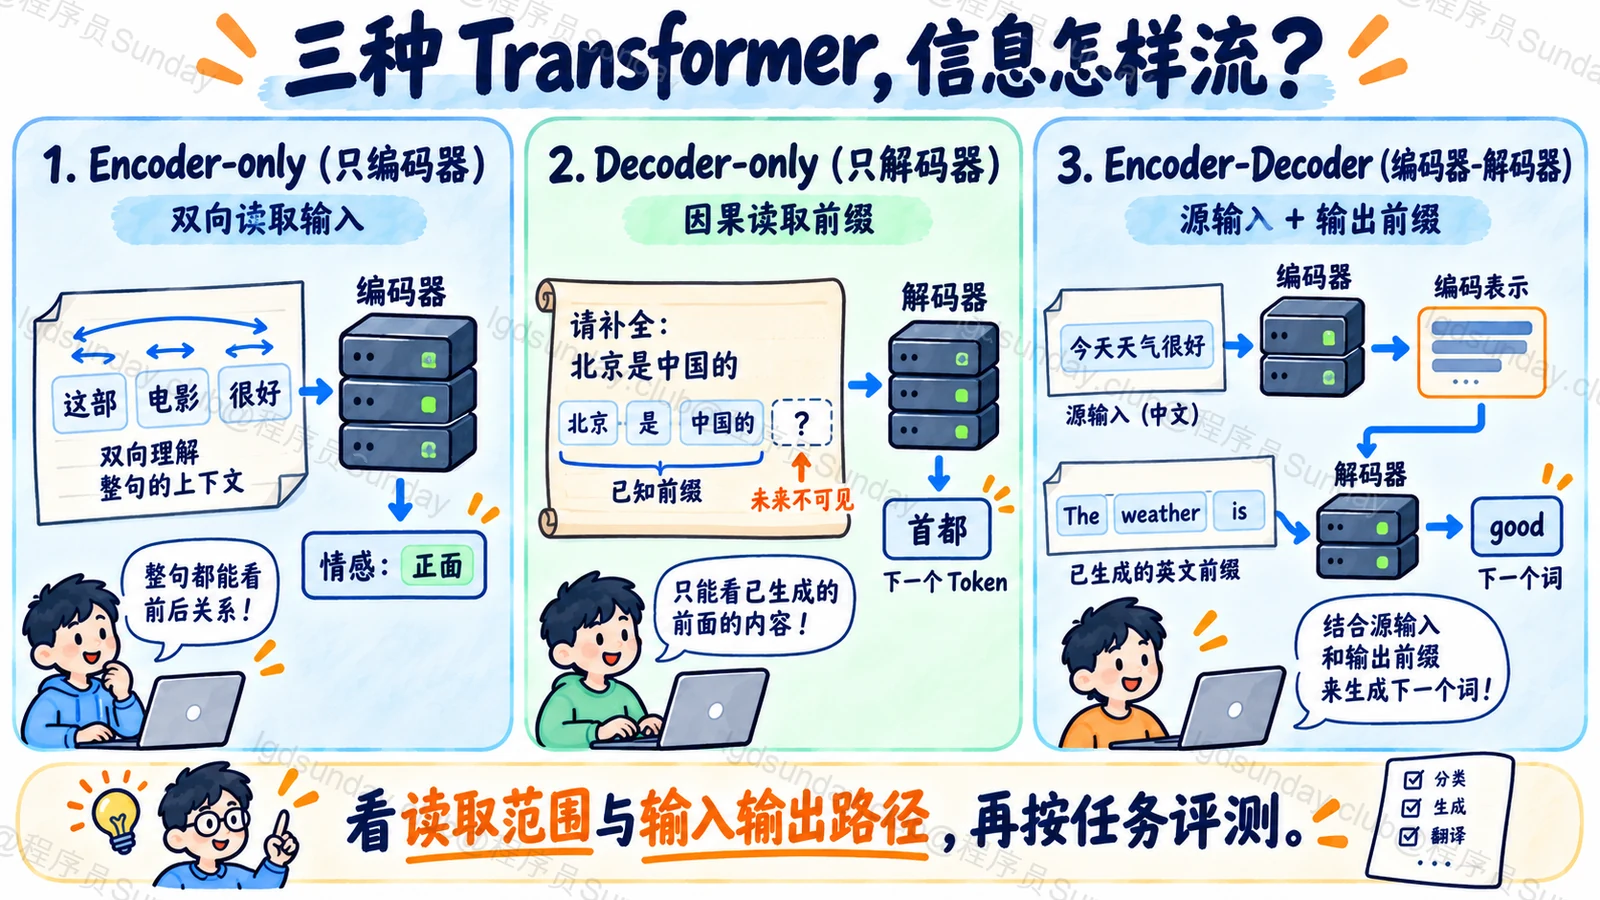
知识点详解:同一句输入,在三种结构里怎样被使用?
Encoder-only 怎样读完整句话?
假设任务是判断“这个键盘手感不错,但连接经常断开”表达了什么情绪。
编码器里,一个位置可以结合前后的词形成表示。例如“不错”后面还有转折,不能只看到前半句就判断全句积极。
最后可以根据句子表示完成分类,也可以根据各位置表示识别实体。经典代表之一是 BERT,不过这不意味着所有 Encoder-only 模型都使用完全相同的预训练任务。
这里的双向读取,说的是输入范围内的信息,不是访问输入之外的真实世界。
Decoder-only 怎么处理问题和回答?
假设用户问“解释一下 TCP 重传”。系统把指令、问题和已有回答前缀按规定格式送入模型。
预测下一个回答 Token 时,模型能读取前面的指令和问题,也能读取已经生成的回答。因此,它并没有跳过输入理解。
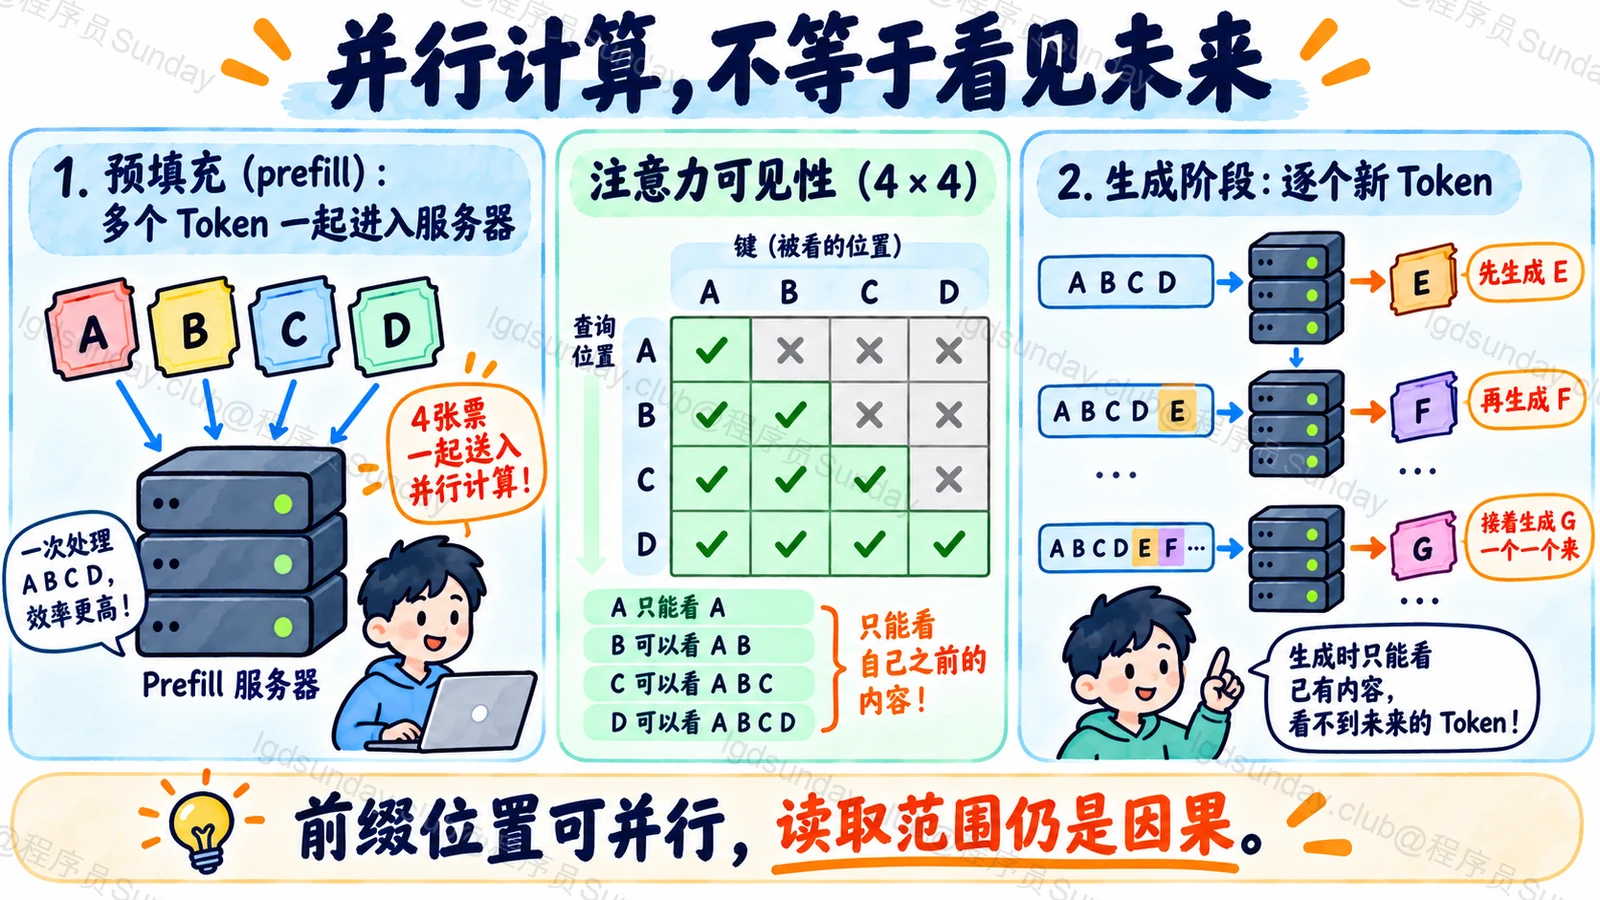
因果掩码保证位置不能读取后面的内容。训练时,真实序列可以一次送入并行计算多个位置的损失,但掩码仍阻止答案泄漏。推理时未来 Token 还不存在,就需要逐步生成或使用合适的加速机制。
所以,“训练时能并行计算”与“普通推理逐步生成”并不矛盾。KV Cache 则用于减少历史 K、V 的重复计算,不改变因果读取范围。
Encoder-Decoder 多了一条什么路径?
假设任务是把一句中文翻译成英文。编码器先处理完整中文输入,形成一组表示。
解码器生成英文时,有两种注意力关系。一种读取已生成的英文前缀;另一种读取中文编码结果,也就是交叉注意力。
这样,源文本和目标文本分别组织。生成到英文某个位置时,仍然可以访问完整源文本,但不能偷看后面尚未生成的英文。
这和 Decoder-only 把问题与输出放进同一条前缀序列不同。三类的基本结构与任务说明可参考 Hugging Face 的架构课程。
注意力范围不同,能直接决定能力高低吗?
不能。双向读取输入对某些表示任务很合适,但不自动等于“理解能力一定更强”。同样,Decoder-only 的自回归目标方便组织生成任务,也不代表其他结构不能生成文本。
模型经过什么训练、读过什么数据、任务接口如何组织,都会影响实际能力。一个分类任务可以使用专门的编码器,也可以让生成模型输出受约束的标签。
选择时,需要比较准确率、吞吐、输出约束、资源占用和维护方式。别为了统一模型,把一个很小的稳定分类任务也变成昂贵的长文本生成;也别只凭架构名称排除一个已经通过评测的方案。
面试里怎么讲,才不只是背模型名?
先选一个任务,追踪输入到输出。说明哪些位置可以互相读取,是否有交叉注意力,再解释怎样产生训练信号。
最后补一个工程判断:如果要大量稳定地提取文本表示,编码器值得优先评测;如果要开放式对话生成,Decoder-only 是常见路线;如果输入与输出转换边界明确,Encoder-Decoder 也值得比较。
这些是评测起点,不是无需验证的结论。
面试官继续追问
Decoder-only 的输入处理,也只能一个 Token 一个 Token 做吗?
已有输入通常可以在因果掩码下并行处理,也就是常说的 prefill。后续生成的未来内容未知,才需要逐步推进。不要把两个阶段混成一回事。
Encoder-Decoder 的解码器,是不是只看源文本?
还要看已生成的目标前缀。只有源文本,没有输出历史,就不是这里描述的常见自回归解码流程。
选模型时背出 BERT、GPT、T5 就够了吗?
这些名字能帮助定位例子,但面试官真正要确认的是注意力范围、训练目标和任务选择。具体模型还可能有结构变体,需要看配置。
面试速记卡
- Encoder-only 常见为双向读取输入,形成上下文表示。
- Decoder-only 根据已有前缀继续生成,使用因果注意力。
- 用户问题属于前缀,没有单独编码器也能处理输入。
- Encoder-Decoder 分开输入与输出,通过交叉注意力连接。
- 训练并行计算和推理逐步生成可以同时成立。
- 架构提供路线,效果仍靠任务与资源评测。
公司面试真题
这道题暂未收录可核验的公司真题来源。你可以先阅读本文解析,或浏览已收录的公司面试真题。
浏览公司面试真题 →