
BPE 分词算法是什么?Tokenizer 怎样把文本切成 Token?
下面是一段教学模拟,不是真实面试记录。
🧑💻 面试官:模型输入之前,文本怎样变成 Token?
🙋♂️ 我:Tokenizer 把文字切开,常见算法是 BPE。
🧑💻 面试官:BPE 按字切还是按单词切?
🙋♂️ 我:应该把常见单词合成一个 Token。
🧑💻 面试官:遇到没见过的单词呢?分词时会重新统计这篇输入里的高频字符对吗?
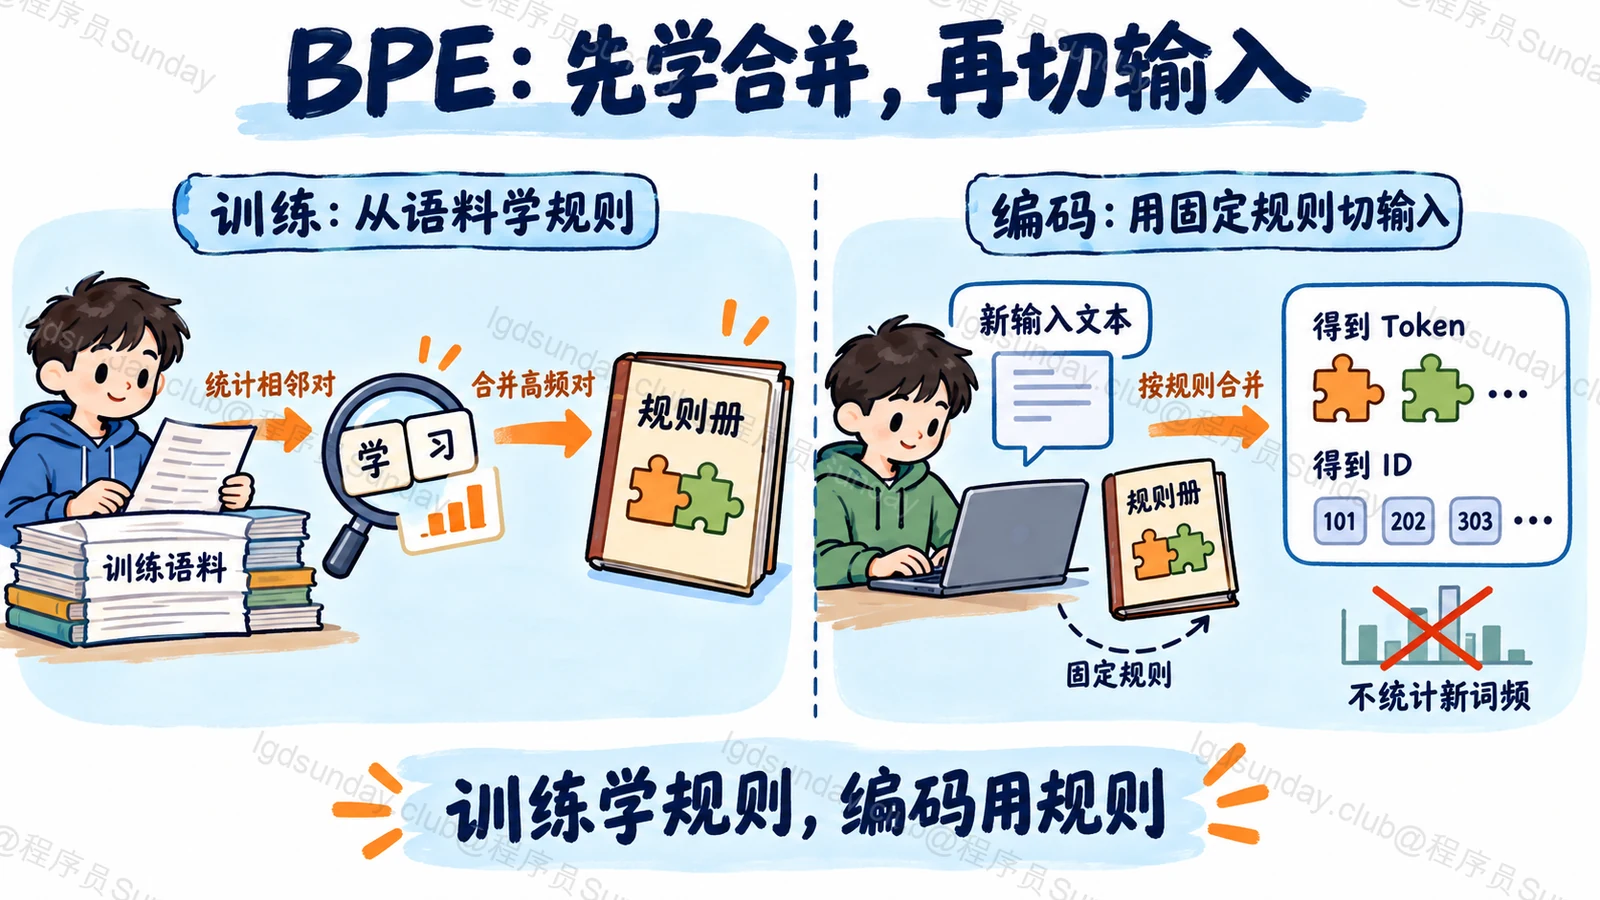
BPE 要区分「训练规则」和「使用规则」:训练时学习相邻符号怎样合并,处理新输入时使用已保存的规则,不现场重新训练。
面试速答(60 秒版)
BPE 是一种通过反复合并相邻符号来构建子词词表的方法。训练时从基础符号开始,统计相邻对的频率,将选中的高频对合成新符号,再继续统计和合并。
处理新文本时,Tokenizer 使用训练好的词表和合并优先级,把文本转换成 Token,再映射成 ID。它不是重新学习用户这次输入的词频。
因此,Token 可能是一个字、一个子词、完整单词,也可能对应字节片段,不能统一理解成汉字或单词。
具体切法还受到规范化、预切分、特殊 Token 和字节级实现影响。计算长度或检查模型输入时,应使用对应模型的 Tokenizer,不能只按字符数估计。
知识点详解:从小符号开始,怎样形成更长的 Token?
为什么不只用字符或完整单词?
全部按字符切,词表小,但常见长词也需要很多 Token。全部按完整单词切,词表可能很大,还会遇到没有收录的新词。
子词方法提供一种折中:常见组合可以作为较长单位,不常见的内容继续拆成较小单位。BPE 是实现这类思路的一种算法,但不是所有 Tokenizer 都使用 BPE。
另外,Tokenizer 不是只有合并算法。文本规范化和预切分会决定哪些符号相邻、哪些位置不能直接合并,最后还需要将 Token 映射为词表 ID。
训练时,合并的是当前表示里的相邻对
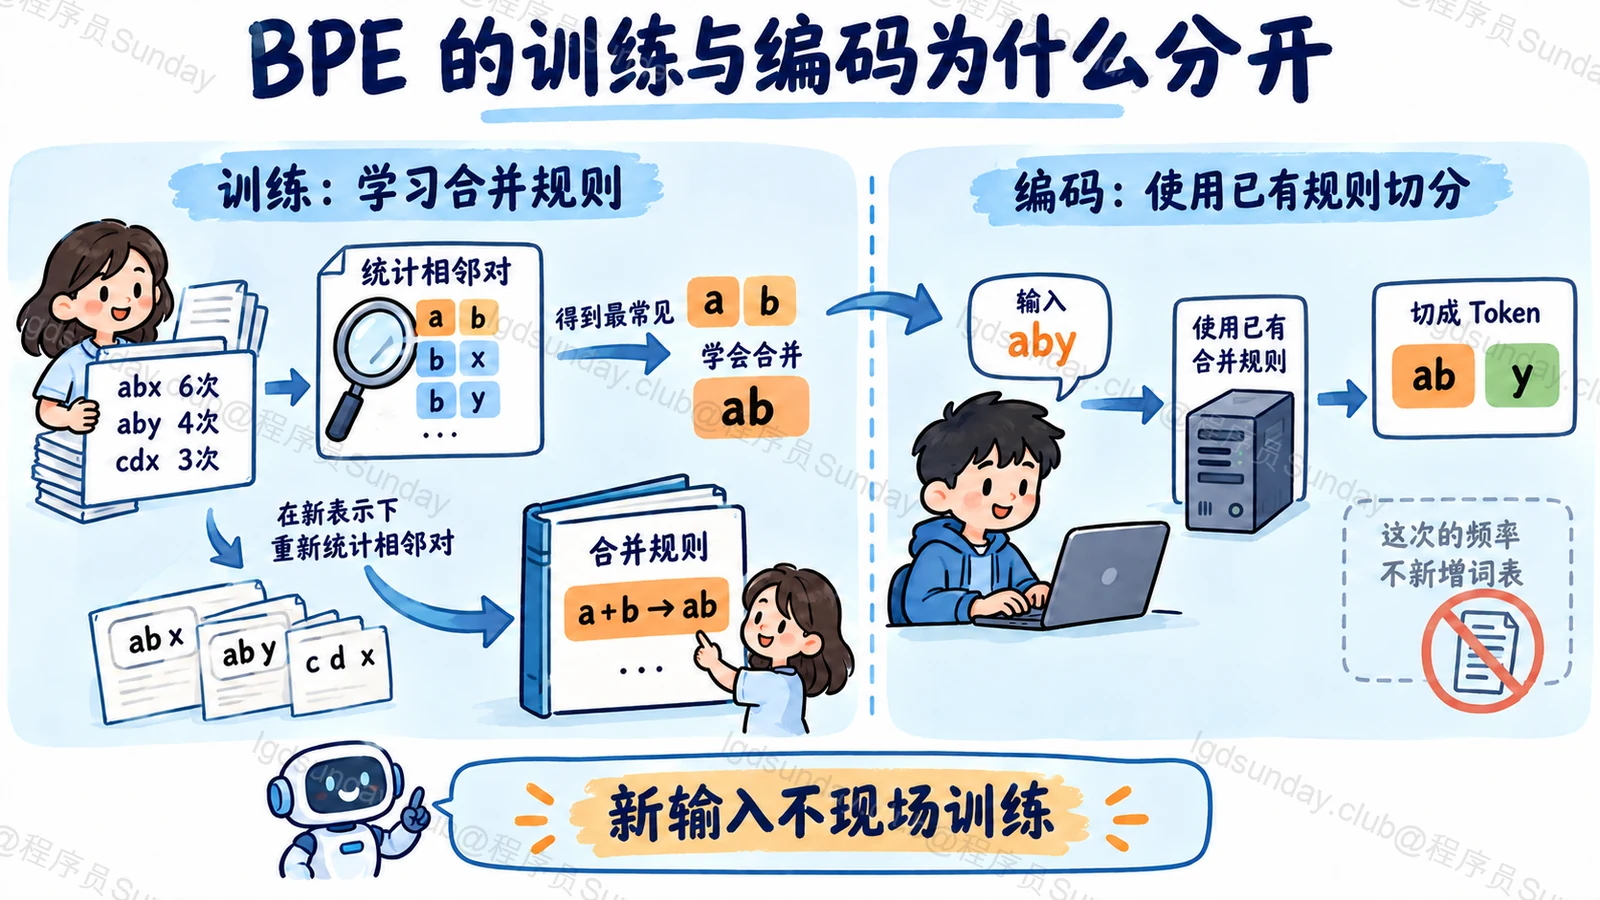
用一个简单的教学语料说明。假设基础符号是字母,三个词及频次分别为:
- abx,出现 6 次。
- aby,出现 4 次。
- cdx,出现 3 次。
初始表示中,a、b 相邻出现 10 次,超过其他相邻对,因此先学习 a + b → ab。
合并后,前两个词变成“ab、x”和“ab、y”。下一轮要在新的表示上重新统计,而不是继续使用第一轮的旧计数。此时,ab 与 x 可以作为新的相邻对参与比较。
重复这个过程,直到满足词表大小等停止条件,就得到了基础符号、新符号和有顺序的合并规则。BPE 官方课程
这是简化教学语料,没有加入空格编码、词边界和真实模型的特殊符号。
编码新输入,不重新统计频率
假设已经学习 a + b → ab,之后又学习 ab + x → abx。
处理新词 abx 时,规则先形成 ab,再形成 abx。处理 aby 时,能形成 ab,但如果没有 ab + y 的对应规则,就继续保留 y。
此时决定切分的是已经训练好的规则及优先级,而不是 aby 在当前文章里出现得多不多。用户输入再重复一百次,也不会因此现场新增一个词表项。
真实实现可能使用更高效的排名合并方式,不必机械遍历整张规则表;核心仍是遵循已学习的规则,不能换成“每次取当前输入最高频字符对”。
字节级 BPE 为什么不等于一个字一个 Token?
字节级变体从字节表示出发,再学习合并。一个 UTF-8 汉字通常占多个字节,这些字节是否合成同一个 Token,要看词表和规则。
因此,一个汉字可能涉及多个 Token,几个汉字也可能合成一个 Token。代码里的空格、标点和常见词组同样影响结果。
字节级基础集合能够覆盖字节,并不意味着所有变体都自动采用同一套编码方式,也不意味着每个 Token 展示出来都像一个正常的文字片段。
SentencePiece 则是一个分词工具体系,可以训练 BPE、Unigram 等模型,不能把它简单当成与 BPE 完全平行的单一算法名称。
面试官继续追问
同一句话换个模型,Token 数一定相同吗?
不一定。两个模型的词表、合并规则、预处理和特殊 Token 都可能不同。实际计费或上下文限制,应使用目标模型的规则。
BPE 会理解单词的意思吗?
训练合并主要依据符号统计,不等于理解语义。语义表示主要由后续模型学习,不能把常见组合合成一个 Token 就叫语义理解。
为什么聊天消息的 Token 数不只是正文分词数量?
输入还可能包含角色、消息边界、工具定义和其他格式信息。具体序列化方式取决于模型接口,不能把纯文本分词数当成完整请求的精确计数。
面试速记卡
- 训练:统计相邻符号对,合并后重新统计,逐步扩展词表。
- 编码:使用保存的词表和合并优先级,不重训当前输入。
- Token:不固定对应一个字或一个单词。
- 字节级:从字节表示开始,合并结果仍由训练规则决定。
- 实际计数:使用对应模型 Tokenizer,并考虑消息格式。
公司面试真题
这道题暂未收录可核验的公司真题来源。你可以先阅读本文解析,或浏览已收录的公司面试真题。
浏览公司面试真题 →