
GRPO 是什么?和 PPO 有什么区别,为什么不需要单独的价值模型?
下面是一段教学用的模拟面试。
🧑💻 面试官:GRPO 为什么可以省掉价值模型?
🙋♂️ 我:同一个问题采样多份回答,用这一组的奖励来构造相对优势。
🧑💻 面试官:那么奖励模型也不要了,模型自己比较哪个回答好就行?
🙋♂️ 我:不是。省掉价值模型,不代表不用奖励,奖励还需要可信来源。
🧑💻 面试官:如果四份回答都错了,或者都得一分,这组数据还能提供什么信号?训练又怎样避免一步改得太大?
先分清两种工作:奖励评价回答结果,价值估计提供比较基线。GRPO 改的是后面这部分。
面试速答(60 秒版)
GRPO 是一种策略优化方法。它针对同一个问题采样一组回答,分别获得奖励,再利用组内奖励构造相对优势,指导模型调整生成这些回答的概率。
在常见的大模型 PPO 训练中,除了策略模型,还会训练价值模型,用它估计基线并计算优势。GRPO 用组内比较替代这套独立价值估计,因此可以省去相应的训练与内存开销。
但奖励仍然需要提供。可以来自可验证的规则,也可以来自奖励模型;“没有价值模型”和“没有奖励模型”是两回事。
同时,多份回答的采样、奖励质量、组内差异,以及限制策略变化的机制仍然重要。它不是随便选一份最好答案再模仿,也不意味着只要采用 GRPO,推理能力就会自动提高。
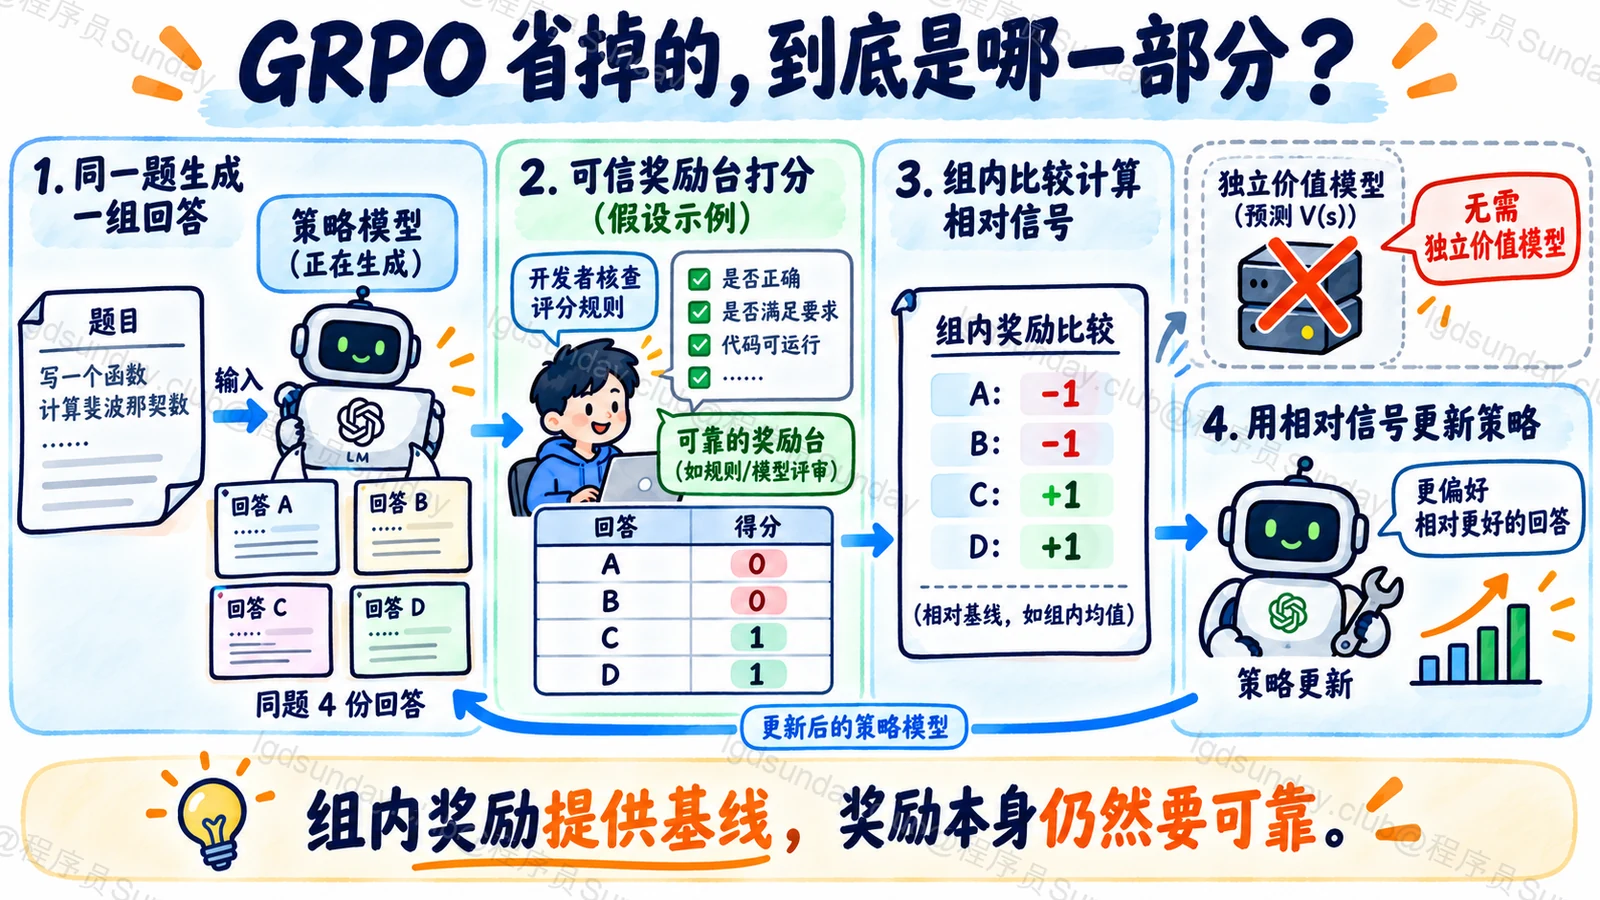
知识点详解:同一题的多份回答,怎样变成训练信号?
奖励与价值,分别在回答什么?
咱们假设训练任务是解一道有标准结果的数学题。
奖励可以根据最终结果是否正确给分,也可以结合格式或其他规则。它回答的是“这份回答获得多少评价”。
价值估计则试图判断当前状态下,后续大概能得到多少回报。优势比较实际回报与基线,帮助判断某个动作相对预期是更好还是更差。
所以,即使它们都输出数值,也不能把奖励模型与价值模型当成同一个组件。
GRPO 为什么要一题生成一组?
假设同一道题采样出四份回答,奖励分别为 0、0、1、1。组内平均奖励是 0.5。
在原始方法的一种结果监督形式中,可以用“奖励减组内均值,再按组内标准差归一化”来构造相对优势。高于基线的回答得到正向信号,低于基线的回答得到负向信号。
这一组回答提供了就地比较的基线,因此不再需要训练独立价值模型来完成相应估计。方法来源见 DeepSeekMath 原始论文。
这个小例子只是解释信号如何产生,不是声称奖励只能为 0 或 1,也不覆盖所有后续 GRPO 变体。
这和“选最好的一份做监督学习”有什么不同?
只拿最佳回答做监督学习,通常是在训练模型复现那份文本。
GRPO 的策略更新会考虑采样回答相对于基线的优势,以及新旧策略下这些生成动作的概率关系。它不只保存一份答案,也会利用较差回答对应的信号。
同时,不能把“正优势”理解成这份回答的每一句话都正确。若奖励只看最终答案,中间可能存在推导缺陷。奖励定义与监督粒度,会决定模型学到什么。
一组奖励完全一样,怎么办?
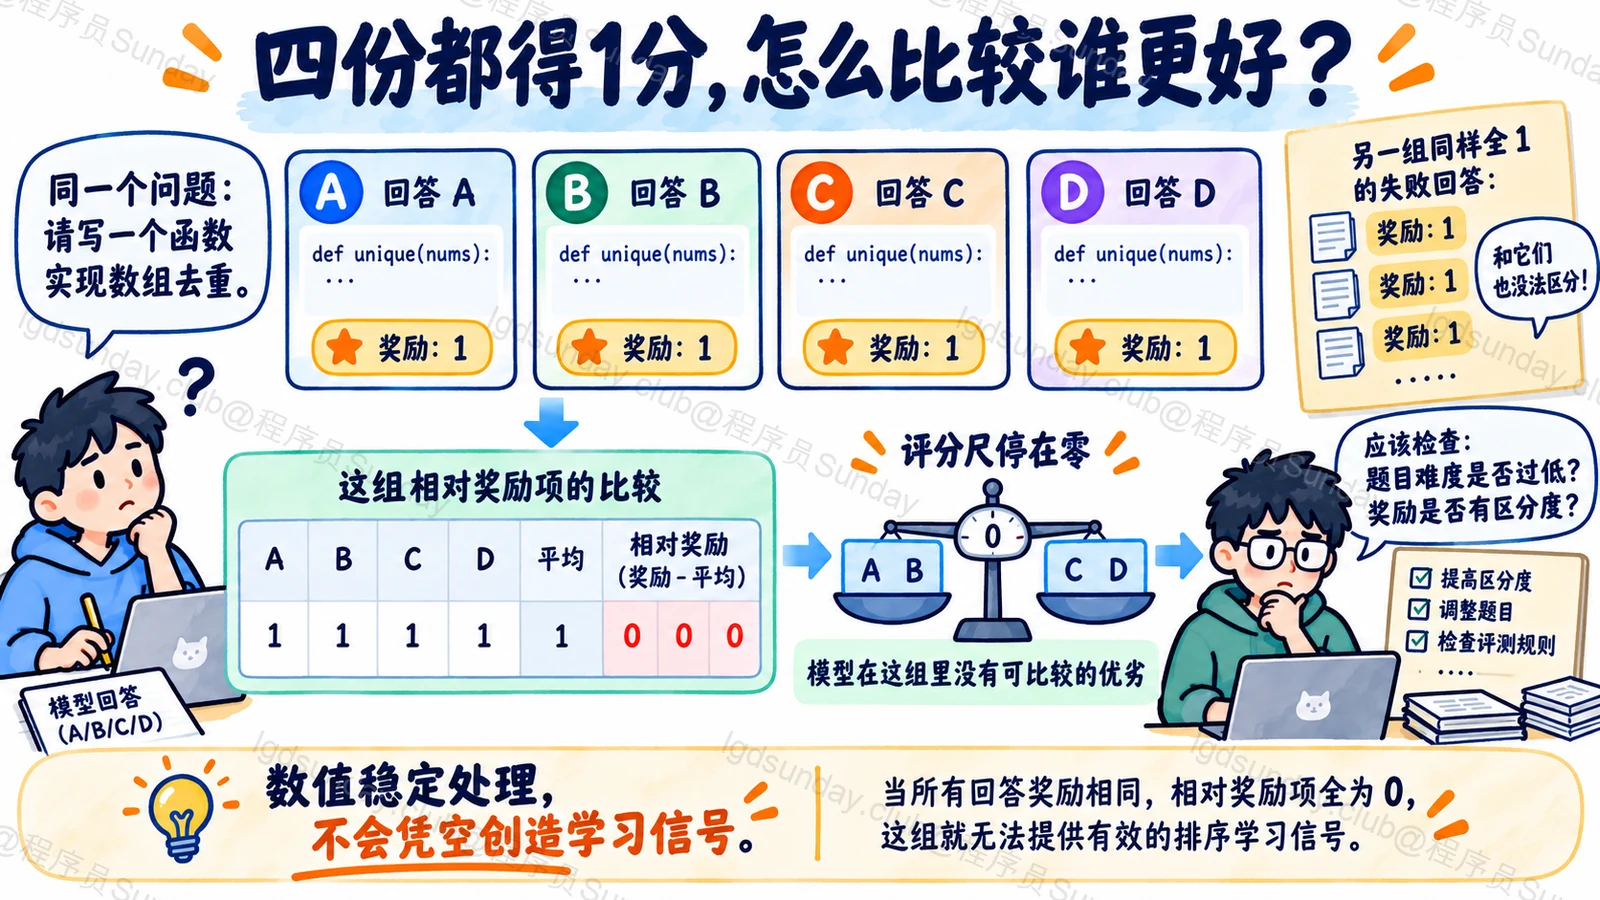
假设四份回答都得 0 分。它们在组内没有优劣差异,简单的归一化还会碰到标准差为零的问题。
实现必须处理这个数值边界。即使加入稳定项解决了除零,也不会凭空创造有用的相对信号。
因此要检查训练题目的难度、采样多样性和奖励分布。全对或全错的组太多,可能意味着当前数据和训练阶段不匹配。不能只增加采样份数,就认为一定获得了更好的学习信息。
为什么还要限制更新幅度?
采样来自旧策略,更新以后策略发生变化。如果一次把生成概率改得过大,原来的样本和当前策略之间可能失去合理关系。
原始 GRPO 保留了限制策略更新的设计,也使用相应的 KL 约束。后续实现可能采用不同安排,讨论具体训练时要看目标函数和配置,不能只看名字。
工程上还要观察奖励是否升高、输出是否变长、格式是否被投机利用,以及真实任务表现有没有改善。奖励分数上升,但模型只学会迎合评分漏洞,并不算训练成功。
真正节省的是哪一部分?
省掉独立价值模型,可以减少对应模型、梯度和优化器状态的开销。但同题多回答的生成、奖励计算、参考策略与训练本身仍然要消耗资源。
因此应比较完整训练任务的显存、吞吐与达到目标效果所需的时间,不能把“少了一个模型”直接换算成固定成本降幅。
面试官继续追问
奖励来自规则,还需要奖励模型吗?
如果任务可以可靠验证,例如结果判定或受控测试,可以使用规则奖励,不必强行增加奖励模型。但开放式质量判断可能需要其他评估方式。
只检查最终答案,会不会学到错误推导?
有这个风险。最终结果奖励不能完整证明过程可靠,需要相应过程检查、数据与评测来约束。
GRPO 一定比 PPO 更好吗?
不能脱离任务和实现比较。它减少独立价值估计的开销,但组内比较的信号质量、采样成本和训练稳定性仍然要验证。
面试速记卡
- 奖励评价结果,价值估计提供预期回报基线。
- GRPO 用同题多回答的组内奖励构造相对优势。
- 省掉独立价值模型,不等于省掉奖励。
- 组内奖励无差异,需要处理数值与有效信号问题。
- 更新幅度、奖励投机和真实效果都要检查。
- 资源收益看完整训练流程,不报固定降幅。
公司面试真题
这道题暂未收录可核验的公司真题来源。你可以先阅读本文解析,或浏览已收录的公司面试真题。
浏览公司面试真题 →