
Trie 前缀树怎么实现?完整匹配和前缀匹配有什么区别?
以下对话为教学模拟,用来讲解这道题。
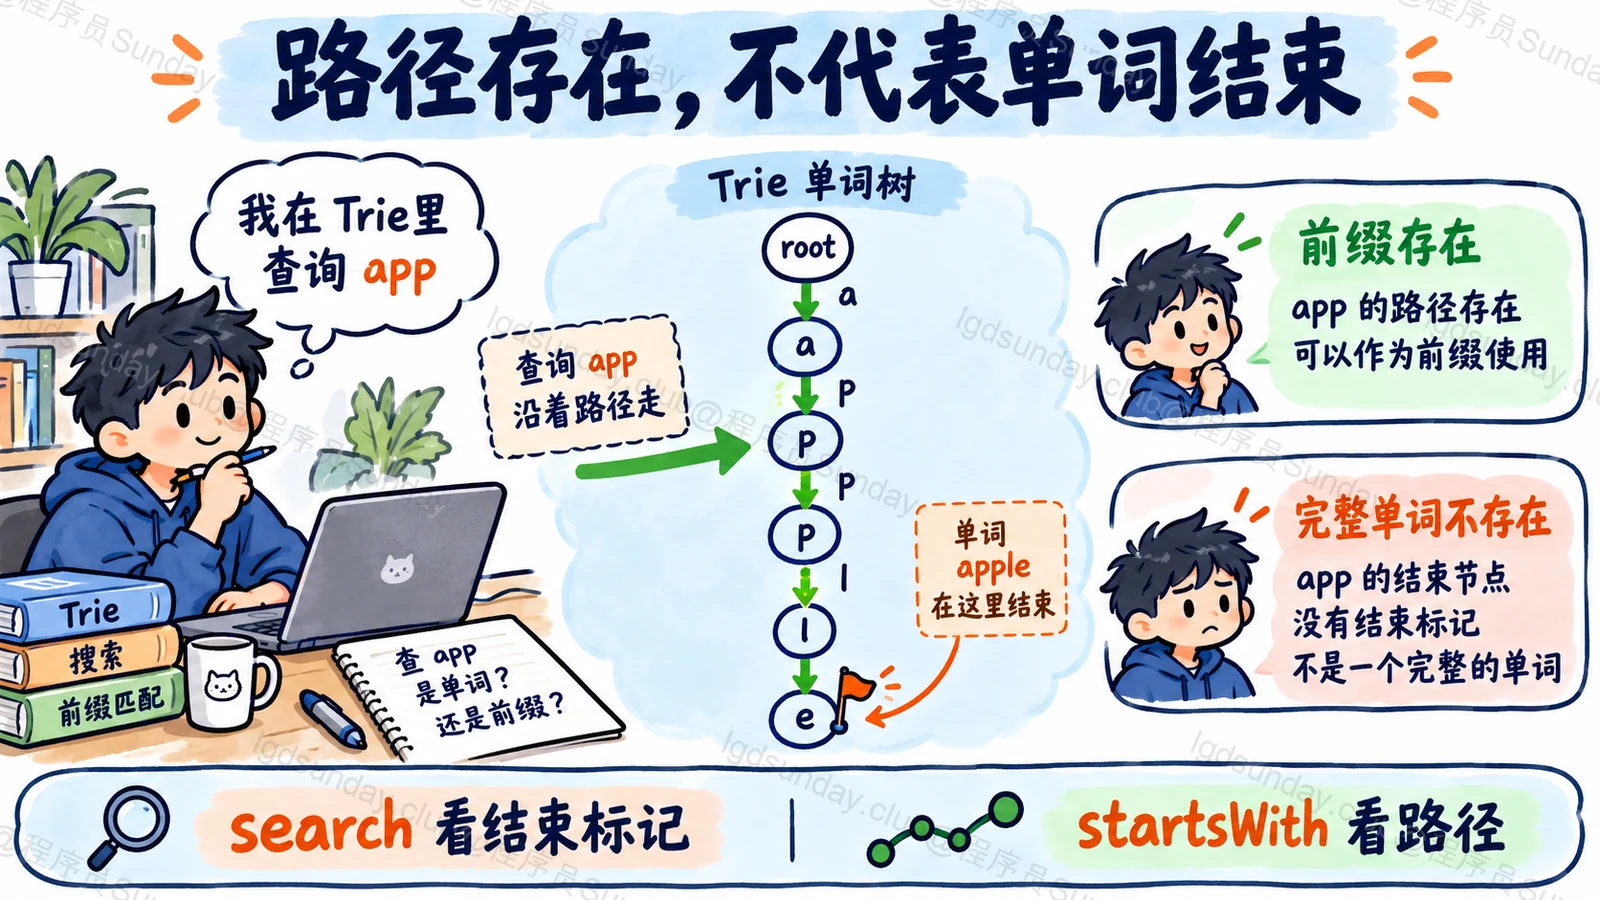
🧑💻 面试官:已经插入 apple,查 app,应该返回存在吗?
🙋♂️ 我:a、p、p 这条路径存在,应该存在。
🧑💻 面试官:但我问的是 app 这个完整单词,不是有没有 app 开头的单词。你存的结构能区分吗?
🙋♂️ 我:需要在单词结束的位置加一个标记。
🧑💻 面试官:那再插入 app,会不会把 apple 覆盖?输入前缀以后返回全部候选,还是 O(前缀长度) 吗?
路径说明前缀走得通,结束标记说明单词在这里结束。这两份信息必须分开保存。
面试速答(60 秒版)
Trie 把字符串按字符逐层组织。相同前缀共享前面一段路径,每个节点保存到下一字符的连接,以及当前路径是否是一个完整单词。
插入时从根开始,缺少对应字符节点就创建,走完以后设置结束标记。完整查询需要路径存在,并且最后节点有结束标记;前缀查询只要求路径存在。
因此,只插入 apple 时,startsWith app 为真,但 search app 为假。后来插入 app,只需把中间那个节点标成结束,不会删除后面的 le。
按字符逐步查找,长度为 L 的插入和查询平均是 O(L),但列出前缀下的所有候选,还需要遍历和输出结果。Trie 的节点和连接也有开销,不能因为共享前缀,就认定它一定比哈希集合省内存。
知识点详解:同一条路径,可以有不止一个单词结束
根节点不代表第一个字符
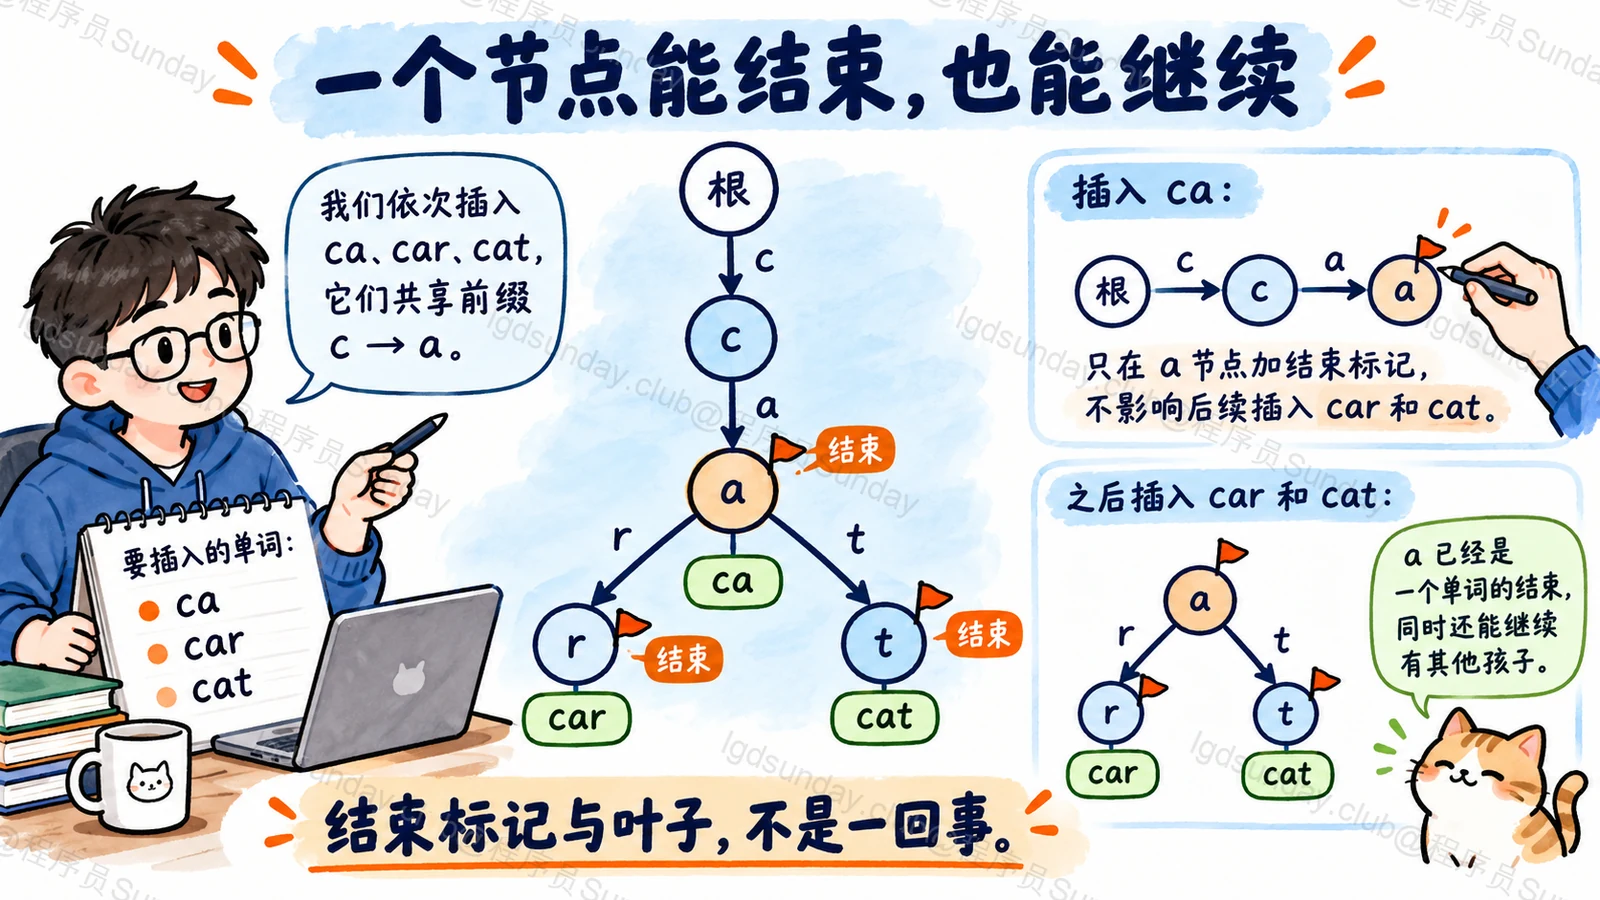
咱们假设词库只有 car、cat 和 dog。
根节点的下一层可以有 c 和 d。从 c 继续走 a,再分成 r 与 t,就分别得到 car 和 cat。两个词共享 ca,但最终结束在不同位置。
根节点本身通常不保存一个真实字符,它表示尚未读取任何字符的起点。边上选择哪个字符,决定接下来走到哪个节点。
实现时可以使用固定数组,也可以用 Map 或字典保存孩子。固定 26 个小写字母时,数组比较直接;字符范围较大时,每个节点都开一份巨大的字符数组就不合适了。
end 标记为什么不能省?
只插入 car,查询 ca 时,路径确实存在。但这条路径只是 car 的前两步,没有证据说明 ca 本身也被插入过。
所以,search 最后还要看 end。再插入 ca,就把 a 节点标成 end;car 对应的 r 仍然留着,也仍然是结束节点。
一个节点可以“这里是一个词的结尾”,同时“后面还有更长的词”。不要把叶子和单词结尾强行等同。
用稀疏孩子表实现
下面用 Unicode 码点逐项遍历,两种语言都不做大小写归一、Unicode 规范化或分词。空串作为扩展约定可以插入到根;空前缀视为有效路径,即使词库为空也返回真。常见题目只允许非空小写字母,这些扩展需要主动说清。
class TrieNode {
  children = new Map<string, TrieNode>();
  end = false;
}

class Trie {
  private root = new TrieNode();

  private find(text: string): TrieNode | undefined {
    let node = this.root;
    for (const ch of text) {
      const child = node.children.get(ch);
      if (!child) return undefined;
      node = child;
    }
    return node;
  }

  insert(word: string): void {
    let node = this.root;
    for (const ch of word) {
      let child = node.children.get(ch);
      if (!child) {
        child = new TrieNode();
        node.children.set(ch, child);
      }
      node = child;
    }
    node.end = true;
  }

  search(word: string): boolean { return this.find(word)?.end ?? false; }
  startsWith(prefix: string): boolean { return this.find(prefix) !== undefined; }
}
class TrieNode:
def __init__(self):
self.children = {}
self.end = False
class Trie:
def __init__(self):
self.root = TrieNode()
def _find(self, text):
node = self.root
for ch in text:
node = node.children.get(ch)
if node is None:
return None
return node
def insert(self, word):
node = self.root
for ch in word:
if ch not in node.children:
node.children[ch] = TrieNode()
node = node.children[ch]
node.end = True
def search(self, word):
node = self._find(word)
return node is not None and node.end
def starts_with(self, prefix):
return self._find(prefix) is not Noneinsert 重复单词只会重复设置 end,不会凭空增加一份计数。需要统计词频时,应另设计数器,不能从布尔标记里推导出现次数。
前缀找到了,不代表候选已经返回了
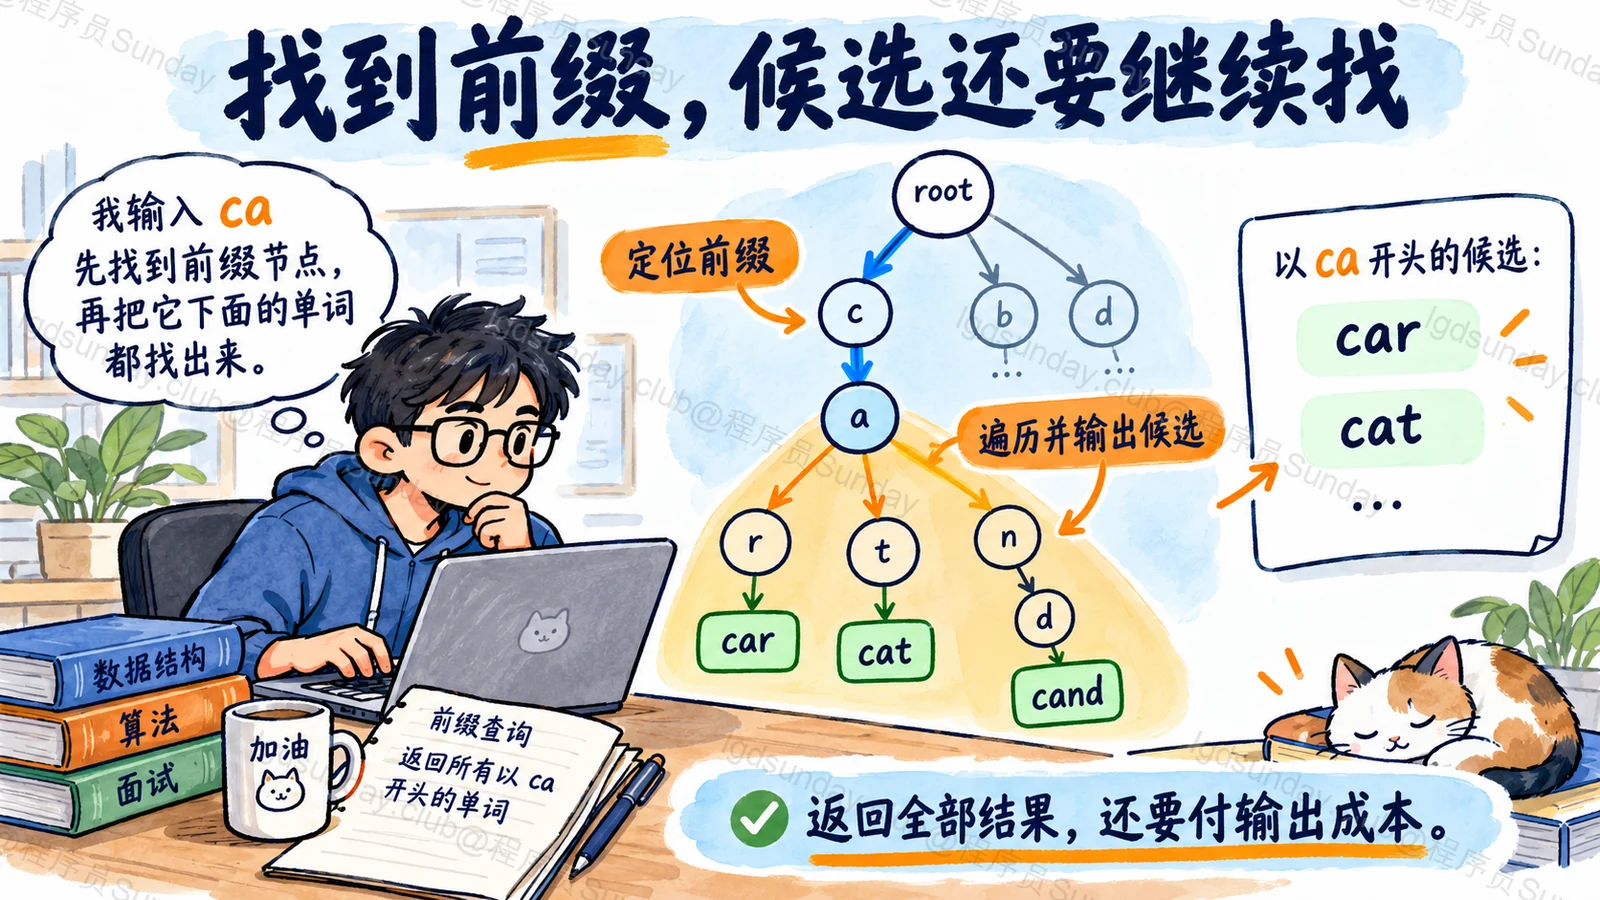
假设自动补全输入 ca,先定位到 a 节点,再往下枚举到带 end 的节点,才得到 car、cat 等候选。
前一段查找的工作随前缀长度增长,后面的遍历却取决于子树和输出规模。百万个单词都有同一前缀时,返回所有单词不可能只花前缀那几个字符的时间。
产品一般还要规定候选数量、排序或词频。可以在节点维护有限候选,但会增加更新与存储成本。这些不是最小 Trie 自动附赠的功能。
基础接口定义可对照 LeetCode 208。它定义了插入、完整匹配和前缀匹配,不要求把自动补全产品的全部能力都塞进一个类。
面试官继续追问
删除一个单词,可以直接删整条路径吗?
不可以,共享前缀可能还属于其他单词。先清除结束标记,再只回收没有孩子、也不是其他词结尾的节点;如果支持重复插入计数,还要先更新计数。
中文和 emoji 都能直接查吗?
当前 Map 实现能按码点存路径,但看起来相同的文字可能有不同编码,emoji 也可能由多个码点组成。是否规范化、按什么单位匹配,需要与产品规则一致。
只有完整单词查询,还值得用 Trie 吗?
哈希集合可能更简单。Trie 的主要优势在前缀结构和逐字符匹配;仍要比较实际字符串规模、共享程度和节点开销,不能只看大 O 就认定一定更快。
面试速记卡
- 结构:相同前缀共享路径,孩子表决定下一字符。
- 完整匹配:路径存在,并且最后节点 end 为真。
- 前缀匹配:路径存在即可,不要求在这里结束。
- 查询成本:定位前缀 O(L),列出候选另算遍历与输出。
- 删除边界:保留共享路径;频率、规范化与排序需要额外设计。
公司面试真题
真题根据求职者公开面经整理,题意经过概括,非逐字原话或公司官方题库;本文为 Sunday 的独立解析。
字节跳动 · 前端 · 校招
怎样设计电话号码智能提示的数据结构,在输入前缀后提示后续号码?(题意整理)
字节幸福里校招前端面经 1面+2面+3面+hr面(已意向) ↗
面试记录为 2021 年秋招;原帖编辑于 2021-10-09知乎 · 开发(监控组;原帖未明确细分岗位) · 25秋招(原帖标题)
前缀树是什么,有哪些使用场景?(题意整理)
25秋招 - 后端(主Go) - 面经分享&经历回顾 Part.1 ↗
原帖发布于 2025-04-17