
合并 K 个有序链表怎么做?最小堆和分治有什么区别?
下面是用于讲题的模拟面试对话。
🧑💻 面试官: K 条升序链表合成一条,怎么做?
🙋♂️ 我: 每次在 K 个头节点里找最小的,再向后推进。
🧑💻 面试官: 每输出一个节点都扫 K 个头,复杂度呢?
🙋♂️ 我: 会有 O(NK) 的上界,可以用最小堆,或者两两分治合并。
🧑💻 面试官: 堆里放所有节点,还是只放各链当前的一个头?分治又为什么要成对,而不一直往同一条长链里合?
利用每条链已经有序的条件,别重复比较不可能成为下一个最小值的节点。
面试速答(60 秒版)
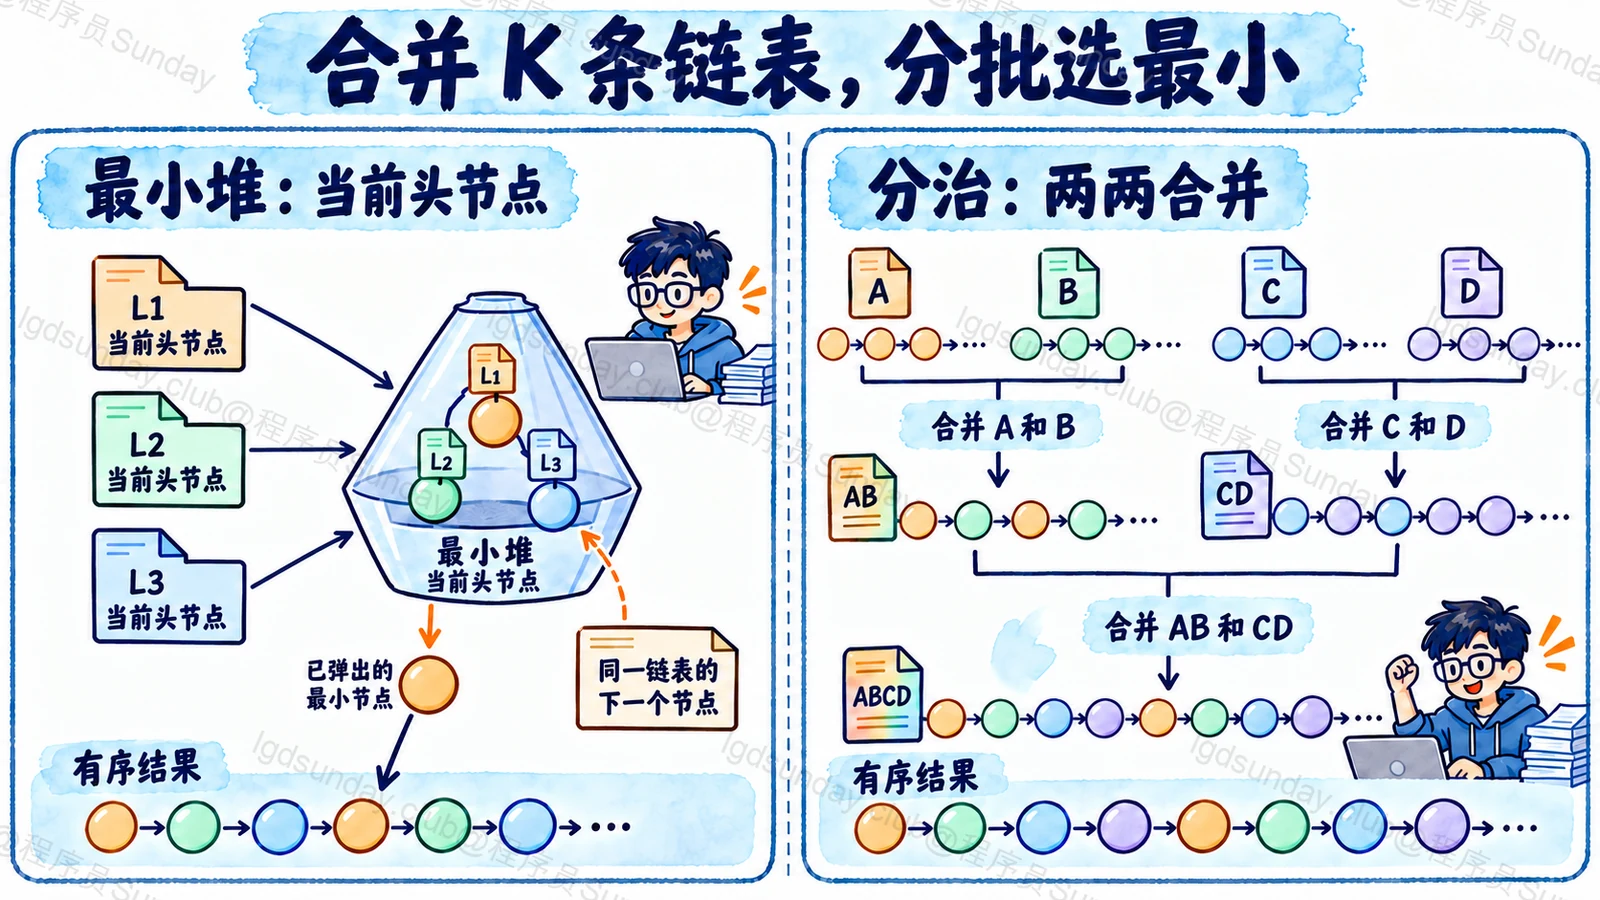
设总节点数为 N,链表数为 K。最小堆可以保存每条非空链当前的头节点,每次取全局最小的一个,并把它的后继放回堆。堆最多保留 K 个候选,每个节点进入和离开一次。
另一种是分治,两两合并,再把合并结果继续成对处理。平衡合并层数是 O(log K),每层最多处理全部节点,避免反复让同一条越来越长的结果与短链合并。
通常讨论的节点处理时间为 O(N log K),若把空链表头的扫描也计入,还要加 O(K)。两者都可以复用节点,但会改变原 next 关系,需要说清副作用。
本文实现迭代分治,避免假装 TypeScript 自带某个堆 API。空链、重复值、节点完整性,以及输入链是否独立无环,都要检查。
知识点详解:下一节点只会来自哪几个位置?
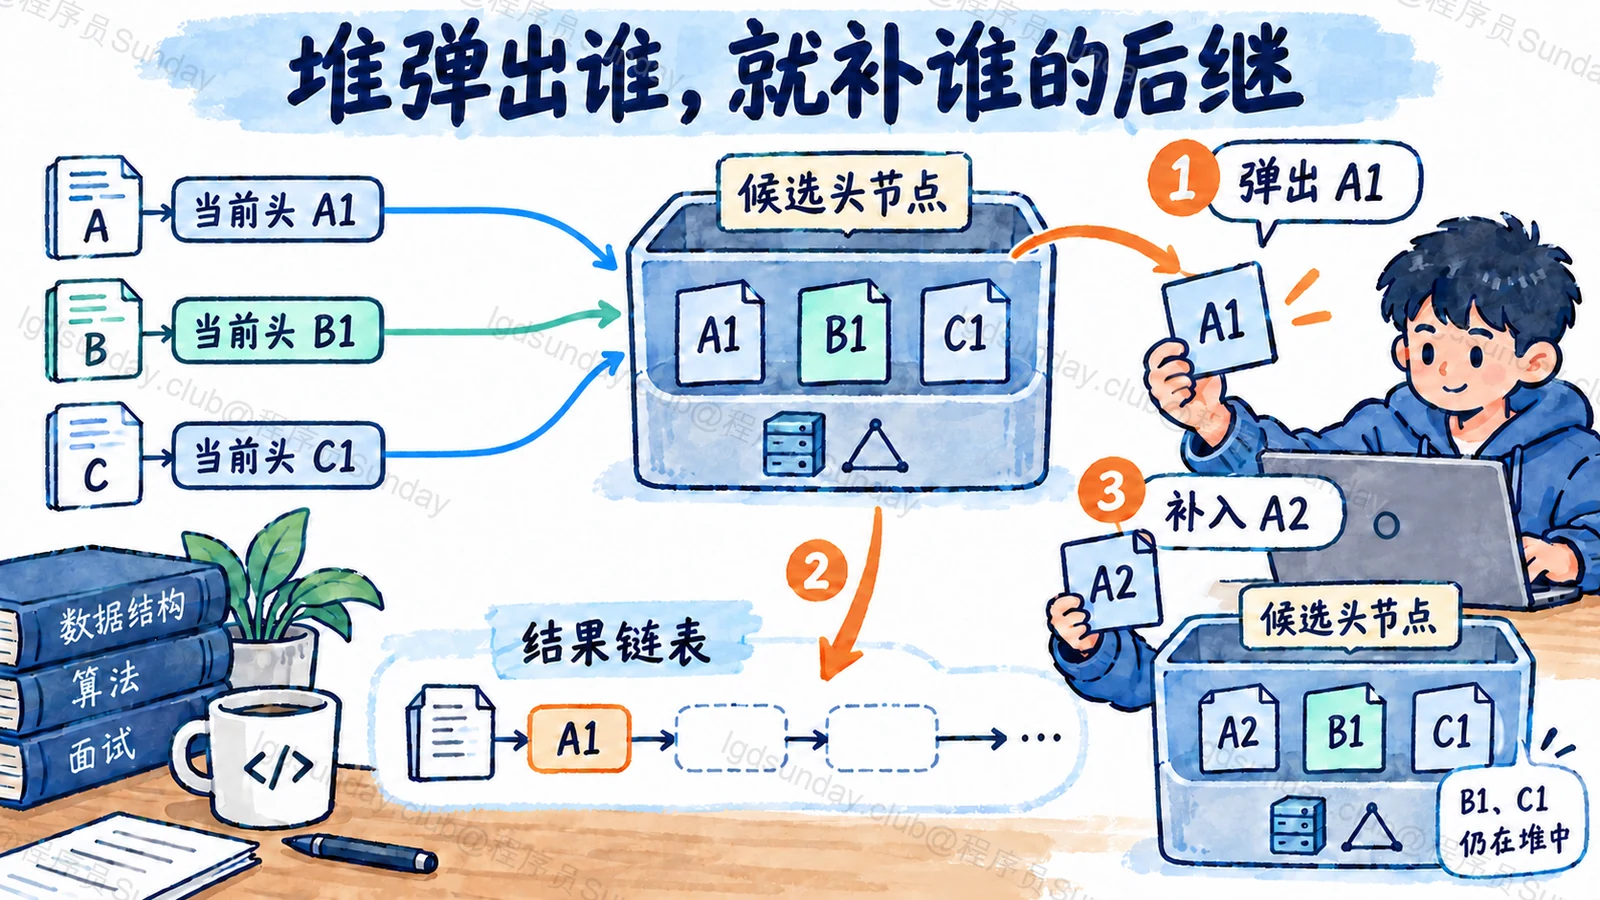
堆里只需要各条链当前的头
假设一条链是 2→8,在 2 没被取走前,8 不可能先于 2 成为全局下一个最小值。
所以没必要把全部节点一次性放进堆。每条链先给出一个候选,取走以后补入它的后继,就能持续保留正确的竞争集合。LeetCode 23 原题保证各输入链已经升序。
Python 可用 heapq 实现这条路径,重复值时还应考虑元组的后续比较字段,不能让堆意外比较两个不可排序节点。heapq 官方文档给出了优先队列的平局处理方法。
成对合并,避免一个结果被反复全量扫描
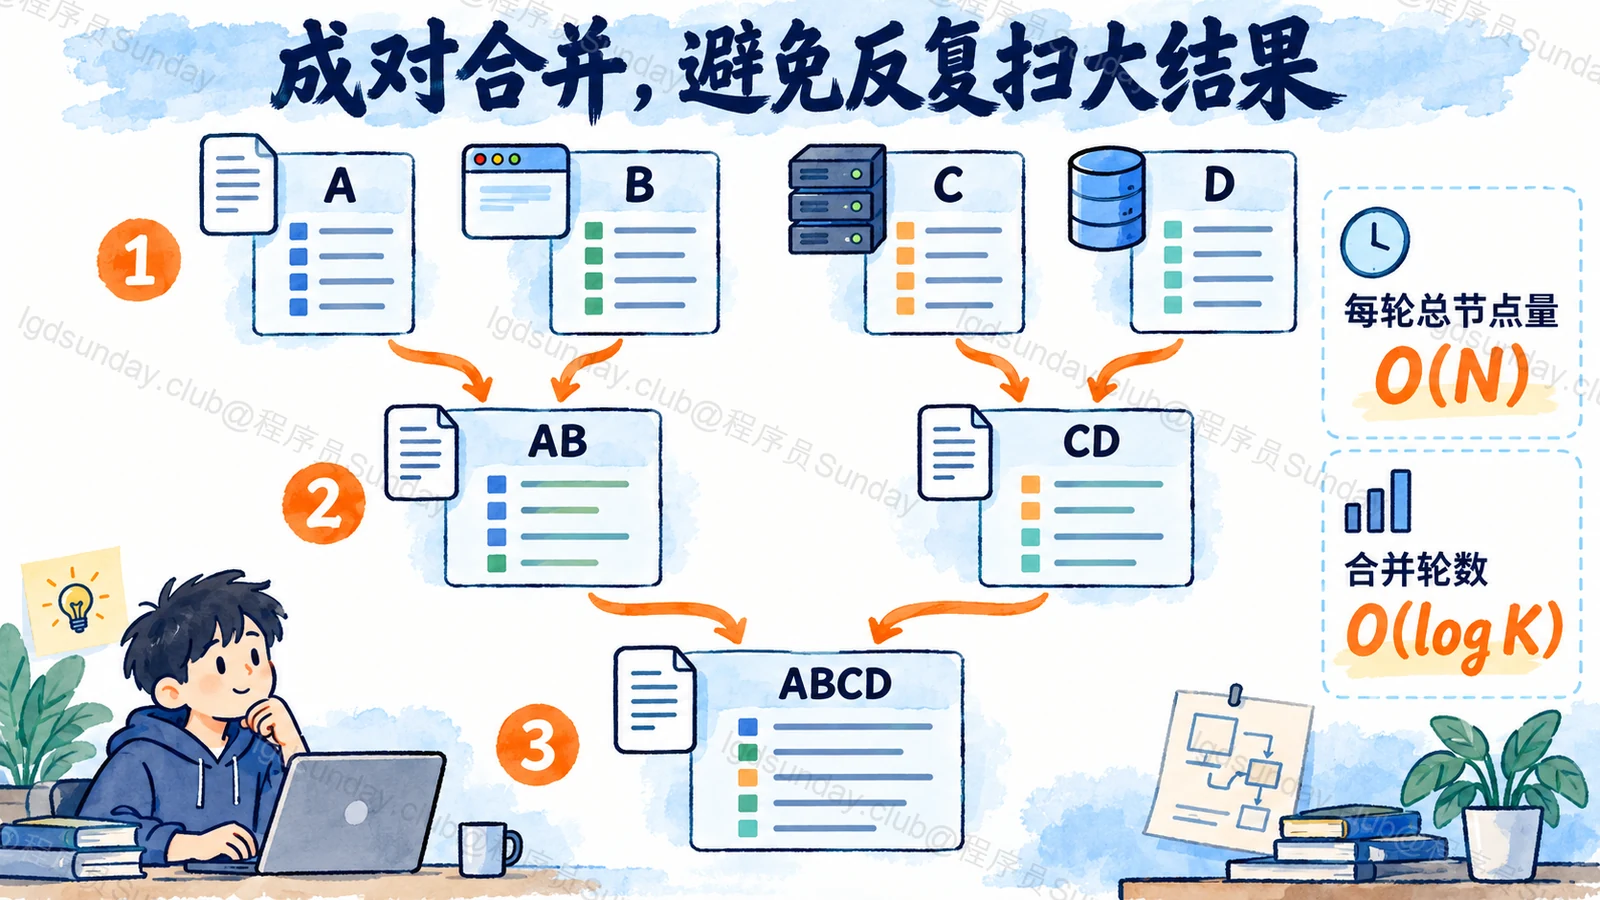
把 K 条链依次塞进同一个结果,前面节点会在后面越来越多次合并中被重新经过。
平衡合并则把它们组织成树:先合相邻两条,再合相邻两份结果。每一层处理的节点总量不超过 N,层数约为 log K。
| 方案 | 维护的核心信息 | 适合解释的判断 |
|---|---|---|
| 最小堆 | 各链当前候选 | 每次全局最小来自哪个头 |
| 平衡分治 | 一层层有序合并结果 | 每层处理总量与合并层数 |
两者不是“一个必然更快”。对象开销、输入长度分布、是否流式,以及实际堆实现都会影响表现。
双语代码使用同一条分治路线
代码复制链表头数组,但复用并修改原节点。假设各链无环且不共享节点;如果要保留原链,需要另外复制节点。
class ListNode {
  constructor(public value: number, public next: ListNode | null = null) {}
}

function mergeTwo(a: ListNode | null, b: ListNode | null): ListNode | null {
  const dummy = new ListNode(0);
  let tail = dummy;
  while (a !== null && b !== null) {
    if (a.value <= b.value) { tail.next = a; a = a.next; }
    else { tail.next = b; b = b.next; }
    tail = tail.next;
  }
  tail.next = a ?? b;
  return dummy.next;
}

function mergeKLists(lists: (ListNode | null)[]): ListNode | null {
  const work = lists.slice();
  for (let step = 1; step < work.length; step *= 2) {
    for (let i = 0; i + step < work.length; i += step * 2) {
      work[i] = mergeTwo(work[i], work[i + step]);
    }
  }
  return work[0] ?? null;
}
class ListNode:
def __init__(self, value: int, next_node=None):
self.value, self.next = value, next_node
def merge_two(a, b):
dummy = ListNode(0)
tail = dummy
while a is not None and b is not None:
if a.value <= b.value:
tail.next, a = a, a.next
else:
tail.next, b = b, b.next
tail = tail.next
tail.next = a if a is not None else b
return dummy.next
def merge_k_lists(lists):
work = list(lists)
step = 1
while step < len(work):
for i in range(0, len(work) - step, step * 2):
work[i] = merge_two(work[i], work[i + step])
step *= 2
return work[0] if work else None辅助头数组占 O(K),节点本体没有重新创建一整份。若不复制输入头数组,可以减少这部分副本,但会改变调用者数组里的入口,需要明确约定。
面试官继续追问
为什么要说明输入节点不共享?
若两条链已经共享尾部,同一个节点可能被重复接入,常规原地合并甚至可能形成环。这不符合这里的独立链表前提,不能只检查值排序就忽略节点身份。
怎么验证?
把所有输入值收集并排序作结果基准,再检查输出节点恰好出现一次、没有环。测试 K=0、全空、长度悬殊和重复值,并把“是否允许修改原节点”写在接口约定里。
面试速记卡
- 最小堆:各非空链保留一个当前候选,取走后补后继。
- 分治:平衡两两合并,每层总处理量不超过 N。
- 时间:节点处理 O(N log K),含头扫描再计 O(K)。
- 本文空间:复制头数组 O(K),复用节点而非复制全部节点。
- 前提:独立无环链表;原地修改与节点身份要明确。
公司面试真题
真题根据求职者公开面经整理,题意经过概括,非逐字原话或公司官方题库;本文为 Sunday 的独立解析。
瀚博半导体 · GPU驱动开发 · 原帖未明确批次
怎样合并多个有序链表?(题意整理)
瀚博半导体GPU驱动开发一面面经 ↗
原帖发布于 2023-03-24