
二叉树如何序列化和反序列化?为什么只保存遍历值还不够?
下面是用于讲题的模拟面试对话。
🧑💻 面试官: 把二叉树先序遍历的值存起来,就能恢复原树吗?
🙋♂️ 我: 不够,只存值会丢掉空孩子的位置。
🧑💻 面试官: 根是 7、孩子是 3,3 在左边和在右边,先序值是不是都一样?
🙋♂️ 我: 都是 7、3,需要额外保存结构。
🧑💻 面试官: 那加上 null 以后,解析器怎么知道什么时候完成一棵子树,坏输入又怎么处理?
序列化要保存“值和形状”。先序格式中,每个非空节点后面都必须接一棵左子树和一棵右子树,空位置也算一个明确标记。
面试速答(60 秒版)
可以用带空标记的先序遍历:先写节点值,再写左子树和右子树;遇到空指针写 null。只写值无法区分不同树形,加上空位置才能恢复结构。
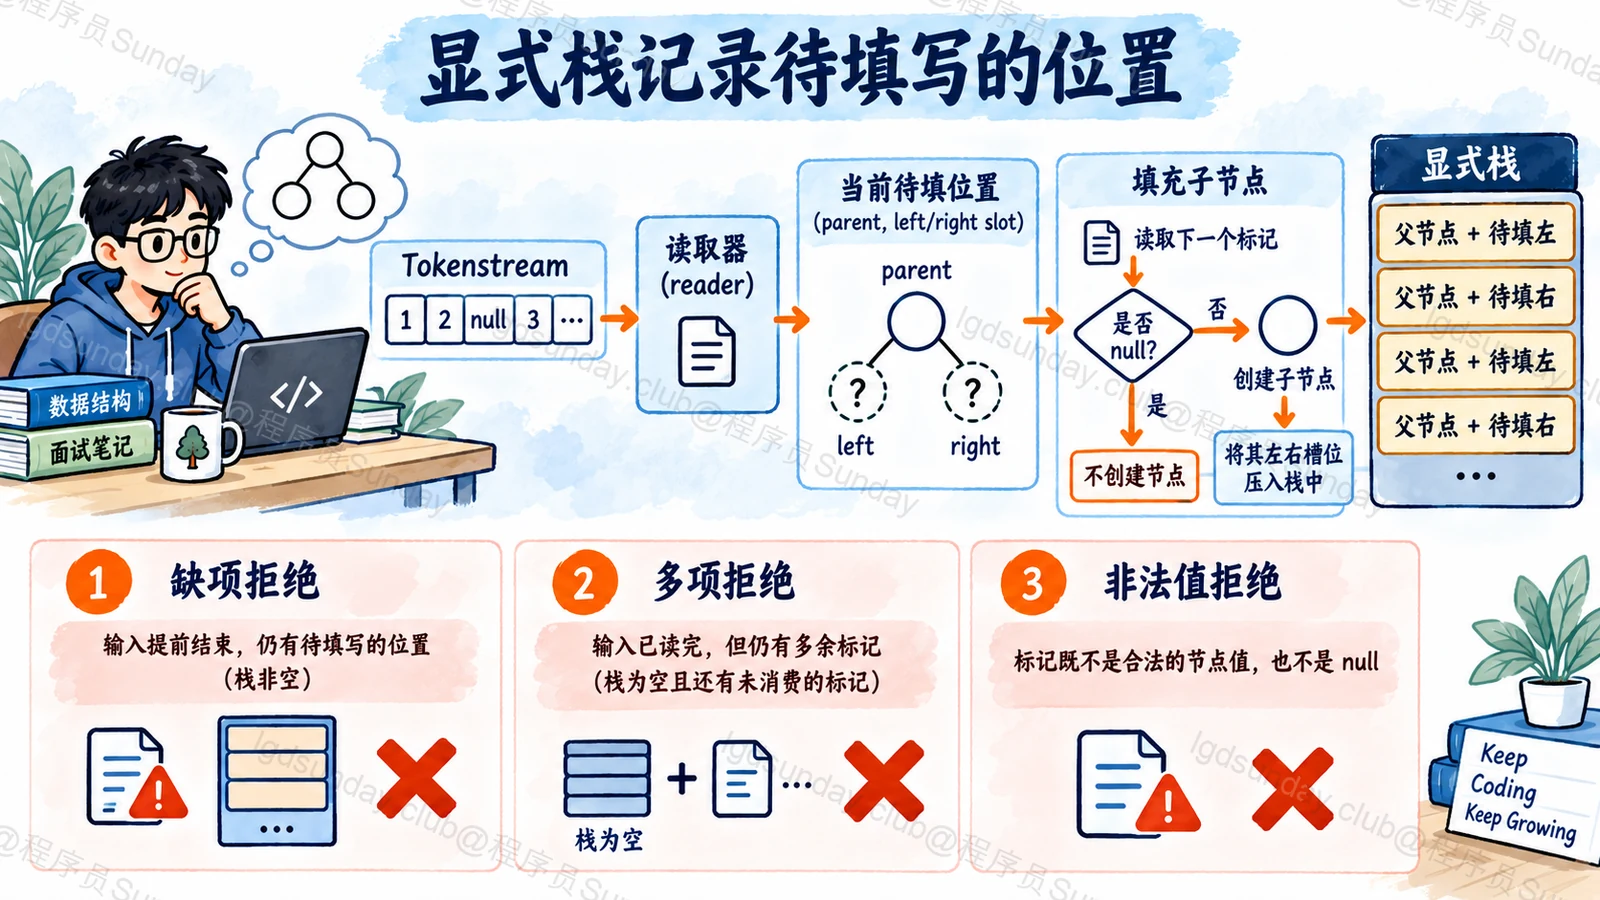
反序列化用一个不断前进的游标。读到 null 就得到空子树;读到值则创建节点,再按相同顺序恢复左右子树。可以按递归模型理解,实际用显式栈记录待填写的左右位置,不用在每层复制数组。
遍历时间 O(n),输出占 O(n),遍历栈占 O(h)。本文用显式栈,避免深链状树超过语言调用栈,而不是把“递归写得短”当成无深度限制。
格式还要定义数值范围、空标记和非法输入。解析结束时不能缺项,也不能偷偷忽略多余尾项。若用于外部接口,还需限制长度和深度。
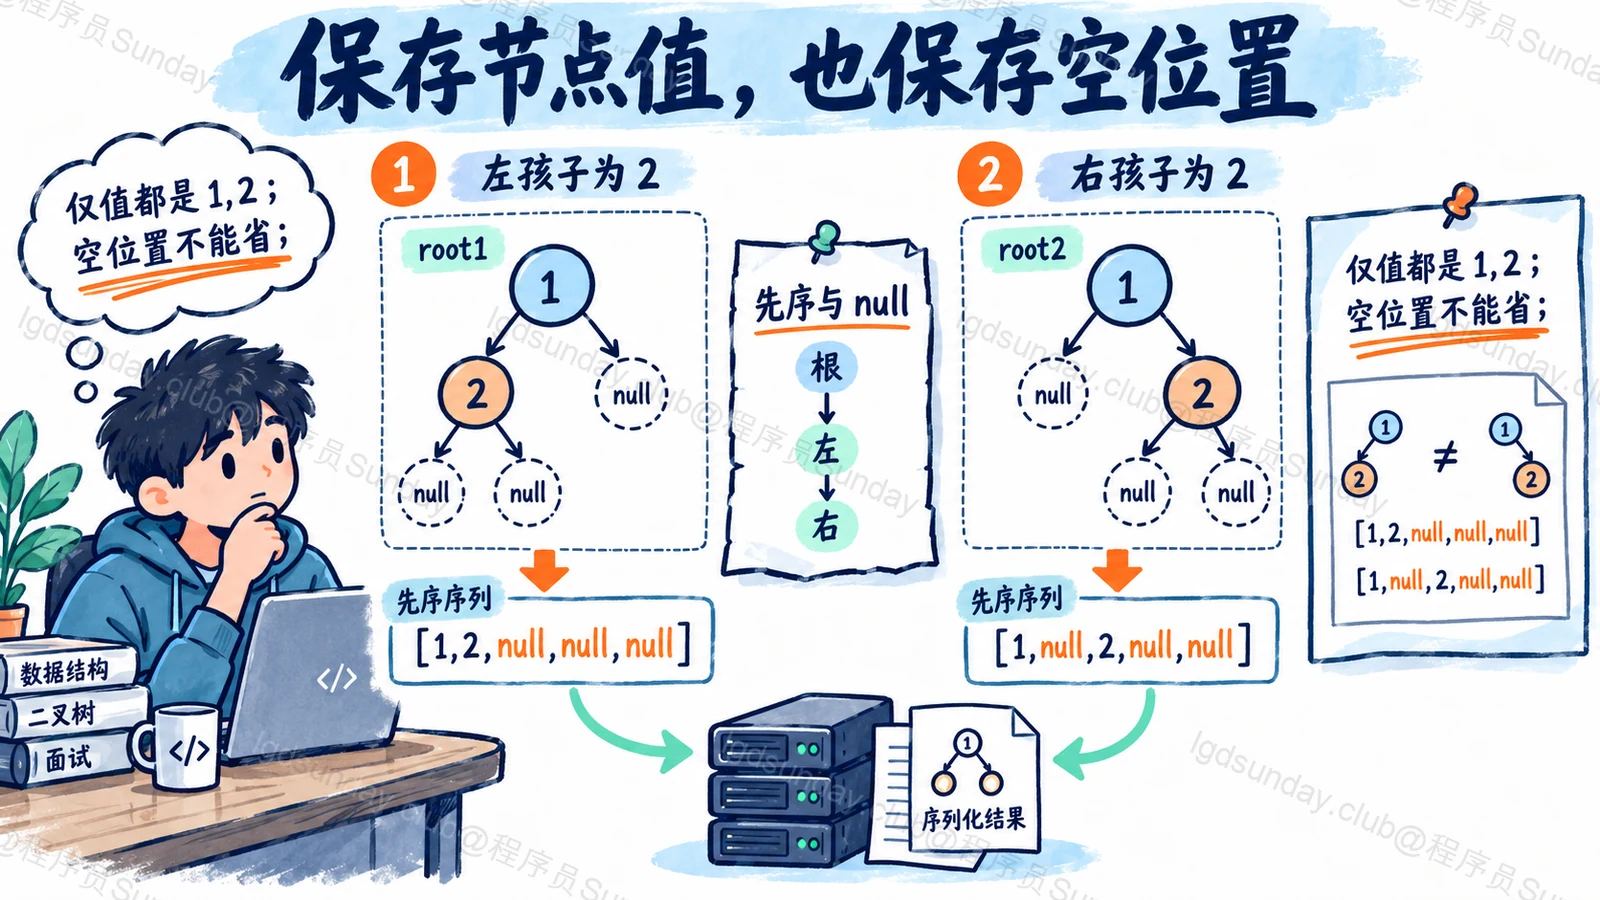
知识点详解:让空位置也参与遍历
两个值相同,不代表两棵树相同
根 7 的左孩子是 3,与根 7 的右孩子是 3,只存先序值都得到 [7,3]。
加上 null 后,前者是 [7,3,null,null,null],后者是 [7,null,3,null,null]。差别来自空位置,不是给节点另外发了编号。LeetCode 297 原题允许自行设计可恢复原结构的格式。
下面使用 JSON 数组承载这串先序标记,不是题库页面常见的层序数组格式。格式自由不代表两者可以混着解析。
每个值后面,递归读取两棵子树
假设游标刚读到 7。接下来的内容交给左子树读取函数,它会自己读到那棵子树结束;然后才轮到右子树。
null 让空子树也有明确结束。每项只消费一次,所以不用每读一个值就扫描剩余数组寻找分界。
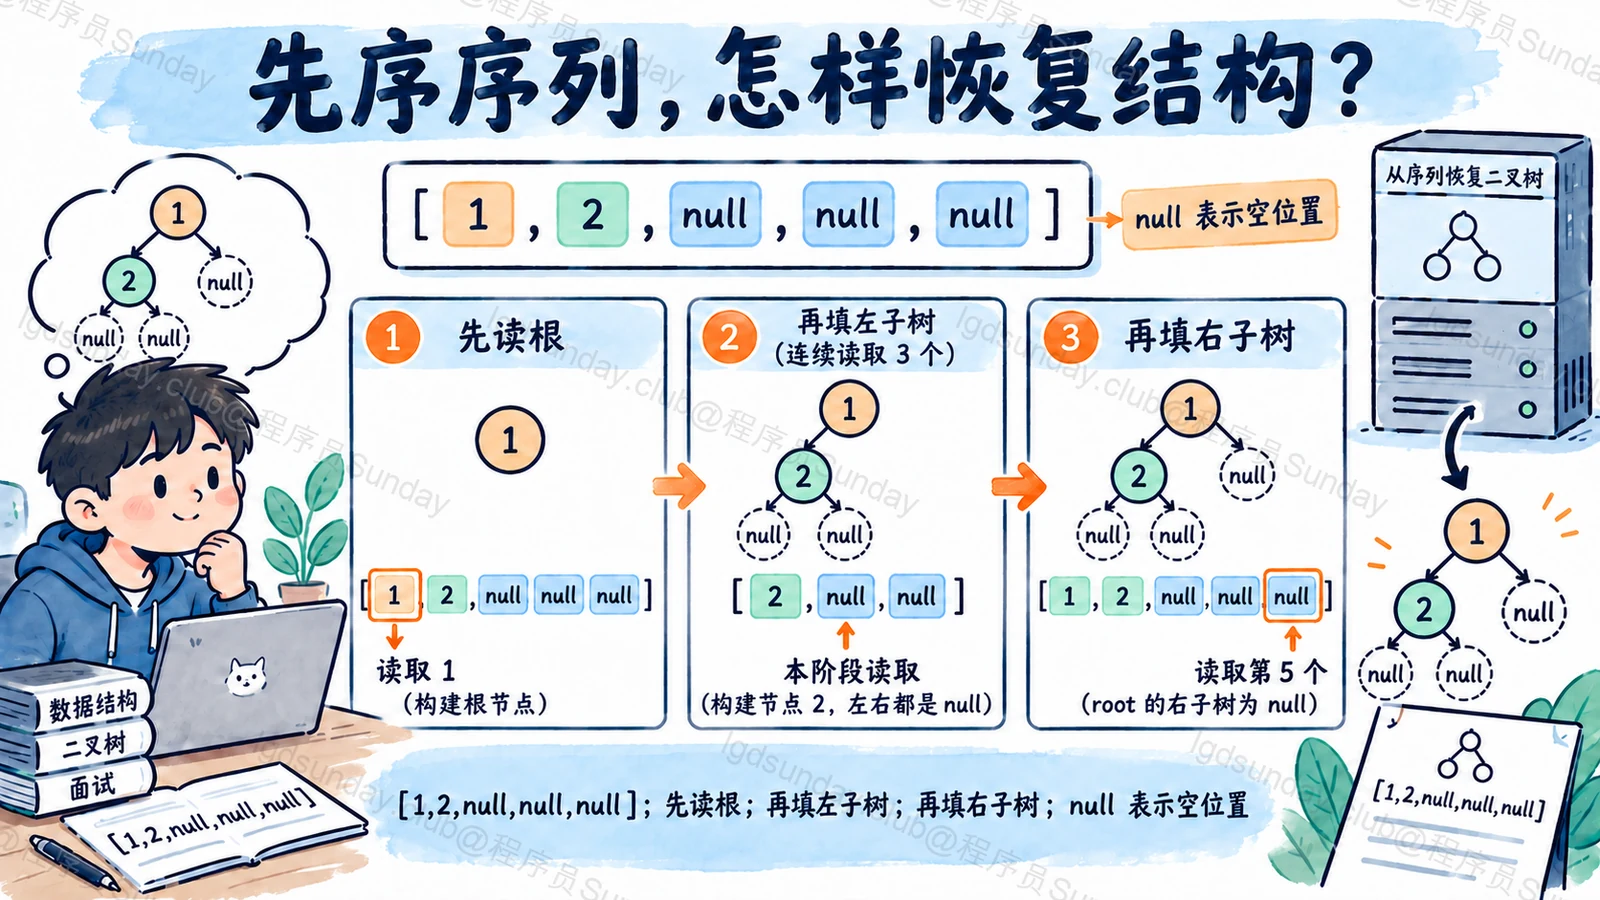
双语实现,用显式栈保留待填写位置
示例约定节点值为 JS 安全整数范围内的整数,树没有环,也没有共享节点。它是面试格式,不是无界不可信数据的通用解析器。
class TreeNode {
  left: TreeNode | null = null;
  right: TreeNode | null = null;
  constructor(public value: number) {}
}

function serialize(root: TreeNode | null): string {
  const tokens: (number | null)[] = [];
  const stack: (TreeNode | null)[] = [root];
  while (stack.length > 0) {
    const node = stack.pop()!;
    if (node === null) { tokens.push(null); continue; }
    tokens.push(node.value);
    stack.push(node.right, node.left);
  }
  return JSON.stringify(tokens);
}

function deserialize(data: string): TreeNode | null {
  const parsed: unknown = JSON.parse(data);
  if (!Array.isArray(parsed)) throw new Error("需要数组");
  const tokens: unknown[] = parsed;
  let index = 0;
  function read(): TreeNode | null {
    if (index >= tokens.length) throw new Error("结构缺项");
    const token: unknown = tokens[index++];
    if (token === null) return null;
    if (typeof token !== "number" || !Number.isSafeInteger(token)) {
      throw new Error("节点值无效");
    }
    const node = new TreeNode(token);
    return node;
  }
  const root = read();
  const stack: [TreeNode, 0 | 1][] = root === null ? [] : [[root, 0]];
  while (stack.length > 0) {
    const [parent, side] = stack.pop()!;
    const child = read();
    if (side === 0) {
      parent.left = child;
      stack.push([parent, 1]);
    } else parent.right = child;
    if (child !== null) stack.push([child, 0]);
  }
  if (index !== tokens.length) throw new Error("存在多余项");
  return root;
}
import json
class TreeNode:
def __init__(self, value: int):
self.value = value
self.left = None
self.right = None
def serialize(root) -> str:
tokens = []
stack = [root]
while stack:
node = stack.pop()
if node is None:
tokens.append(None)
continue
tokens.append(node.value)
stack.extend((node.right, node.left))
return json.dumps(tokens, separators=(",", ":"))
def deserialize(data: str):
tokens = json.loads(data)
if not isinstance(tokens, list):
raise ValueError("需要数组")
index = 0
def read():
nonlocal index
if index >= len(tokens):
raise ValueError("结构缺项")
token = tokens[index]
index += 1
if token is None:
return None
if type(token) is not int or abs(token) > 2**53 - 1:
raise ValueError("节点值无效")
return TreeNode(token)
root = read()
stack = [] if root is None else [(root, 0)]
while stack:
parent, side = stack.pop()
child = read()
if side == 0:
parent.left = child
stack.append((parent, 1))
else:
parent.right = child
if child is not None:
stack.append((child, 0))
if index != len(tokens):
raise ValueError("存在多余项")
return root序列化时先压右再压左,才能按先序取出左子树。恢复时,填完左孩子,先把父节点的右位置压回去,再进入左子树。空树也有一项 null,所以空数组在这套格式里是非法输入。
面试官继续追问
重复值会妨碍恢复吗?
不会靠值去找唯一分界,结构由先序规则与空标记共同决定,所以重复值也可以处理。测试应比较节点值和左右关系,而不是只比较遍历值集合。
为什么不直接写递归?
递归最容易解释这套协议,但很深的链可能超过运行时调用栈,Python 尤其需要注意。本文用递归关系讲解、显式栈实现。它仍然消耗内存,不代表外部输入可以无限大,长度和节点数边界要另外限制。
面试速记卡
- 信息:遍历值之外,还要保存空位置等结构。
- 协议:先序的值、左子树、右子树,与层序格式不同。
- 解析:一个游标单向消费,非空节点再读取两棵子树。
- 验证:缺项、多余项、无效值和结构都要检查。
- 复杂度:时间 O(n)、输出 O(n)、显式栈 O(h),不依赖语言递归深度。
公司面试真题
真题根据求职者公开面经整理,题意经过概括,非逐字原话或公司官方题库;本文为 Sunday 的独立解析。
百度 · Agent开发 · 实习
怎样实现二叉树的序列化与反序列化?(题意整理)
9.7百度agent开发日常实习面经 ↗
标题记录 9 月 7 日面试,页面显示 09-07 发布;未明确年份