
二叉树前序、中序、后序遍历有什么区别?递归和迭代怎样实现?
下面是一段教学用的模拟面试。
🧑💻 面试官: 二叉树前序、中序、后序有什么区别?
🙋♂️ 我: 前序根左右,中序左根右,后序左右根。
🧑💻 面试官: 代码里哪一行的前后位置,决定了这三种顺序?
🙋♂️ 我: 访问当前节点的语句,放在左、右递归调用的不同位置。
🧑💻 面试官: 那中序遍历一定得到升序吗?树退化成一条链,递归空间还是 O(log n) 吗?
抓住「什么时候处理当前节点」。口诀描述顺序,树的结构决定结果和递归深度。
面试速答(60 秒版)
前序是在处理左右子树前访问当前节点;中序是在左子树之后、右子树之前访问;后序是在左右子树之后访问。
递归写法共享同一套子树处理结构,只是访问节点的位置不同。每个节点访问一次,时间 O(n);调用栈与树高有关,空间 O(h)。
中序升序需要二叉搜索树等相应前提,普通二叉树不保证。平衡树高度可能是 O(log n),但退化成链时高度可达 O(n)。
实际应用中,要按依赖选择顺序。比如结果需要先依赖两个子树的信息,就适合在后序位置处理,而不是只背三串字。
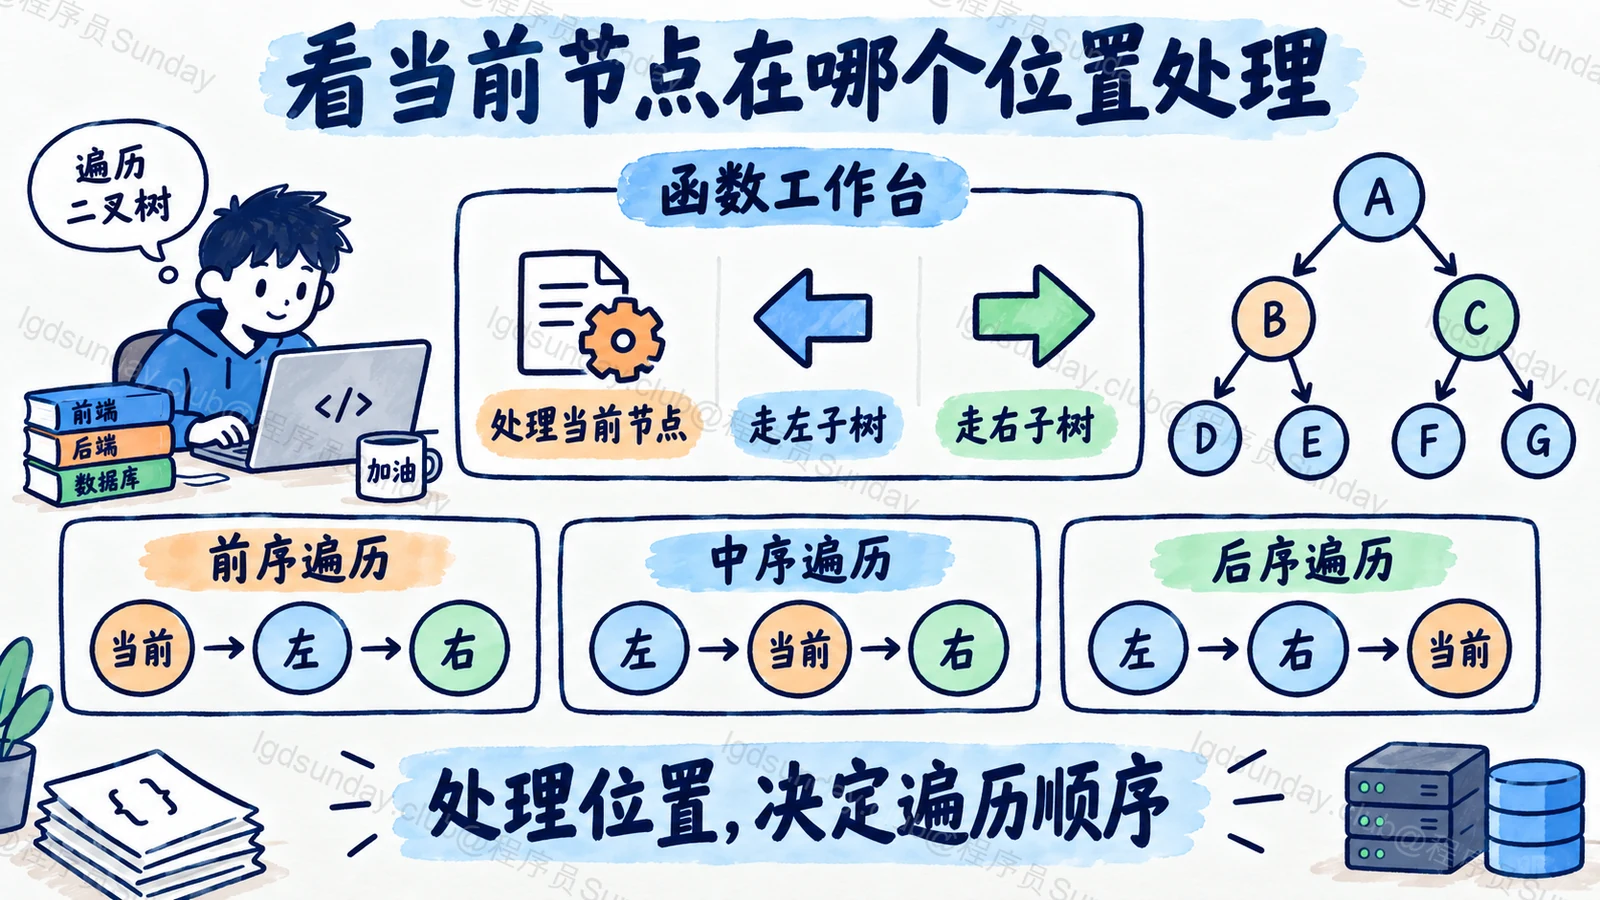
图:看当前节点在哪个位置处理。
知识点详解:递归有三个位置可以处理当前节点
先用一棵确定的树推一次
假设根是 A,左子节点 B、右子节点 C,B 又有左子节点 D。这里只讨论这四个节点。
前序得到 A、B、D、C;中序得到 D、B、A、C;后序得到 D、B、C、A。
三种顺序都不是把字母排序,而是按同一棵树访问。尤其 D、B、A、C 不升序,完全正常,因为我们并没有给这棵树二叉搜索树的性质。
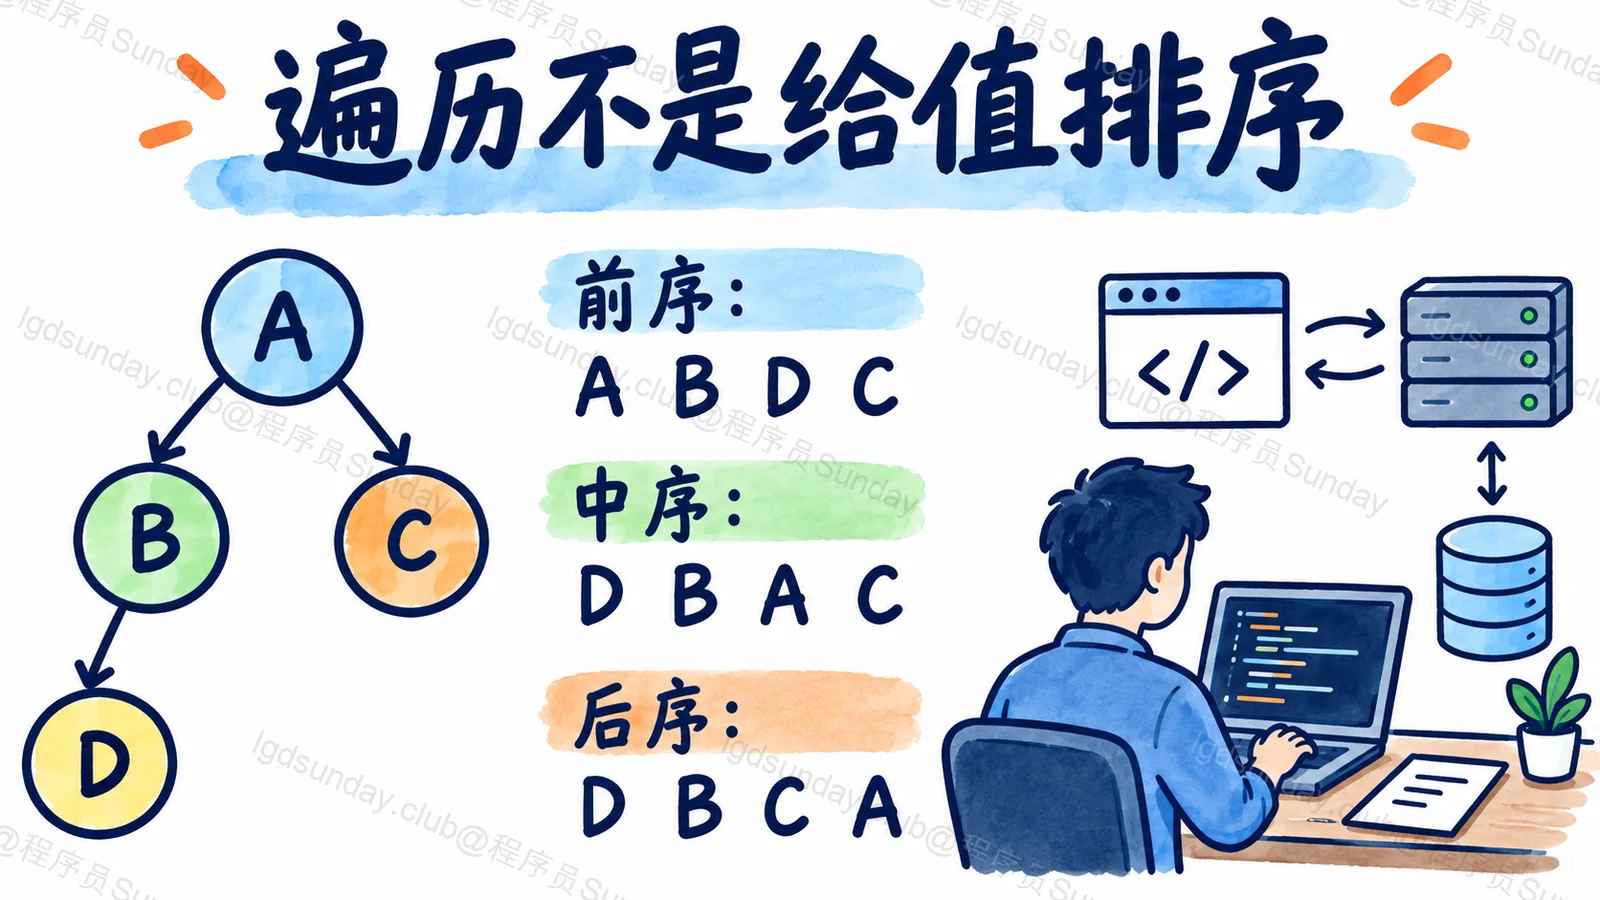
图:同一棵树,三种访问结果。
三个处理位置,怎样落到代码?
下面在一次递归里记录三份序列,便于比较位置。实际函数可以只保留需要的一份,不必每次生成全部结果。
type TreeNode = {
  value: string;
  left: TreeNode | null;
  right: TreeNode | null;
};
function traversals(root: TreeNode | null) {
  const pre: string[] = [], ino: string[] = [], post: string[] = [];
  function visit(node: TreeNode | null): void {
    if (node === null) return;
    pre.push(node.value);
    visit(node.left);
    ino.push(node.value);
    visit(node.right);
    post.push(node.value);
  }
  visit(root);
  return { pre, ino, post };
}
from dataclasses import dataclass
from typing import Optional
@dataclass
class TreeNode:
value: str
left: Optional["TreeNode"] = None
right: Optional["TreeNode"] = None
def traversals(root):
pre, ino, post = [], [], []
def visit(node):
if node is None:
return
pre.append(node.value)
visit(node.left)
ino.append(node.value)
visit(node.right)
post.append(node.value)
visit(root)
return {"pre": pre, "ino": ino, "post": post}当前节点在左递归之前、两次递归之间、右递归之后,都有一次处理机会。这三个位置比孤立背口诀更容易迁移到其他题。概念可对照 Hello 算法二叉树遍历。
迭代前序:自己管理那一份待访问栈
递归时,运行时替我们保存“接下来回到哪里”。迭代写法则把这份待访问状态放进自己的栈里。以前序为例,取出节点后先处理它,再把右孩子、左孩子依次压栈。因为左孩子后压入,所以会先弹出。
function preorder(root: TreeNode | null): string[] {
  const out: string[] = [];
  const stack: TreeNode[] = root ? [root] : [];
  while (stack.length > 0) {
    const node = stack.pop()!;
    out.push(node.value);
    if (node.right) stack.push(node.right);
    if (node.left) stack.push(node.left);
  }
  return out;
}
def preorder(root):
out = []
stack = [root] if root is not None else []
while stack:
node = stack.pop()
out.append(node.value)
if node.right is not None:
stack.append(node.right)
if node.left is not None:
stack.append(node.left)
return out这里具体演示前序,不是说把压栈顺序调一下,就能得到所有遍历。中序需要先沿左边一路入栈,再弹出处理、转向右边;后序还要记住右子树是否已经处理,或者用带访问阶段的栈项。顺序不同,保存的状态也会不同。
后序为什么常用于汇总?
假设要计算每个节点的子树大小。当前节点需要先知道左子树和右子树各有多少节点,再把它们加起来。
因此,先处理子树,再处理当前节点比较自然。这里的“后”不是慢一步,而是尊重数据依赖。
前序适合需要先记录当前节点、再继续向下的流程。中序则在满足二叉搜索树性质时,能服务有序访问,但这个性质必须另外成立。
递归空间怎样算?
同一时刻挂在调用栈上的,是一条从根向下的路径,不是全部节点同时入栈。因此,辅助调用栈通常为 O(h)。
平衡与退化树的 h 不一样。我们还要区分调用栈与输出数组:示例保存三份结果,输出本身是 O(n),不能说整个函数所有内存只有 O(h)。
树很深时,还可能触及运行时递归深度限制。迭代写法用显式栈表达过程,也需要正确维护处理位置,不能只是把递归关键字删掉。
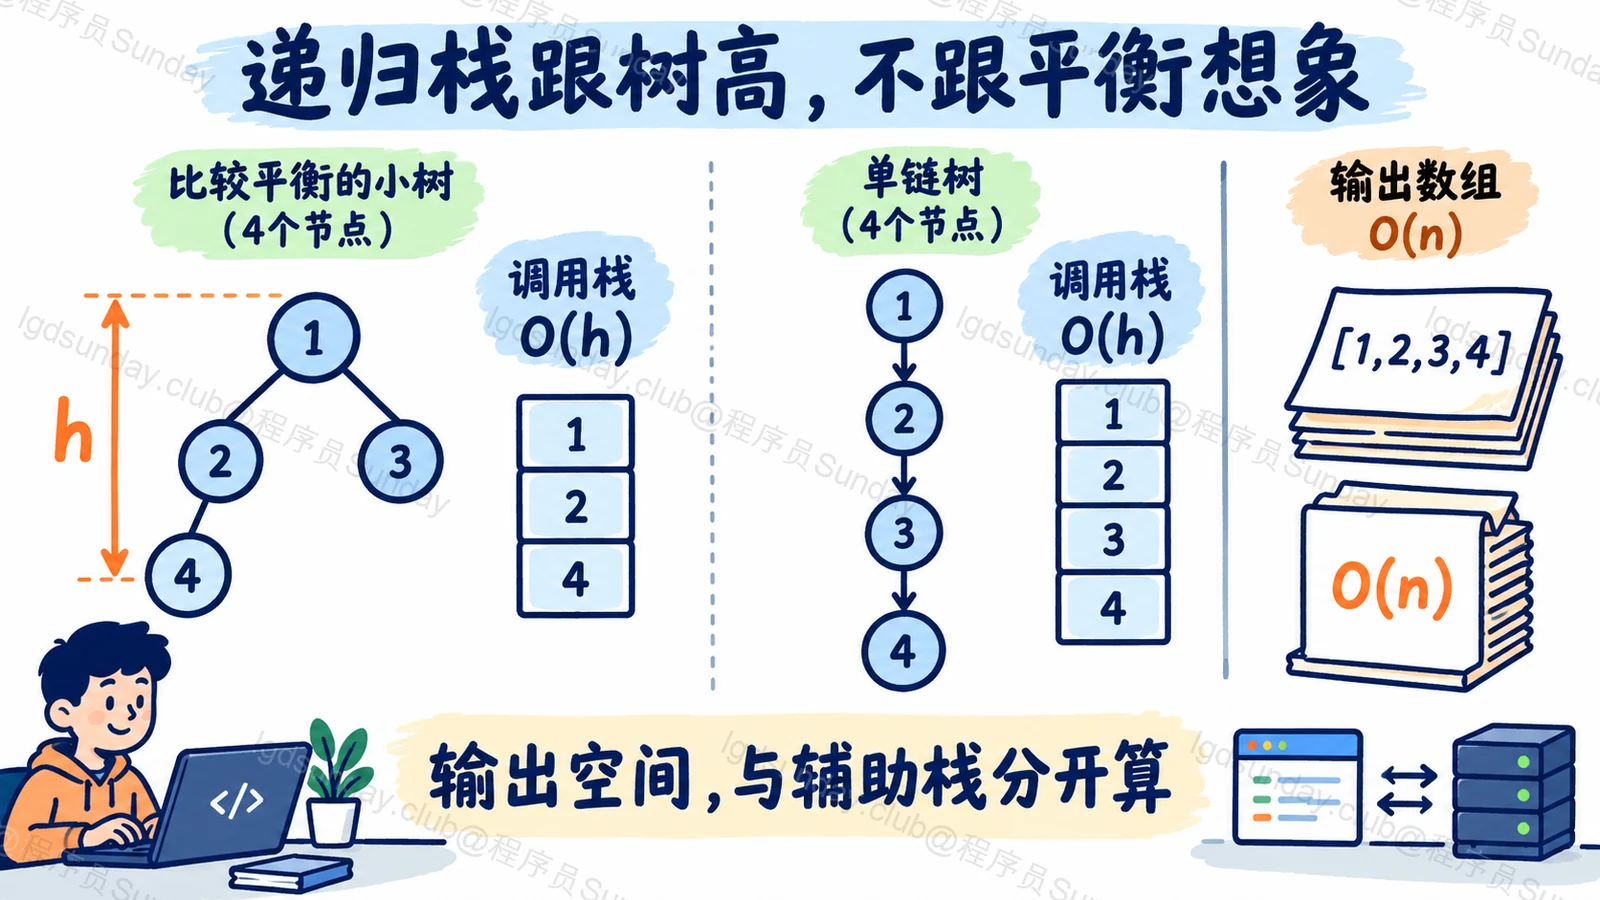
图:递归栈跟树高,不跟平衡想象。
面试官继续追问
中序一定能还原一棵树吗?
通常不能,单独一份中序会对应多种树结构。还原需要更多条件与序列信息。
空树与单节点怎样输出?
空树三份都是空;单节点三份都只有这个值。这些基础用例也应当验证,不只检查一棵漂亮的平衡树。
面试速记卡
- 前序:当前节点在左右递归之前处理。
- 中序:当前节点在两次递归之间处理。
- 后序:当前节点在左右递归之后处理。
- 复杂度:访问 O(n),调用栈 O(h),输出另算。
- 边界:普通二叉树中序不保证升序,退化树高可到 O(n)。
公司面试真题
真题根据求职者公开面经整理,题意经过概括,非逐字原话或公司官方题库;本文为 Sunday 的独立解析。
美团 · Java后端 · 实习
怎样手写非递归后序遍历?(题意整理)
4.21美团Java实习一二面面经 ↗
面试记录为 2020-04-21、2020-04-24;原帖编辑于 2020-11-14