
大家好,我是 Sunday。
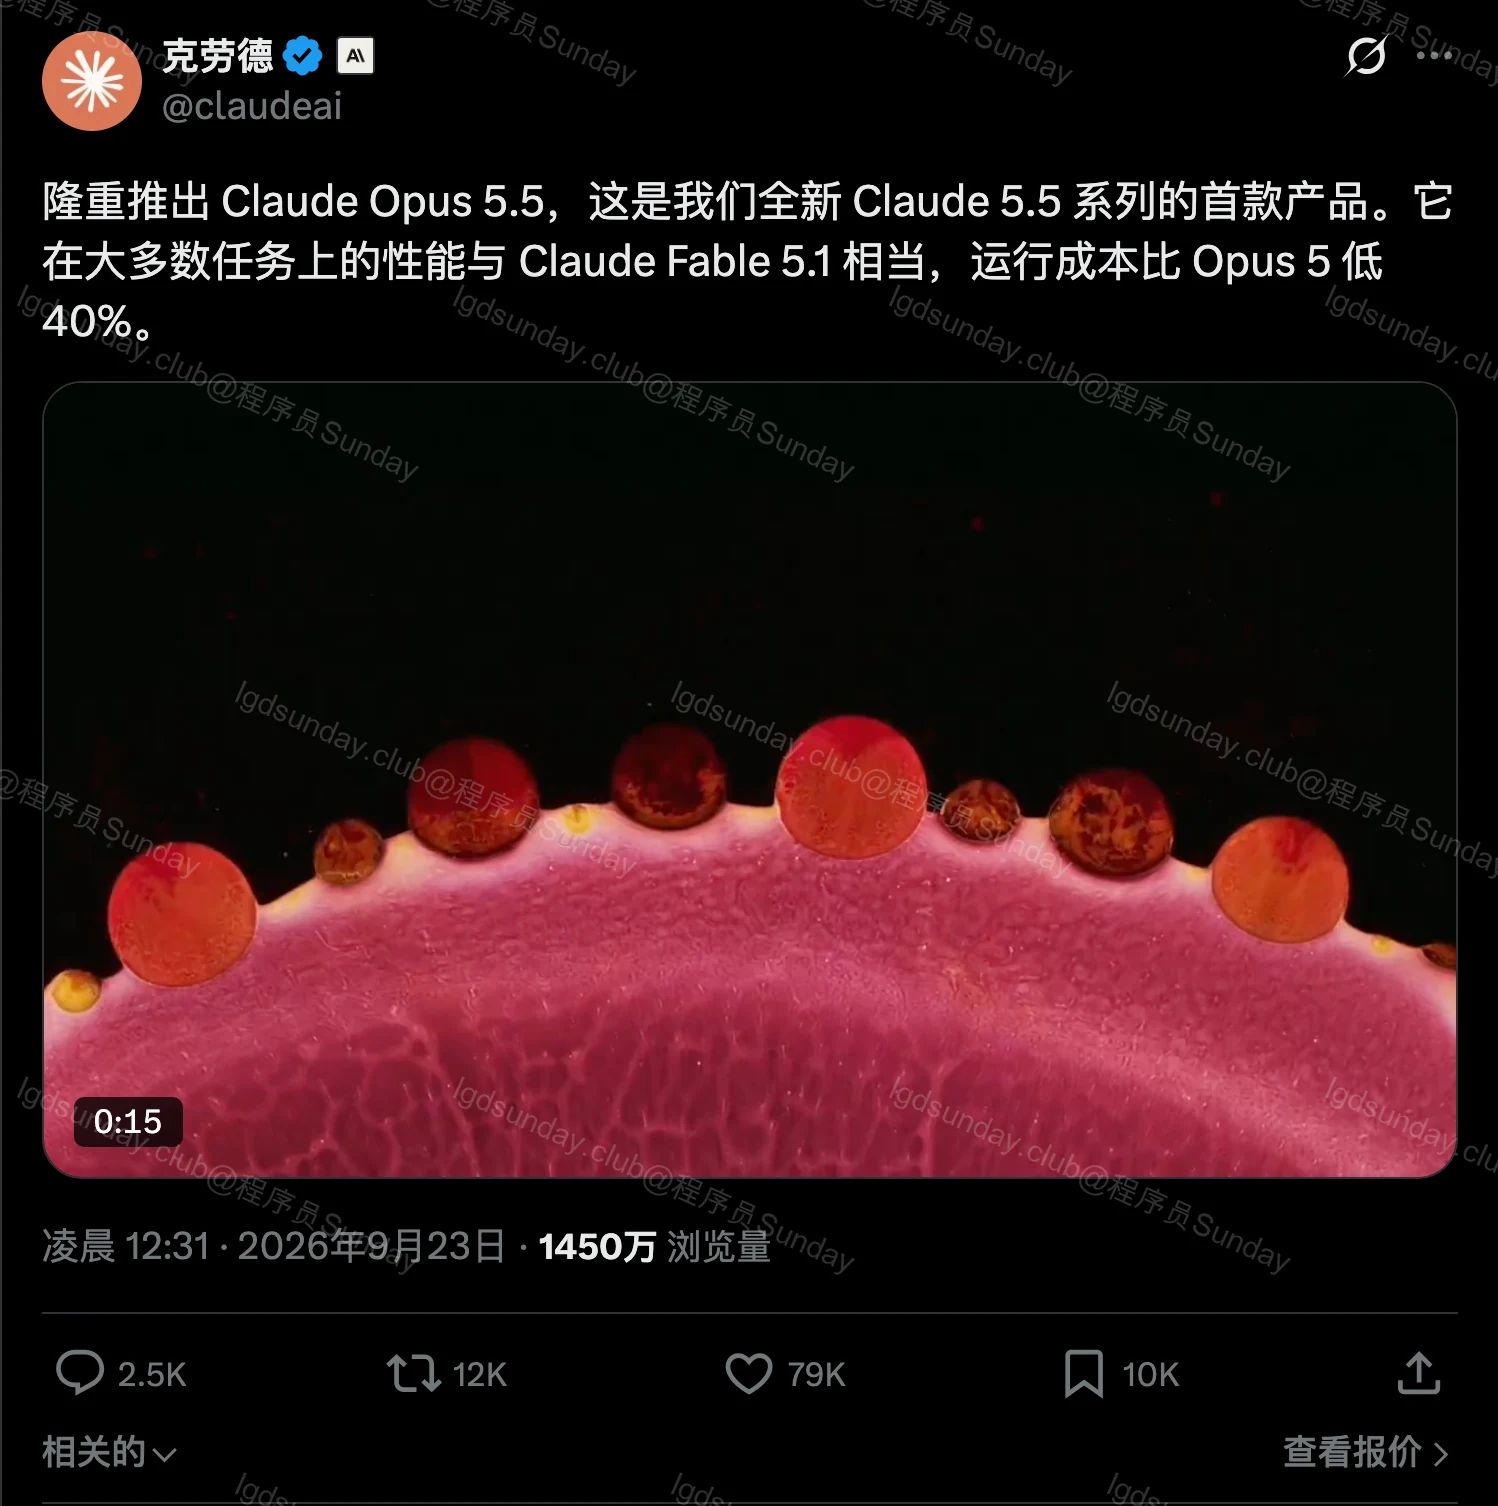
昨天晚上还挺热闹的,Anthropic 刚发了 Claude Opus 5.5。
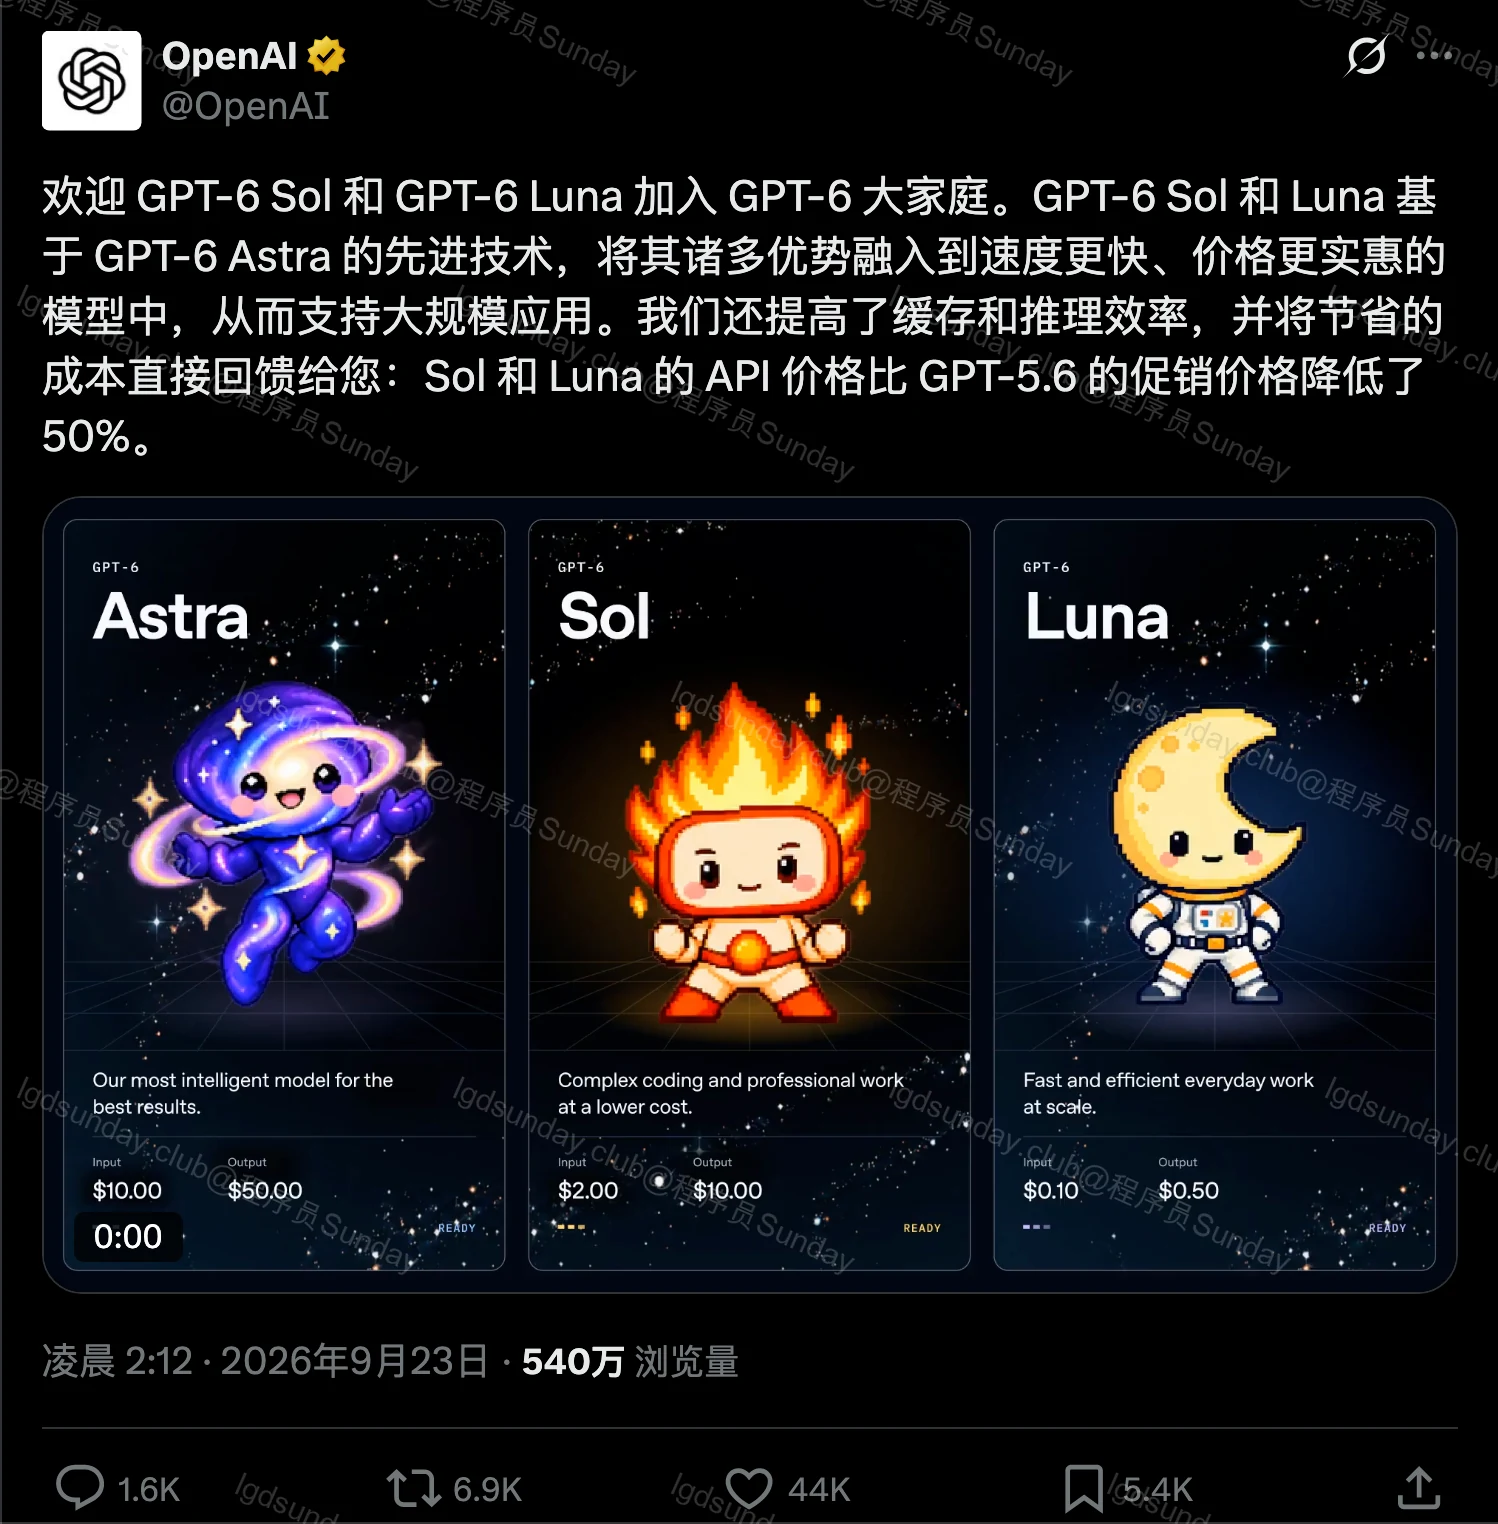
两个小时之后,OpenAI 直接发布了 GPT-6 Sol 和 Luna
这两家死对头算是对上了。
现在的 AI 竞赛就是这个样子,一家公司发布了新的模型之后,竞品几乎可以在几天之内赶上,甚至发布更强的模型。
颇有一种军备竞赛的意思。
模型刚出来就有开发者对两家的主力模型做了专门的测试,渲染了一个鹈鹕骑自行车的效果,给大家看看:
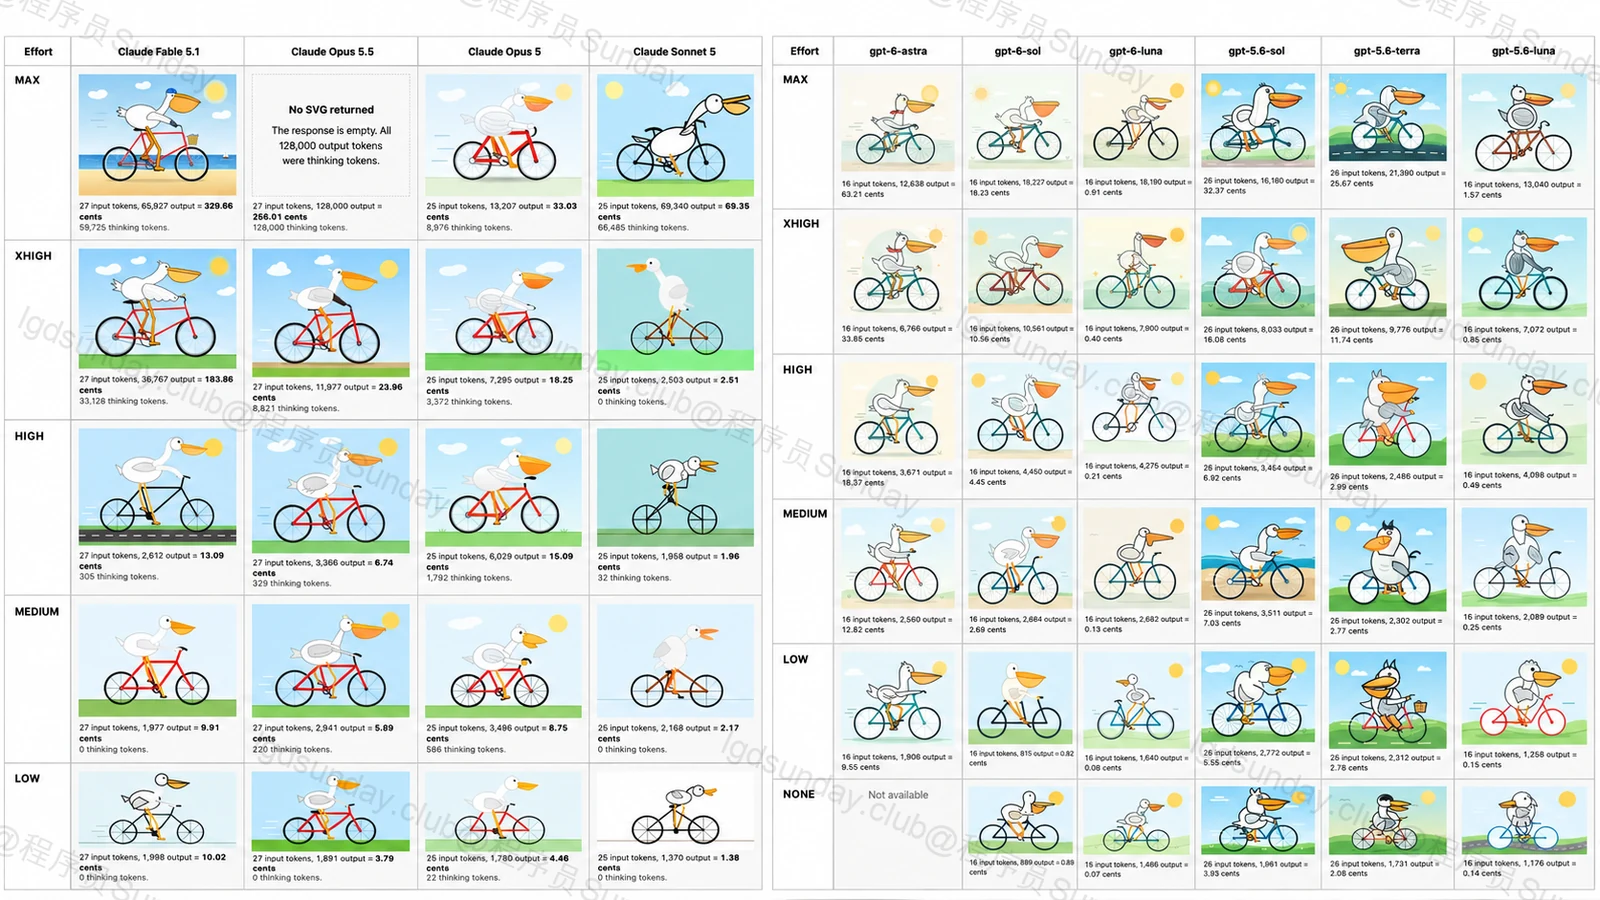
不知道大家看着效果感觉怎么样?
那么接下来咱们就来看看今天凌晨发布的这三款模型,Claude Opus 5.5 和 GPT-6 Sol、Luna
先从 Claude 开始说。
Claude Opus 5.5
虽说平时 A 社不当人,但是 Claude 的能力,我还是服的。
Opus 一直是 Claude 家负责难活的版本。这次更新,A 社主要把重点放在了长时间编程、操作电脑和处理复杂工作上。
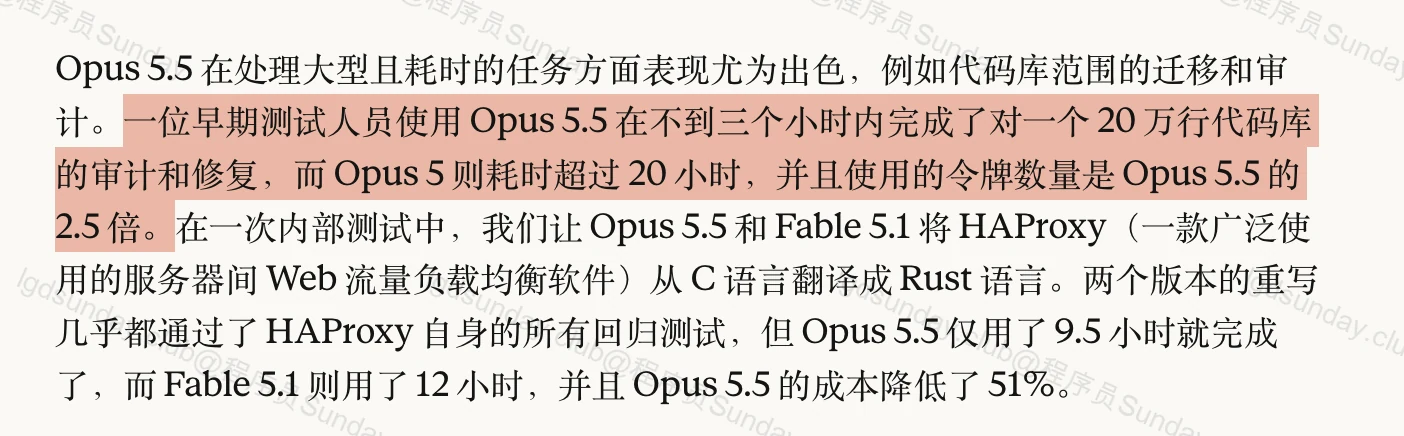
举个他们公开的例子。一位早期测试者让模型审查一个大约 20 万行的代码库,寻找其中的问题。Opus 5.5 不到 3 小时做完,同样的任务 Opus 5 花了 20 多个小时。
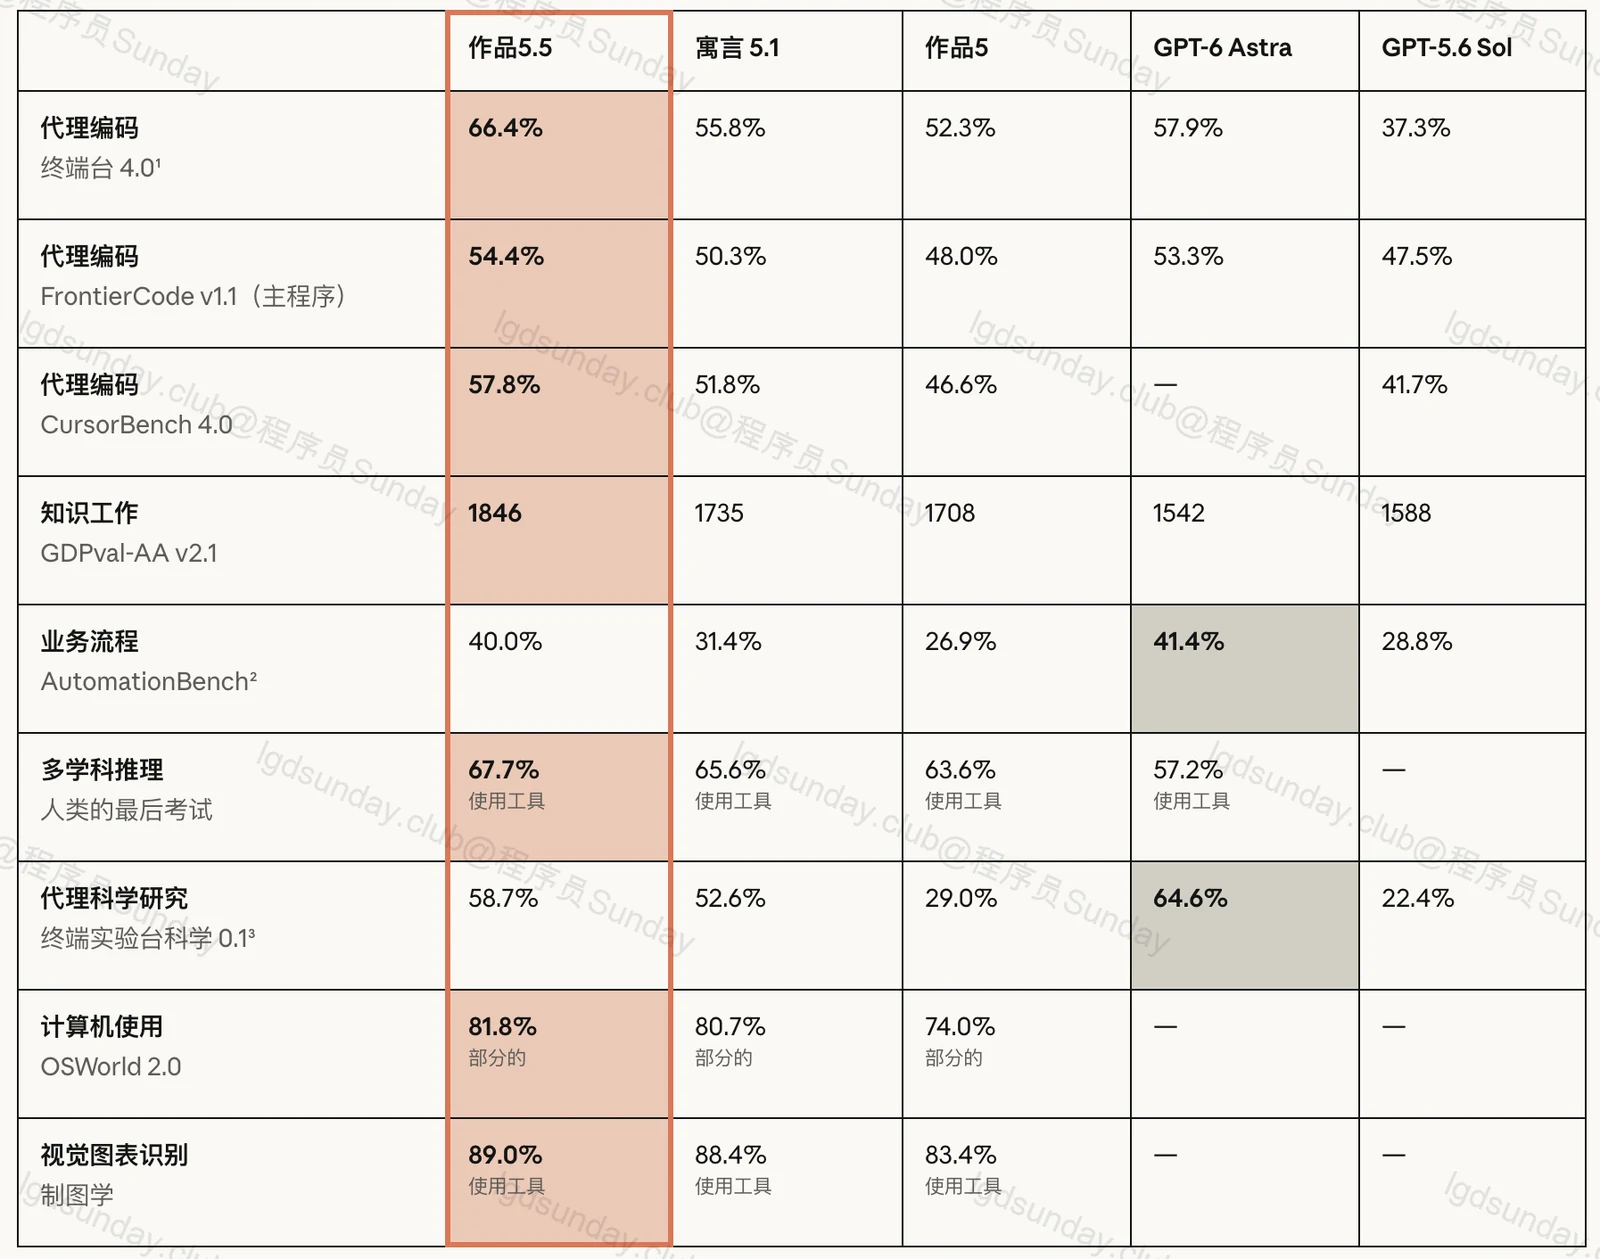
同时,从官方公布的 Terminal-Bench 4.0 成绩来看 5.5 和 5 的区别是很大。
Opus 5.5 得分是 66.4%,Opus 5 是 52.3%。这个测试看的是模型能否在终端里完成复杂任务,和咱们用 Claude Code 干活的场景比较接近。
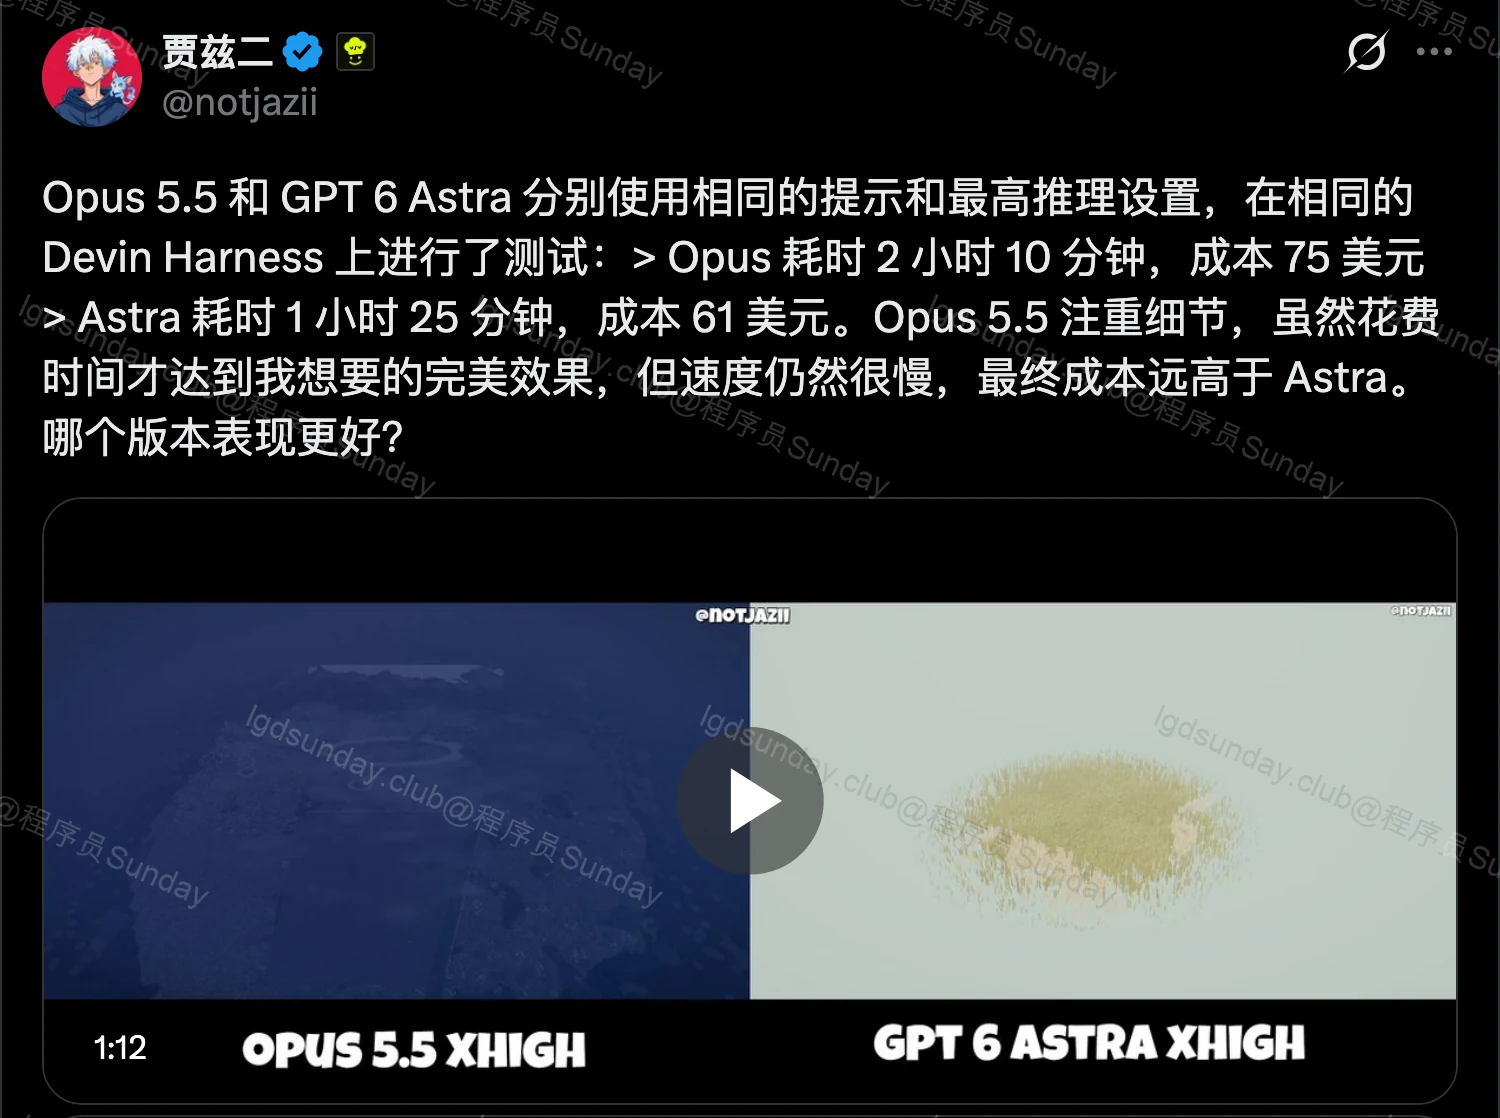
光看数字还是有点抽象。X 上的开发者专门让 Opus 5.5 和 GPT-6 Astra 在同一个 Devin 环境里,使用相同提示词和最高推理,分别制作一个 Minecraft 风格的游戏。,大家可以看下:
「插入视频----Opus 5.5 与 GPT 6 Astra」
这次演示里,Opus 5.5 用了 2 小时 10 分钟,花费 75 刀;Astra 用了 1 小时 25 分钟,花费 61 刀。
至于成品啥样大家仁者见仁,智者见智,但是咱们看它花费的时间和费用却比较有意思
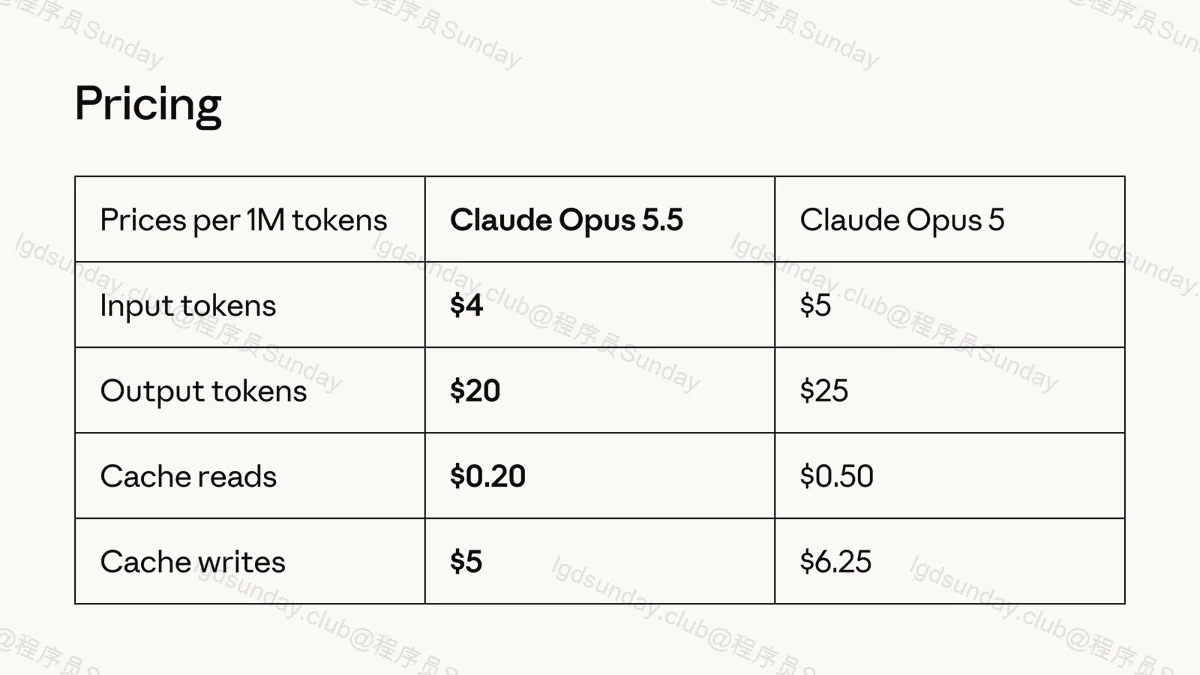
按标准 API 标价,Opus 5.5 每百万输入、输出 Token 分别是 4 刀和 20 刀;GPT-6 Astra 则是 10 刀和 50 刀 只有 GPT 6 Astra 的一半,但是最终的消耗却比 GPT 贵了 14 刀
所以说,模型完成任务时的 Token 消耗,咱们不能单纯的看官方标价。
我原本以为,Opus 5.5 的单价低这么多,做完同一个任务,总费用应该也更低。结果这次演示里,它比 Astra 多花了 14 刀。
所以说,模型完成任务时的 Token 消耗,咱们不能单纯的看官方标价。一个任务最终花多少,还要看它读了多少内容、尝试了多少次。
如果我们使用较小的模型来去完成更复杂的任务,那么反而会一直不断的循环思考,最后的消耗反而可能比旗舰模型更高。
我还记得在 GPT 6 Astra 刚发布的时候,Tibo 说用 Astra 的话,思考程度选低或者中时,可以相当于 GPT 5.6 sol 在高思考模式下的表现:
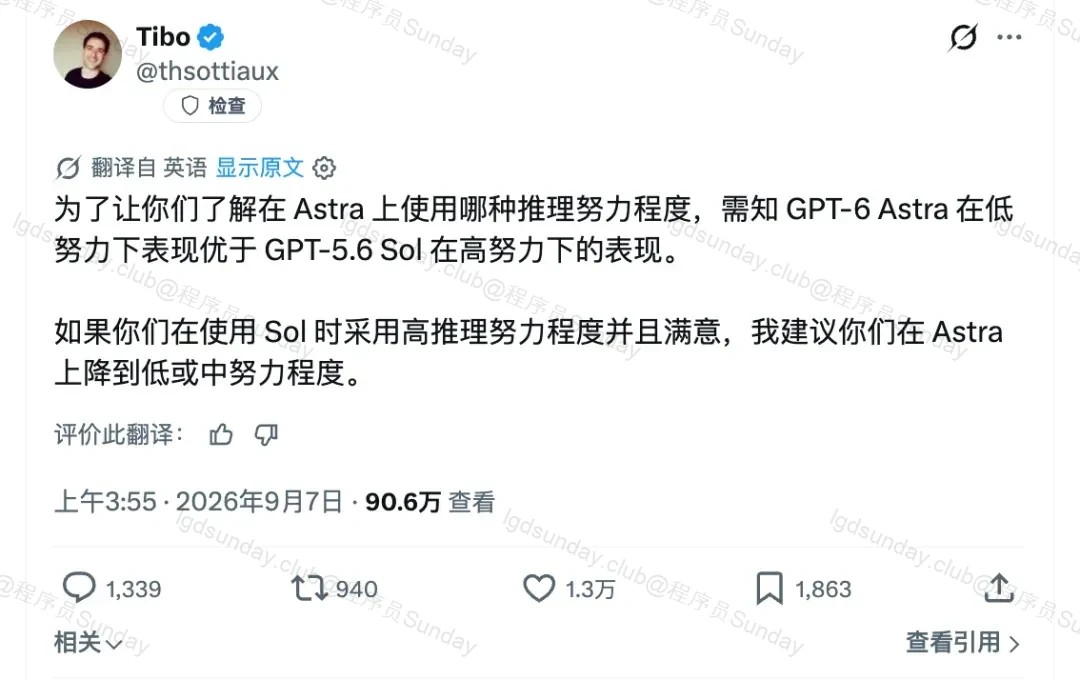
因此,当遇到比较复杂的任务的时候,最好是先试试旗舰模型的低档或中档推理,再决定要不要往上调。把较便宜的模型开到最高推理档,也未必更省 Token。
GPT-6 Sol、Luna
然后咱们来说 GPT-6 Sol 和 Luna 。
首先是价格,不得不说虽然 GPT-6 Astra 都已经发布了半个月了,但是 5.6 Sol 才是我的主力模型。
原因没别的,就是 Astra 太贵了。。。
不过,这次的 GPT-6 Sol 在价格方面确实给力了不少。按每 100 万 Token 计算:
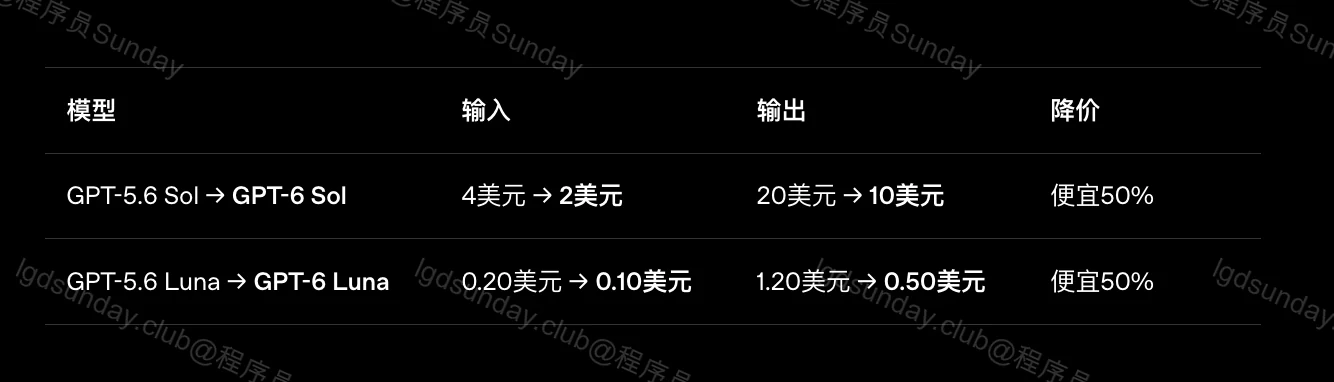
Sol 的输入和输出都减半。Luna 的输入减半,输出从 1.20 美元降到 0.50 美元,降幅还超过一半。
Astra 这东西太贵,对于大部分的普通场景来说,难免有点杀鸡用牛刀的感觉。
而 Sol 本来就是用来处理这些日常工作场景的。而在这次的 GPT-6 Sol 中,它的编程、电脑操作和事实可靠性又提升了一大步。
DeepSWE 1.1 成绩是 68.8%,考的是在真实代码库里解决比较复杂的问题。这个分数已经很靠近发布稿中列出的 Claude Fable 5 成绩。
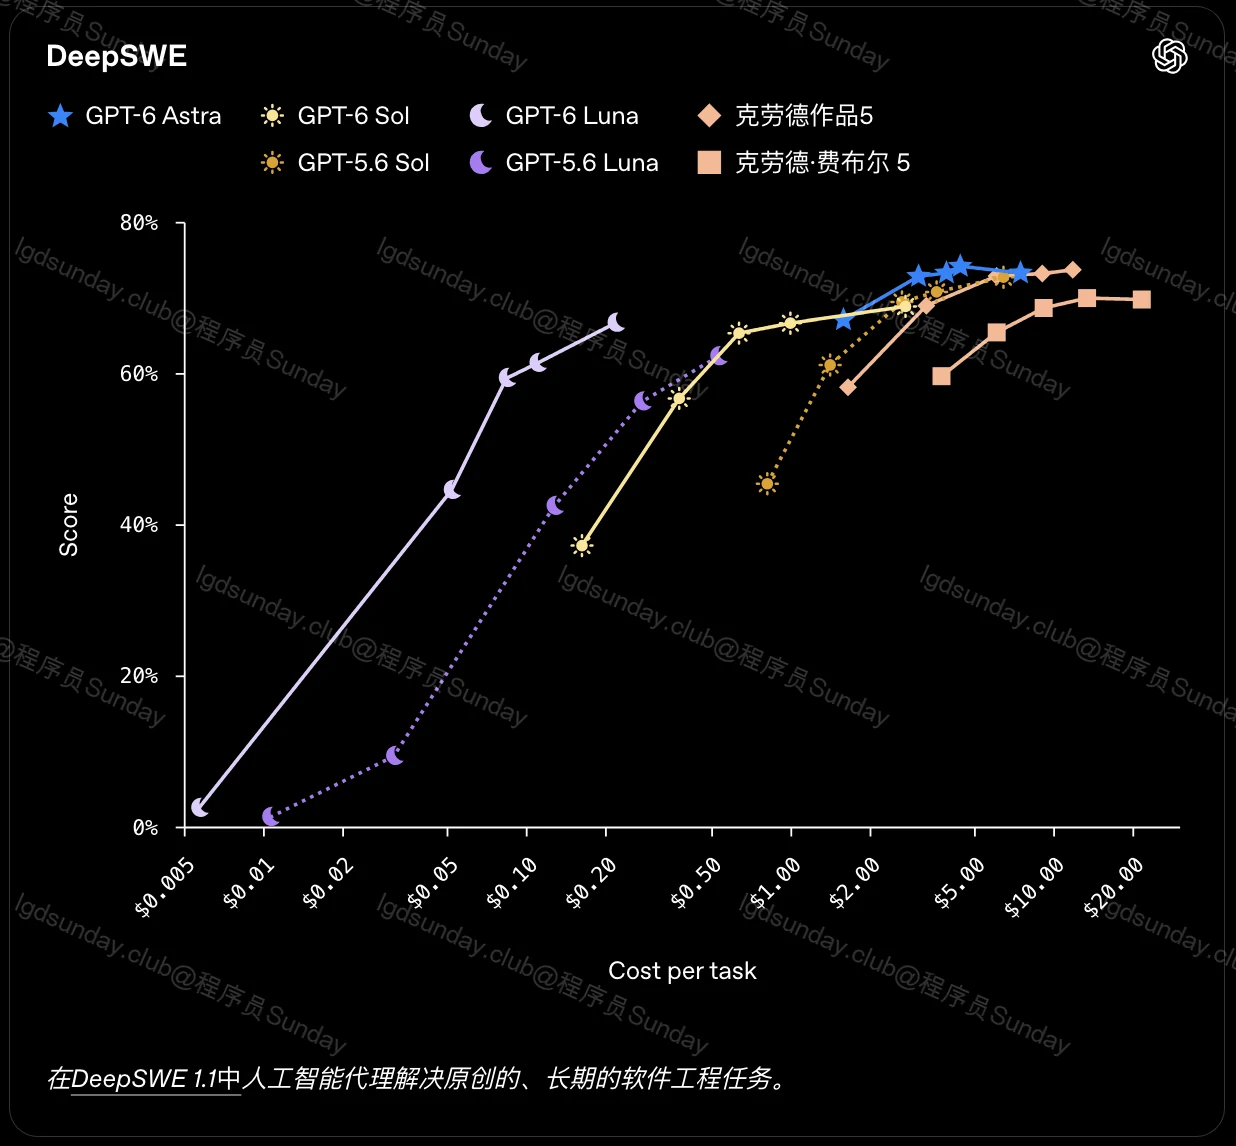
这个成绩挺能打,不过我更想知道的是,升级到 GPT-6 以后,Sol 在 Codex 里干活有没有变得更好了。
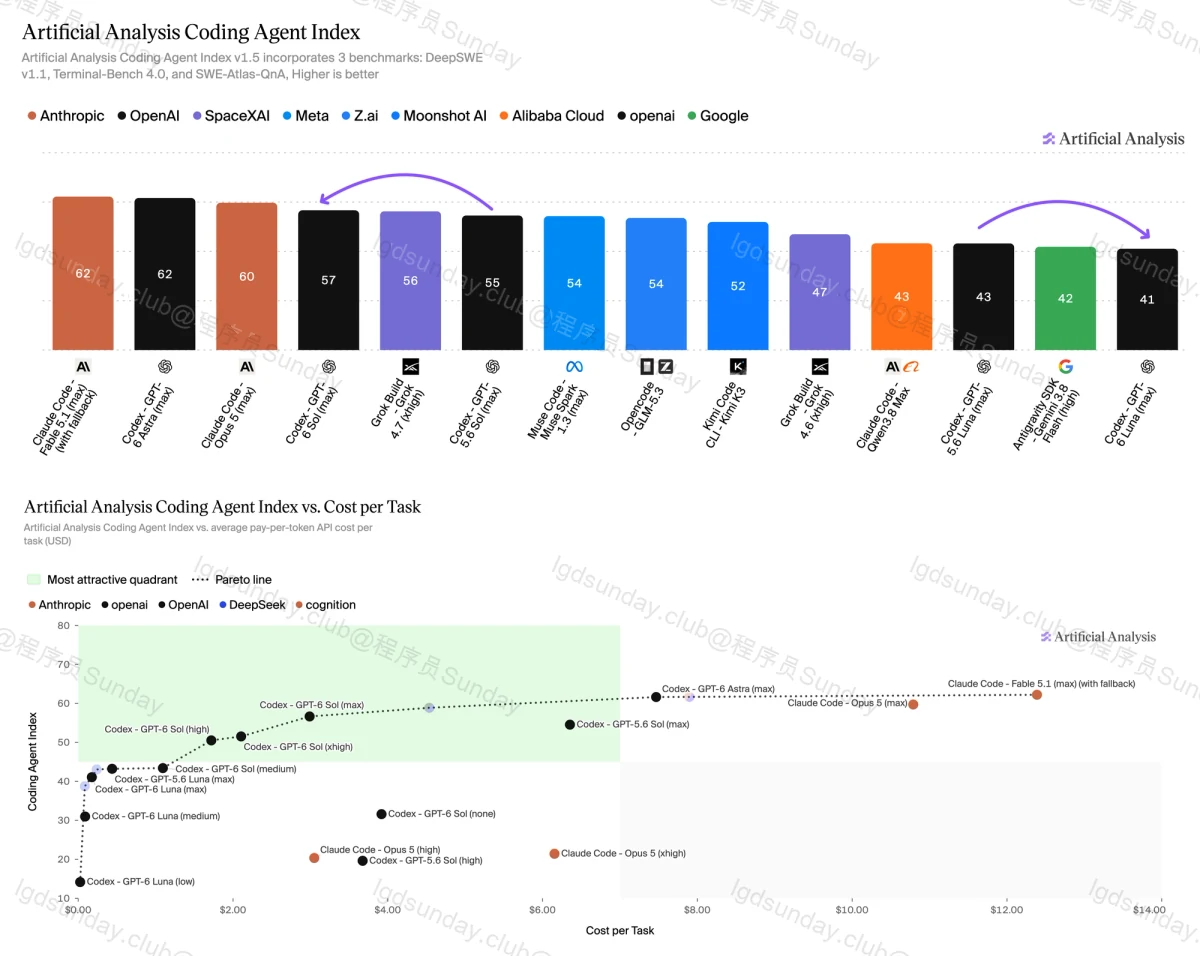
Artificial Analysis 用 Codex 环境做了一次测试 ,GPT-6 Sol 的 Coding Agent Index 是 57 分,上一代是 55 分。有进步,但从这个结果看,还谈不上换代以后突然强了一大截。
OpenAI 还放了一段网站修改任务的对比,我觉得挺贴近日常使用。旧版 Sol 改完以后,花了不少篇幅介绍自己用了什么方案。而新版 Sol 会告诉用户,它检查了窄屏显示和浏览器返回操作。
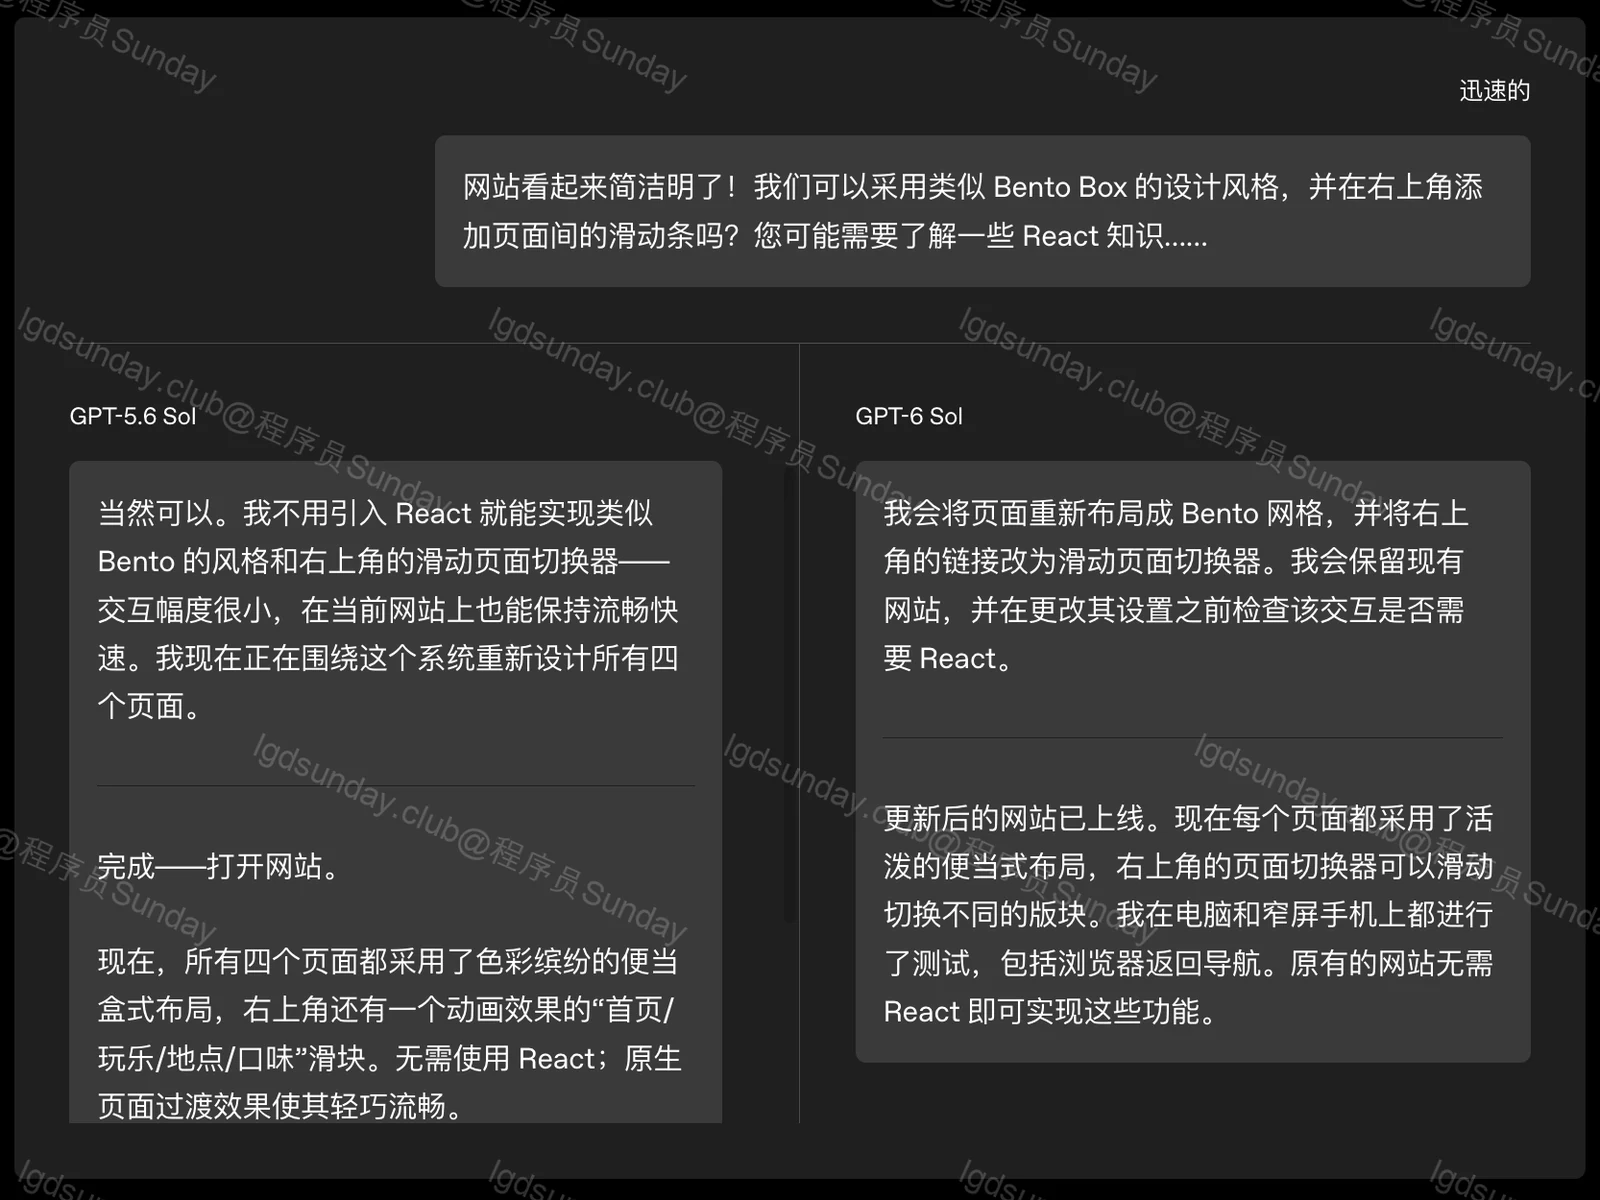
这就比较贴合咱们日常的工作场景了。
咱们让 Codex 改代码时,最怕它说一句 “完成了”,结果打开一看全都不能用。它愿意把检查过的地方讲清楚,至少咱们知道下一步该从哪里验收。
再看 Luna。
它的价格确实便宜得有点离谱,但我暂时不会让它独自处理一个复杂项目。
OpenAI 公布的 DeepSWE 1.1 成绩是 66.6%;而在 Artificial Analysis 的另一套编程测试中,GPT-6 Luna 得了 41 分,比上一代还低了 2 分。
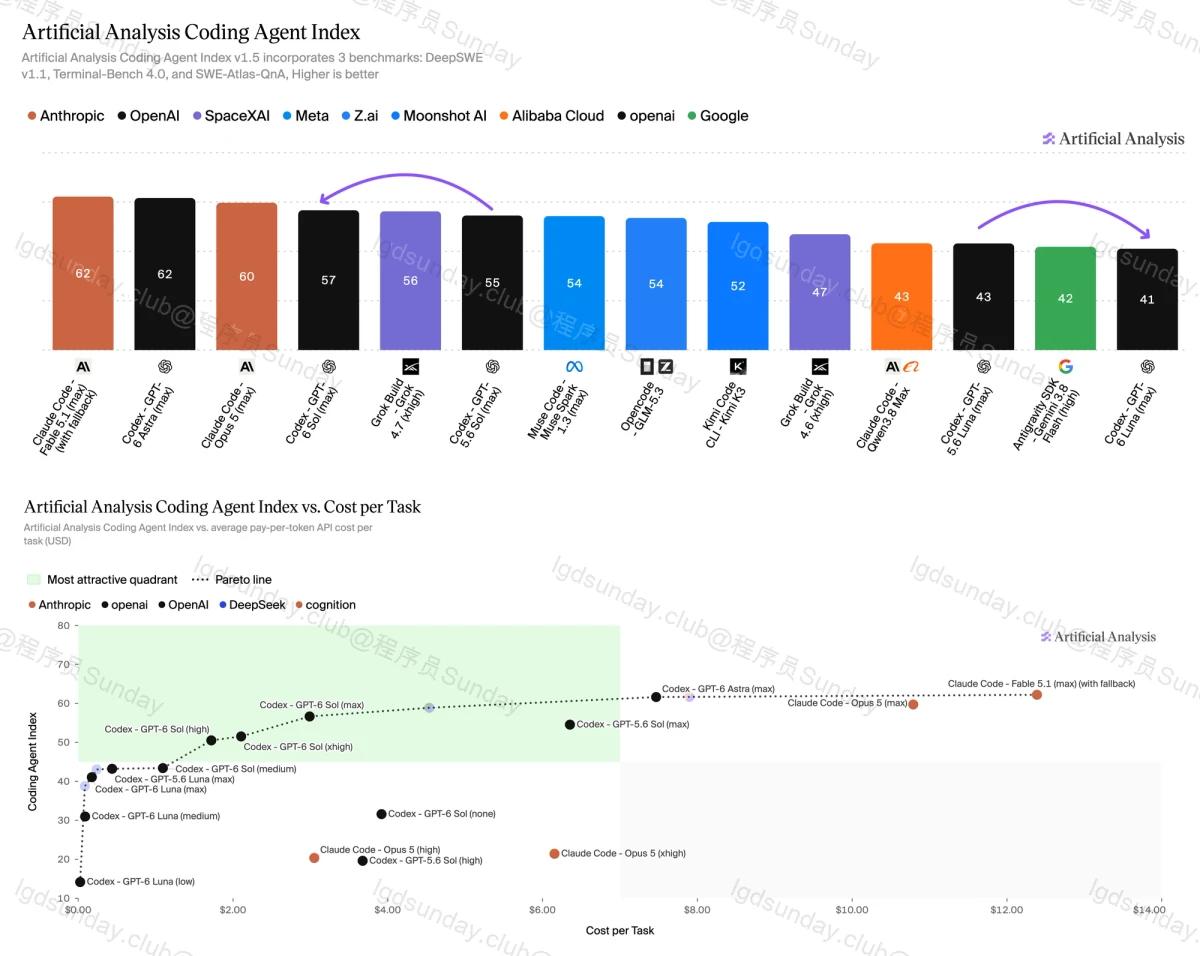
所以,GPT-6 Luna 还是比较适合去处理一些相对简单的任务,毕竟便宜呀。
那么现在到底怎么选?
这次三款模型一起发布,我最想先试的还是 GPT-6 Sol。
因为 5.6 Sol 本来就是我的主力,价格降了,跑分也有进步,这就挺好的。
Opus 5.5 的公开表现很亮眼,我也挺想用。可我的 Claude 账号之前被封了,暂时没法给大家讲一手体验。不过如果大家可以稳定使用 Claude 的话,那么从理性上来说 Opus 5.5 + Claude Fable 5.1 依然是这个时代最好的组合。
至于 Luna 比较适合处理一些简单的任务,比如:整理一批文章资料或者是给 issue 进行分类。如果直接让它做一些复杂项目,至少我现在还是不放心。
