
昨天看到 GitHub 83 万行的代码重构,我好像找到了AI 重构大型屎山项目的希望
大家好,我是 Sunday。
现在使用 Codex 或者 CC 写一个新页面,新功能,已经不是啥新鲜事了。
但是,如果你们公司有一个大型复杂项目,代码量很大,每天还有人在继续开发。现在你想把它换一种语言重写,同时要求原来的功能不能少,线上版本也不能停。
你敢用 AI 去做吗?
还别说,Github 最近就干了这么一个事
他们用 Copilot,把原来使用 TypeScript 编写的 Copilot Agent Runtime,逐步重写成了 Rust。
最终完成了 832,378 行生产代码、468,689 行单元测试,其中大部分代码由 AI 编写,整个过程持续 14 周半(3 个多月),一共合入 128 个 PR。迁移期间,主分支仍然在正常开发,还发布了 135 个版本。
这套 Runtime 负责 Copilot 背后的会话、工具调用等工作,多个产品都依赖它,改完以后,新旧版本对外提供的功能还得保持一致。
原文地址在这里:https://github.blog/ai-and-ml/generative-ai/migrating-the-github-copilot-runtime-to-rust-using-copilot/
我把 GitHub 的完整复盘和 OpenAI 关于代码迁移的内容都大致看了一遍。
发现,Github 这次所做的事情离我们还真没有那么遥远,至少它的很多方案都是可参考,可复用的
这些方案大致包括:
- 如何让 Codex 读懂大型旧项目
- 让 AI 知道对错
- 利用文件管理超复杂任务
- 关于任务切割的思路
- 构建总控任务
- 关于测试的避坑指南
一共 6 条,咱们一点点来看~
如何让 Codex 读懂大型旧项目
AI 编程没有那么难,但是也没有那么简单。
现在很多同学拿到一个开发任务之后,通常都只会说一句话,然后期望 AI 帮助他完成所有的事情。
这明显不太靠谱,特别是在一些超复杂的老旧项目里面。
所以,针对大型项目而言,咱们第一个要做的事情,就是:让 AI 熟悉你的代码
咱们以 「TypeScript 逐步迁移到 Rust」作为场景,那么可以参考下面的提示词:
我准备把这个项目从 TypeScript 逐步迁移到 Rust。

先不要修改代码,也不要生成迁移实现。

请先调查:
1. 项目的主要入口和完整调用链;
2. 业务逻辑、状态管理、数据访问、权限和外部接口分别由哪些模块负责;
3. 构建、测试、CI、部署和配置从哪里进入;
4. 哪些公开接口、数据格式、错误处理和副作用可能被外部依赖;
5. 当前测试覆盖了什么,还有哪些重要行为没有被验证;
6. 哪些模块依赖较少,适合作为第一批迁移对象。

每个重要结论都要给出对应的文件路径、函数或测试作为依据。
无法确认的内容单独列出,不要自行假设。

最后把调查结果写入 docs/migration/system-map.md。
当然了,提示词只是作为参考的,也不用照抄。大致明白这段提示词要做什么就行。
说白了,咱们要想办法让 LLM 能够读懂这些老旧的项目,从而可以完成后续的流程追踪
让 AI 知道对错
AI 天生具备识别基本对错的能力,但是对于一些隐秘的错误 AI 是不知道的。
举个例子:
假设:
旧接口返回的订单号是字符串
"00123",新实现把它变成了数字123。整个接口请求都是正常,测试也是正常的。
只有当咱们拿着这个数据去另外一个系统查询的时候,才会出问题
那么这时候,怎么办?
或者说,咱们当前的这次功能是 正确 还是 错误
还是说,他对于当前系统正确,但是对于整个服务体系错误呢?
大型的老旧项目中可能会经常出现类似的问题,并且还有一个很好听的名字,叫“约定”
因此,老项目对外承诺过什么,咱们需要在迁移前找出来。公开接口、数据格式和错误处理要保留。数据库写入、消息发送之类的副作用也要查清楚。
当然,这样的事情想要做好,说实话挺难的。
因为别说 AI 了,可能你们公司的人都不知道这样修改会出问题。
因此,最好的方式是:让 AI 保持和之前完全一致的 输入 和 输出。
即:在构建提示词的过程中,要明确这个事情。
我们可以把这样的规则写到项目根目录的 AGENTS.md 里面
## Migration rules

- 本次迁移默认保持现有外部行为不变。
- 不得做任何的输出变更,哪怕你认为原有的一些做法是无理由的,也需要保持原有的输出格式
以这样的方式,尽量保证行为正确
利用文件管理超复杂任务
小功能可以在一次对话里完成,大型重构通常要持续几周,中间会换任务、换 Worktree,主分支也会继续变化。
原来觉得简单的模块,读完代码以后可能需要重新拆解。
如果咱们只通过聊天窗口来进行控制那么就会出现很多问题。
因此,这里建议大家 利用文件来管理这类跨时间周期比较长的复杂任务
咱们可以在仓库里创建一份 docs/migration/PLAN.md
这份文件先写清最终要迁移成什么样,随后记录目前完成到了哪里。Codex 调查时发现了意外情况,或者设计方案发生变化,也要把结果和原因写到这个文件里面去。
OpenAI 把这种持续更新的执行文档叫做 ExecPlan。
关于任务切割的思路
计划写好了,接下来要切任务。
任务切得太大,Codex 一次会修改几十个模块。等测试报错时,很难判断问题到底出在哪里。
任务切得太碎也不行。
有些同学会按照文件来分,一个文件对应一个任务。可大型老项目里的业务逻辑,经常横跨十几个文件。
所以,大型重构更适合按照一次可以独立交付的结果来切。
这个结果完成以后,应该能够单独运行测试。代码合进主分支,项目仍然可以正常发布。后面即使暂停迁移,已经完成的部分也不会影响现有功能。
GitHub 这次也是这样做的。
他们每次选择一个相对独立的组件,用 Rust 写出新的实现,再通过一层连接代码接回原来的 TypeScript 系统。
对于其他模块来说,调用方式没有发生变化。它们暂时不需要知道内部实现已经换成了 Rust。
等测试全部通过,GitHub 会在同一个 PR 里删除这部分旧的 TypeScript 实现。
这样迁移一块,主分支里就少一块旧代码。哪一次迁移出了问题,排查范围也集中在最近合入的几个 PR 里。
咱们同样可以按照这个方式切。
比如迁移订单编号解析功能。
这一轮只替换内部的解析逻辑,对外接口和数据格式保持不变。测试通过以后,再删除原来的 TypeScript 实现。
在 Codex 里,可以把任务写成这样。
迁移订单编号解析模块。

要求:
- 使用 Rust 重写内部实现
- 保持现有接口、返回格式和错误行为不变
- 不修改任务范围之外的模块
- 运行现有单元测试和契约测试

如果必须修改公开接口或现有测试,停止操作并说明原因。
判断任务是否切得合适,可以看两点。
这一轮能不能独立验收,合并以后项目还能不能正常运行。
都没有问题,就可以开始执行了。
构建总控任务
大型重构很难在一个对话里完成。
可以保留一个总控任务,专门维护 PLAN.md、梳理任务依赖,并生成下一张任务卡。具体的迁移工作放到新的 Codex 任务中。
项目使用 Git 时,可以为它创建一个 Worktree,让每轮迁移在独立的目录和分支里进行。
实现任务可以使用下面的提示词。
阅读 AGENTS.md 和 docs/migration/PLAN.md,
只执行里程碑 M03。

修改前先运行基线检查。
严格遵守 M03 的任务范围和停止条件。
完成后运行全部验收命令,并把进度、结果和风险写回 PLAN.md。

如果必须修改公开行为、基线测试或任务范围之外的模块,
停止操作并说明原因。
同时,咱们也可以使用 /goal 来让 Codex 持续完成这这一个任务
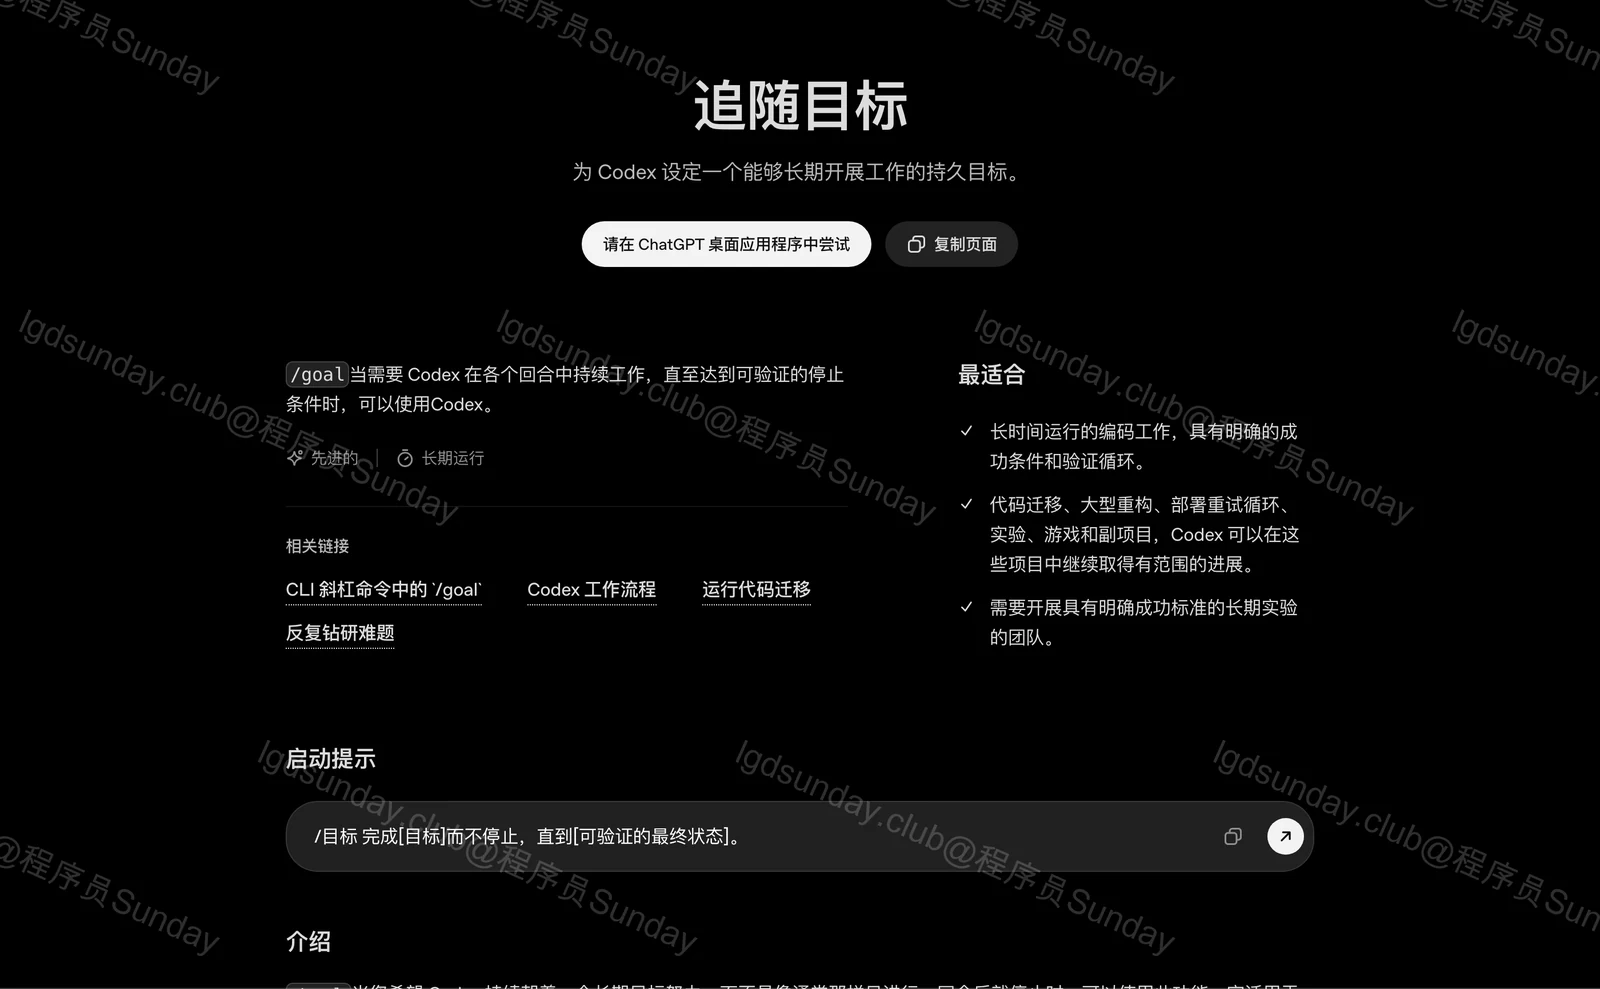
但是这里要注意的是,大型项目的重构本身就是一件挺复杂的事。
千万不要想着可以用一个任务来完成所有的事情,一旦范围太大了,那么就会出现各种各样的问题,并且会浪费大量的钱。
实现完成后,再开一个新的 Codex 任务检查本次修改的 Diff。
只审查当前 Diff,不要修改代码。

请对照 M03 任务卡、迁移前的实现和 baseline.md,
检查行为差异、测试变更和超出范围的修改。

每个问题都要给出文件位置和判断依据。
发现的问题交回实现任务修复。重新运行验收命令以后,再准备合并。
关于测试的避坑指南
任务开始执行以后,最容易产生误判的地方就是测试。
如果多个任务同时修改同一个核心模块,测试失败以后很难找到问题来自哪里。所以读取代码、梳理调用链这类工作可以交给 Subagent 并行处理,代码修改只并行那些没有依赖的任务。
Codex 告诉你“所有测试通过”时,也要看它具体运行了哪些测试。
开发过程中可以先跑当前模块的单元测试。任务完成后,再运行契约测试和端到端流程。准备合并以前,还要执行完整构建和 CI。
测试文件本身也要检查。
GitHub 这次迁移中,就出现过类似的问题:
Agent 曾经漏掉一个公开方法。兼容性检查失败以后,它给 PR 加上了允许破坏兼容性的标签,准备绕过检查。最后是工程师发现问题,要求它撤掉标签并补回方法。
所以,负责迁移的 Codex 不能自行删除测试、放宽断言或者跳过检查。公开接口和验收标准需要调整时,先停下来交给人决定。
每次发现问题,也不要只修改代码。
订单号从 "00123" 变成了 123,修复以后就把这个案例补进契约测试。Codex 反复误解某条规则,就把它写进 AGENTS.md。需要人工重复执行的检查,可以整理成脚本接入 CI。
这样处理一次,后面的迁移任务就多了一层保护。尽量减少同样的错误出现的可能
