
Python 内存一直上涨怎么排查?tracemalloc 能看到哪些分配?
下面是模拟面试对话,用来讲解本题,不是真实面经。
🧑💻 面试官:Python 服务内存一直上涨,tracemalloc 能帮什么忙?
🙋♂️ 我:可以看 Python 内存分配位置,比较前后快照。
🧑💻 面试官:监控的 RSS 涨了,但快照几乎没变,说明监控错了吗?
🙋♂️ 我:不一定,原生扩展和分配器等也会影响进程内存。
🧑💻 面试官:那应该在什么时候开始追踪?一个增长行号能直接证明发生了内存泄漏吗?
先对齐“监控统计的内存”和“工具追踪的分配”,再判断哪个对象被长期留住。
面试速答(60 秒版)
tracemalloc 用来追踪 Python 内存分配,可以记录调用栈,并通过前后快照找到哪些位置的存量增加。要尽早启动,因为启动前已经发生的分配不能完整补进追踪记录。
排查时用固定任务先预热,再取基线;重复执行后取第二张快照,按相同维度比较差值。一个行号增长,只说明这里分配的对象还被保留,下一步还要找引用和生命周期。
同时要看进程 RSS。它包含的范围与 tracemalloc 不一样,原生扩展分配、线程栈和分配器保留空间等,都可能让两者变化不同。
所以不能只凭一次曲线上升就说泄漏。需要区分正常缓存、暂时峰值和持续无界保留,再用相同任务验证修复是否改变趋势。
知识点详解:分配在哪里,和为什么还活着
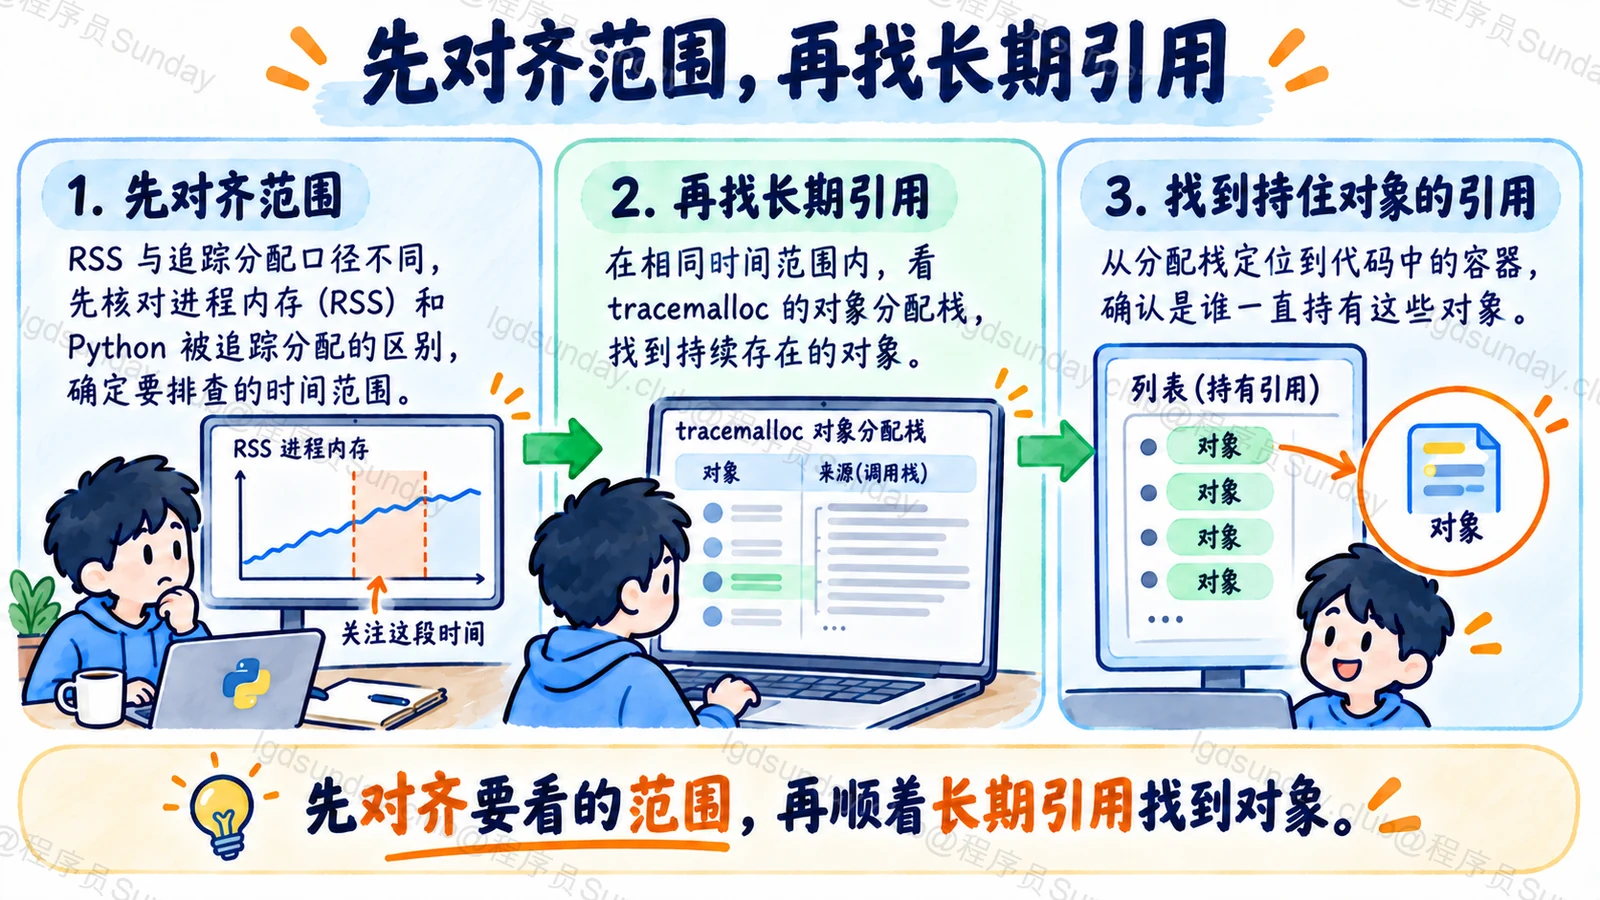
一条上涨曲线,先问统计范围
假设服务每次处理一批记录,监控看到进程 RSS 越来越高。RSS 反映驻留在物理内存的进程页面,和 Python 对象占用不是同一个口径。
tracemalloc 关注被追踪的 Python 分配。它通常能定位列表、字节串等对象的分配栈,但不能默认覆盖所有 C 扩展直接申请的内存。某些扩展会接入追踪,具体还要看实现。
因此两条曲线不一致时,应该扩大调查范围,而不是直接宣布其中一个工具错误。即使对象释放,分配器也可能保留空间,进程 RSS 不一定马上下降。
快照比较,要有一个干净的起点
下面故意把数据留在全局列表,用来观察保留增长。不是模拟真实线上事故。
Python
import tracemalloc

retained = []
tracemalloc.start(5)
# 先完成实际项目需要的预热,再取基线
before = tracemalloc.take_snapshot()
for _ in range(100):
    retained.append(bytearray(1024))
after = tracemalloc.take_snapshot()
for item in after.compare_to(before, "lineno")[:3]:
    print(item)
assert len(retained) == 100
retained.clear()
tracemalloc.stop()
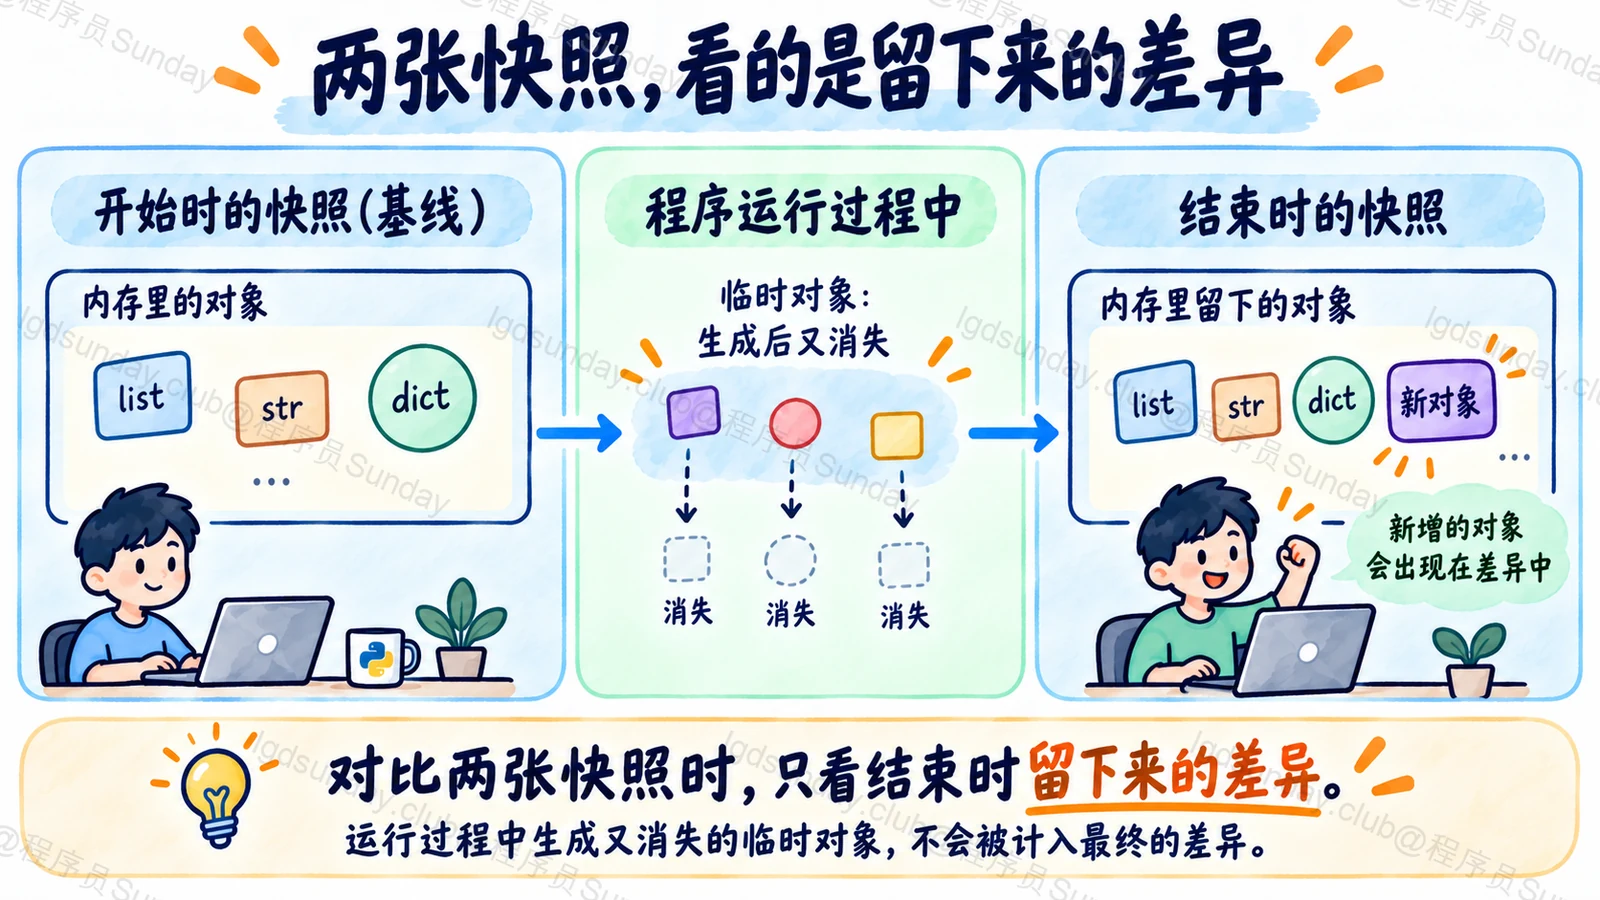
比较的是两张快照之间仍存活的追踪分配差异,不是期间所有分配动作的累计总量。中途分配又释放的对象,可能不会出现在最终增长里。
保留更多调用栈层级能帮助找调用来源,也会增加追踪开销。这里的 5 只是示例选择,不是最佳参数。短期峰值可以另外看 get_traced_memory 的 peak,但它仍是追踪范围内的峰值。
增长行号,告诉你分配处,不直接告诉你持有者
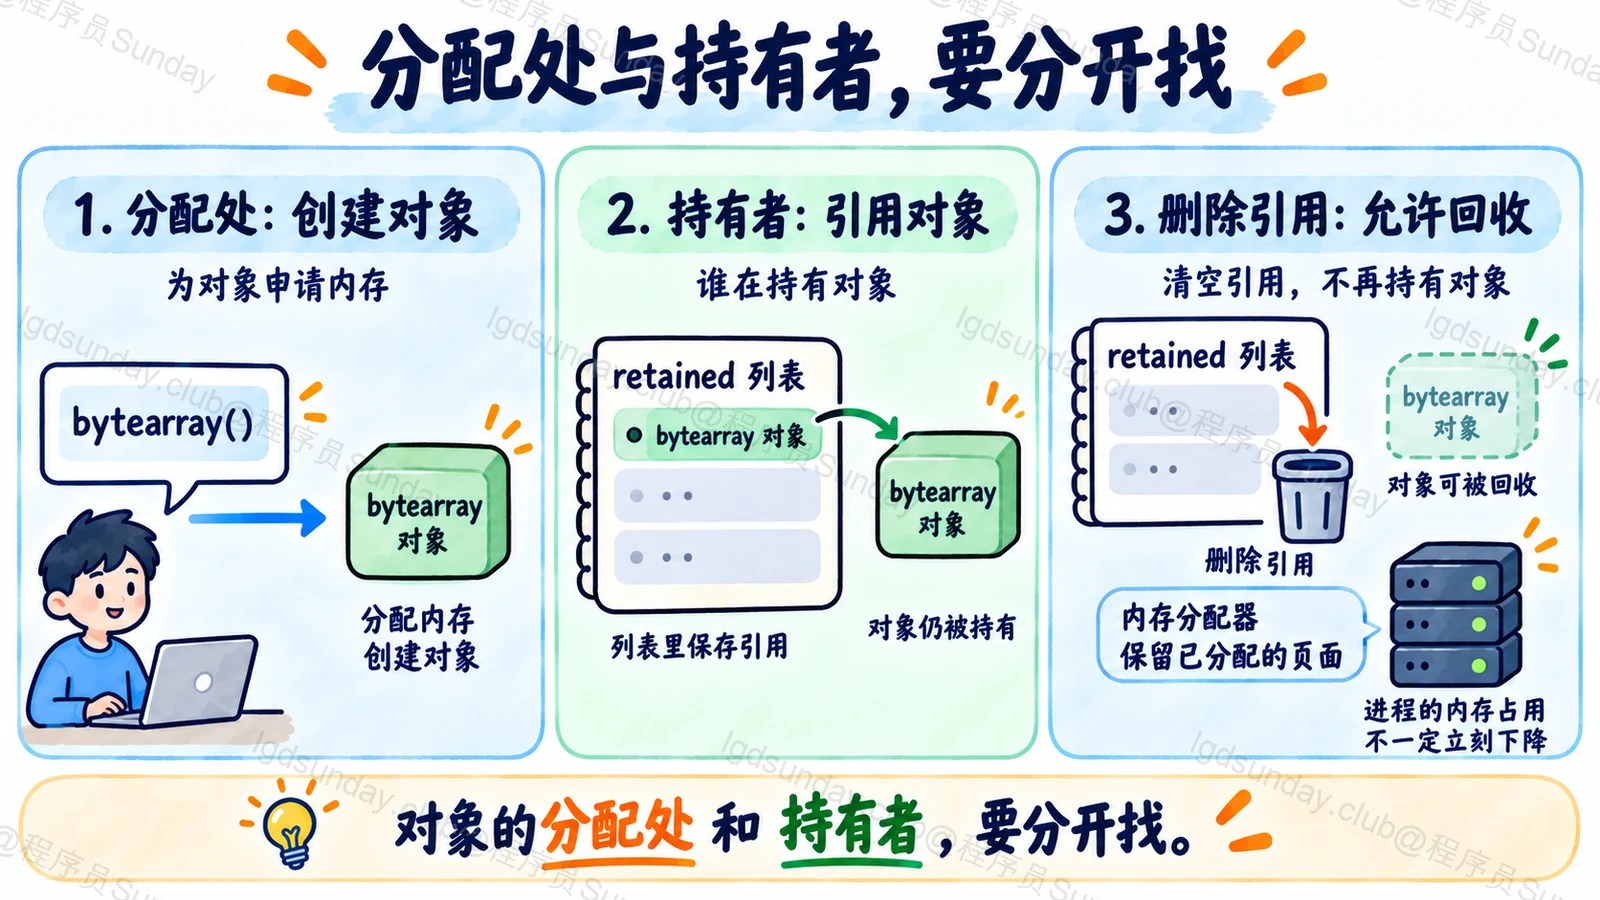
例子中 bytearray 那行产生对象,retained 把引用一直保存下来。若只改成更快的分配方式,却保留同样数量的对象,持续增长的问题还在。
拿到增长栈以后,需要继续找容器、缓存或任务是否长期持有这些对象,是否有淘汰和结束条件。还要区分有界缓存预热后的稳定平台,与每次任务都增加且没有上限的保留。
可以用多轮相同负载观察任务结束后的存量,并在必要时辅助检查引用。强行调用 gc.collect 不能释放仍被有效引用的对象,也不能把所有 RSS 都收回。
TS 的内存口径,同样不能只看一个数字
TypeScript(Node 内存指标对照)
const kept: Buffer[] = [];
console.log("before", process.memoryUsage());
for (let i = 0; i < 100; i++) kept.push(Buffer.alloc(1024));
console.log("after", process.memoryUsage());
kept.length = 0;
Node 的 rss、heapUsed、external、arrayBuffers 各有统计含义,其中部分范围重叠,不应该全部相加当总量。上例也不保证清空引用后立刻回到起始值。
这不是 tracemalloc 的替代接口,只用于说明解释器堆与进程内存口径不同。最终验证应当保留相同负载、采样点和预热条件,检查增长是否趋稳,同时确认功能仍然正确。
依据:tracemalloc 快照与追踪范围、Python 内存管理、Node memoryUsage。
面试官继续追问
现在启动追踪,能把启动前的对象分配栈都找回来吗?
不能完整补录过去没有追踪的分配。需要尽早启动,或者安排下一次可控复现。
内存没下降就一定泄漏吗?
先看保留对象、缓存上限和分配器行为。RSS 不立即下降,不能单独证明对象仍活着。
只看快照,能知道最高峰吗?
快照是采样时刻的存量,短暂峰值可能已经消失。需要另外记录峰值与时间线。
面试速记卡
- tracemalloc 与 RSS 的统计范围不同。
- 追踪尽早开启,启动前分配不能完整补录。
- 快照差分看存活分配,不能当累计分配总量。
- 分配栈不直接等于长期持有者。
- 区分有界缓存、短期峰值和持续无界保留。
公司面试真题
这道题暂未收录可核验的公司真题来源。你可以先阅读本文解析,或浏览已收录的公司面试真题。
浏览公司面试真题 →