
Python 程序运行慢怎么排查?cProfile 如何区分热点函数和等待时间?
下面是模拟面试对话,用来讲解本题,不是真实面经。
🧑💻 面试官:Python 程序变慢了,你怎么用 cProfile 排查?
🙋♂️ 我:先跑固定任务,按累计时间看热点函数。
🧑💻 面试官:一个函数累计耗时很高,但它大部分时间都在等接口,应该先重写算法吗?
🙋♂️ 我:还需要判断是计算慢还是等待久。
🧑💻 面试官:那 tottime 和 cumtime 各表示什么?优化以后怎样证明同一份任务确实更快了?
热点报告先告诉我们时间花在哪里,再结合 CPU 与等待情况判断该改什么,不能看到大数字就认定算法慢。
面试速答(60 秒版)
排查 Python 性能,先固定输入和测量范围,再记录整体耗时。接口响应慢时,还要区分计算、网络等待、数据库等待和排队。
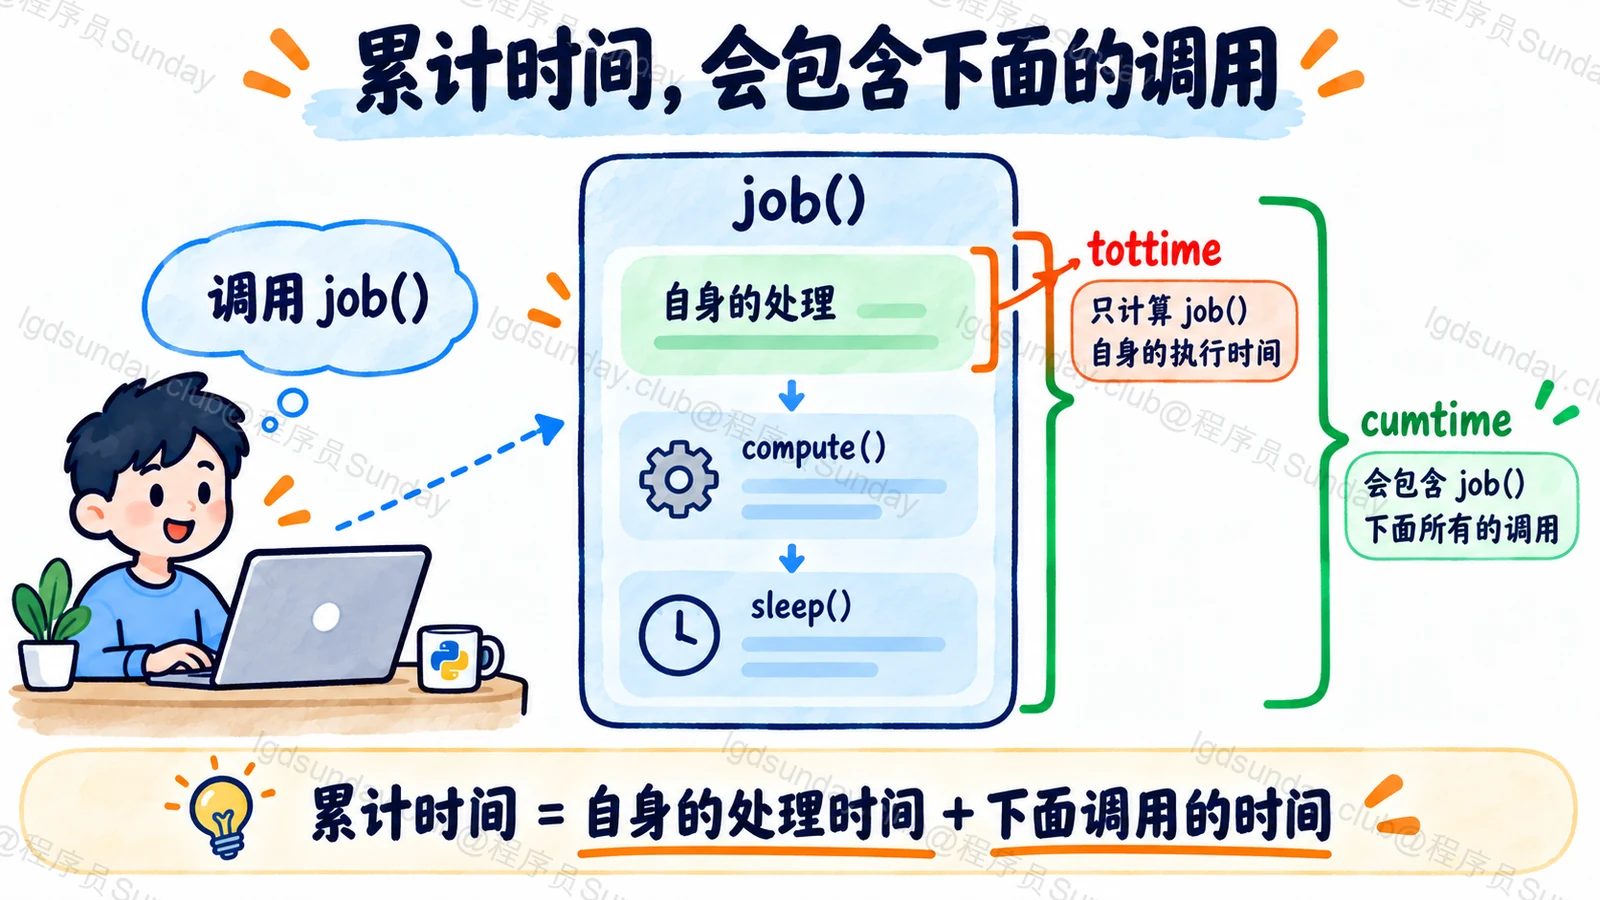
cProfile 可以统计函数调用次数及耗时。tottime 看函数自身花的时间,不含子调用;cumtime 包含子调用,可以帮助找到整条较慢的调用链。一个外层函数累计时间高,不代表它自己的代码最值得改。
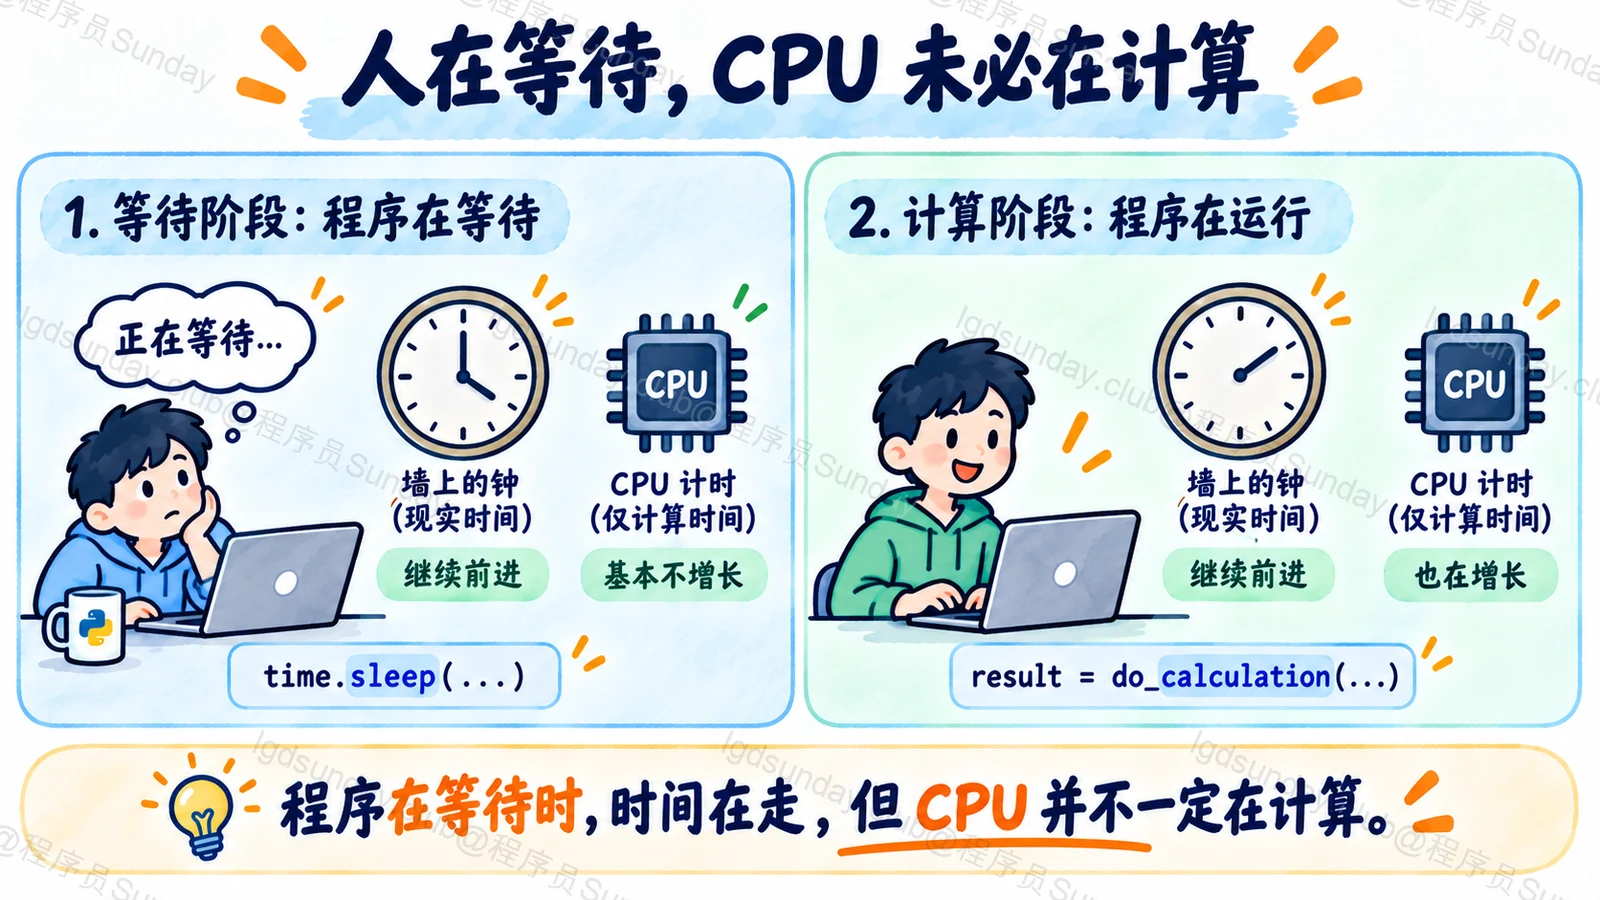
判断 CPU 还是等待,可以结合墙钟时间、进程 CPU 时间和服务链路观测。分析器本身也有开销,结果用于定位,优化效果再用相同输入单独测量。
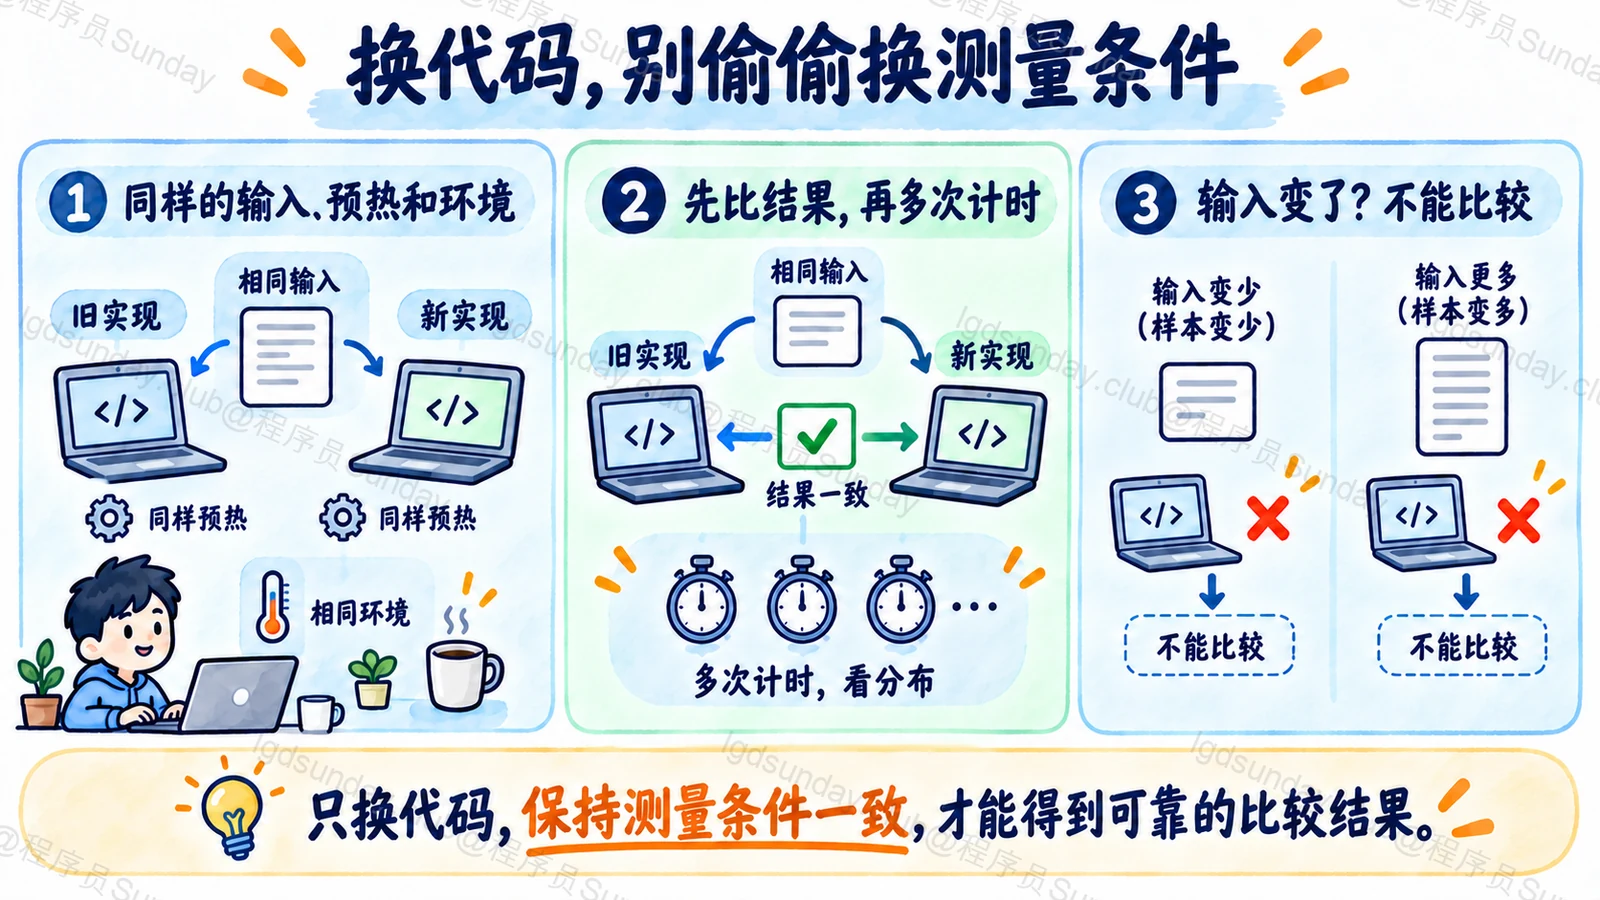
最后检查输出仍然正确,多次运行看差异,避免把缓存预热、数据变少或并发变化当成优化收益。
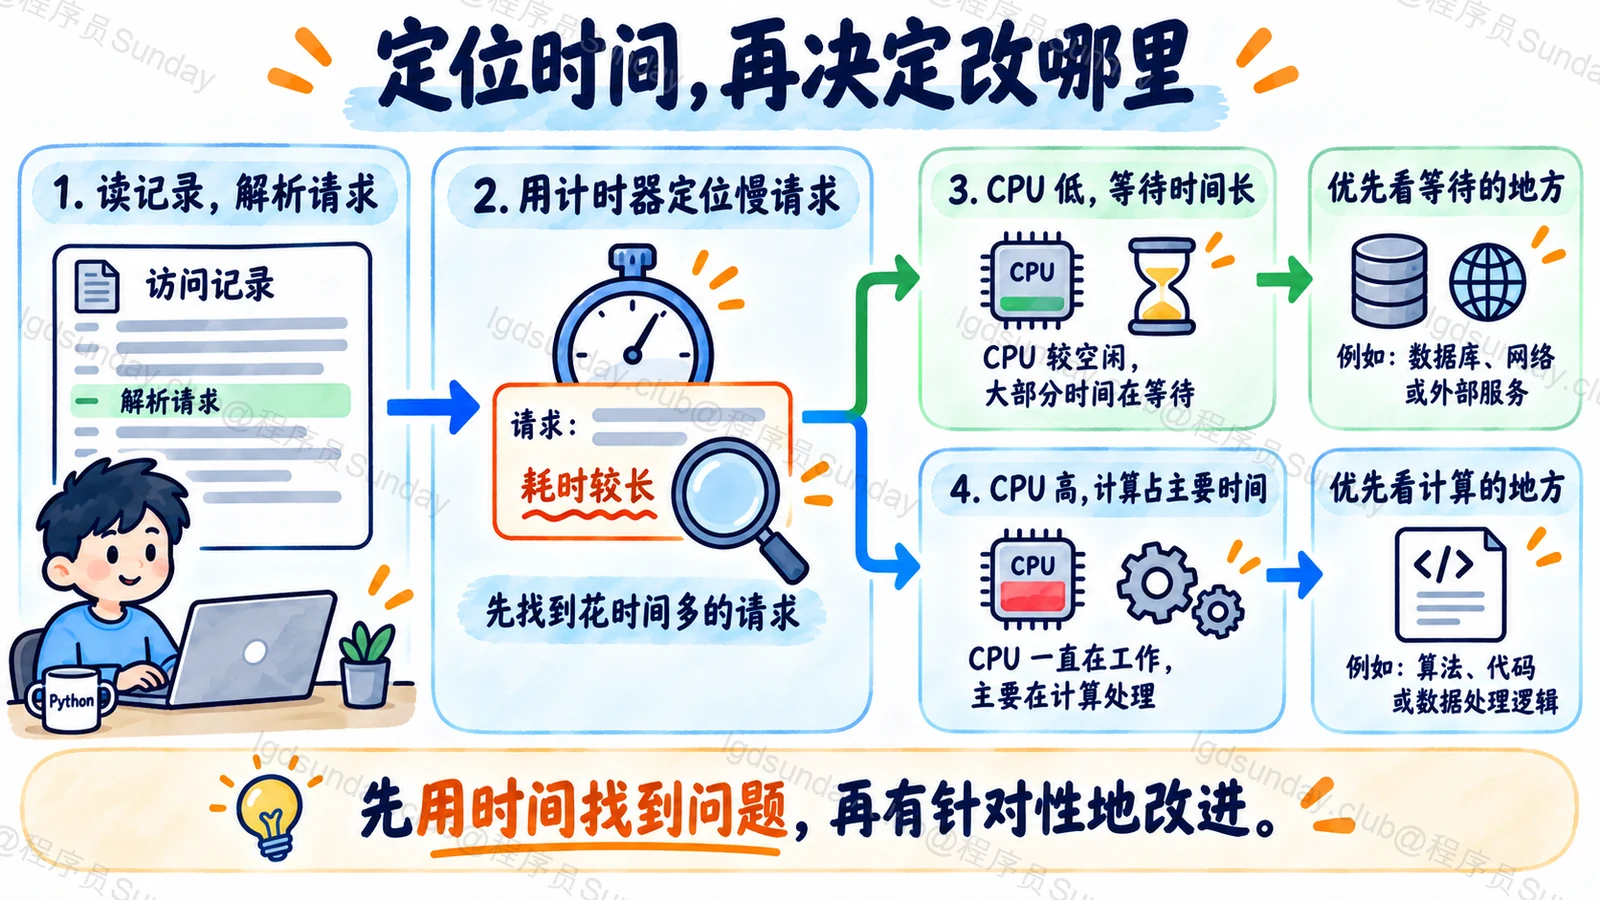
知识点详解:慢在自己,还是慢在被调用的函数
先把“慢”变成可重复的任务
假设一段程序读取记录、解析内容、整理结果,再请求一个远程接口。用户感觉等待太久,但慢的地方可能完全不同。
先保存一份固定输入,明确从哪里开始计时、到哪里结束。批处理可以看整批耗时,服务还要看不同阶段的延迟与请求分布。只有一次偶然变慢,先查输入量、外部等待和排队,不急着改函数。
同样要明确冷热状态。首次导入和初始化,与运行很多次后的缓存命中不是同一种测量。不能用冷启动的旧方案对比已经预热的新方案。
cProfile 的两列,回答不同问题
下面保存为 profile_demo.py。
Python
import cProfile
import pstats
from time import sleep

def compute():
    return sum(i * i for i in range(10000))

def job():
    value = compute()
    sleep(0.01)
    return value

with cProfile.Profile() as profiler:
    result = job()
assert result == 333283335000
pstats.Stats(profiler).strip_dirs().sort_stats("cumulative").print_stats(8)
tottime 统计函数自身时间,排除子函数;cumtime 把子调用也算进去。因此 job 的累计时间包含 compute 与 sleep,而它自身可能只做了很少几行组织工作。
报告中的父函数与子函数时间不能直接相加当作总耗时,这样会重复计算。调用次数也值得看,一个便宜函数被重复调用很多次,可能比单次昂贵函数更值得处理。本例只演示报告含义,不给机器无关的固定耗时。
等待久,CPU 可能并没有忙
墙钟时间是从开始到结束经过的实际时间,网络等待和 sleep 都会让它增长。进程 CPU 时间更接近进程实际消耗的计算时间,不把休眠等待算成同样的计算负担。
Python
from time import perf_counter, process_time, sleep
wall_start, cpu_start = perf_counter(), process_time()
sleep(0.02)
print("墙钟秒", perf_counter() - wall_start)
print("CPU秒", process_time() - cpu_start)
如果一条调用链很久,但 CPU 时间不高,应继续查等待对象。多线程、多进程和异步任务会让归属更复杂,不能拿一个进程的计数代表所有 worker。cProfile 也不直接解释远程接口内部发生了什么。
TypeScript(Node 两种时间的对照)
const start = process.hrtime.bigint();
const cpuStart = process.cpuUsage();
setTimeout(() => {
  const wallMs = Number(process.hrtime.bigint() - start) / 1e6;
  const cpu = process.cpuUsage(cpuStart);
  console.log({ wallMs, cpuMs: (cpu.user + cpu.system) / 1000 });
}, 20);
这段只比较时间口径,没有 TS 版 cProfile。定时器延迟也不是精确的性能承诺,实际数值按运行环境观察。
优化后,回到没有分析器的对照
分析器适合找方向,验证收益则重新跑同一份任务。检查结果和错误率是否变化,测量输入量、环境和预热策略保持一致,再看多次耗时分布。
假如慢在重复请求,减少请求次数可能比改循环有用;慢在解析计算,才进一步看算法、数据结构或实现。每次修改最好能说清它减少了哪部分工作,并保留原输入做回归。
依据:Python 性能分析器与统计字段、时间测量接口、Node CPU 时间。
面试官继续追问
累计时间最高的函数就必须重写吗?
先看它把时间花在哪些子调用上。外层只是组织流程时,重写它可能几乎没有收益。
分析报告能当基准测试成绩吗?
分析器会改变执行开销。定位与效果测量应分开,使用相同输入做独立对照。
CPU 不高却延迟大,还能从哪里查?
检查网络、数据库、锁等待、任务排队及各 worker 的实际负载,按具体等待对象找证据。
面试速记卡
- 先固定输入、范围和冷热状态。
- tottime 看自身,cumtime 包含子调用。
- 调用链的父子耗时不能重复相加。
- 墙钟与 CPU 时间帮助区分等待和计算。
- 优化要同时验证正确结果与同条件耗时。
公司面试真题
真题根据求职者公开面经整理,题意经过概括,非逐字原话或公司官方题库;本文为 Sunday 的独立解析。
网易 · 游戏服务端(天下、在线事业部) · 社招
Python 的 cProfile 如何使用,平时怎样分析运行效率?(题意整理)
网易游戏社招多篇面经 + 一些其他游戏公司面经 + 感悟 · 网易服务端部分 ↗
原帖编辑于 2020-06-25;仅取网易服务端段落腾讯 · 应用研究/算法 · 日常实习
Python 做性能分析可以使用什么库?(题意整理)
21届腾讯百度等算法日常实习面经 · 腾讯应用研究部分 ↗
原帖发布于 2019-08-28;21 届是作者届次,面试日期未明确