
pytest 的 parametrize 怎么用?参数化测试怎样覆盖正常、边界和异常输入?
下面是模拟面试对话,用来讲解本题,不是真实面经。
🧑💻 面试官:parametrize 有什么用?
🙋♂️ 我:用一份测试逻辑运行多组输入和预期。
🧑💻 面试官:我只放十组正常数据,算边界覆盖了吗?
🙋♂️ 我:还要根据合同加入零值、缺失和异常等情况。
🧑💻 面试官:两个 parametrize 叠起来产生多少组合?失败报告又怎么知道是哪条输入?
参数化减少重复代码,但测试数据仍要经过设计。一组输入最好对应一条明确的行为理由。
面试速答(60 秒版)
pytest.mark.parametrize 把多组参数交给同一个测试函数,让每组输入独立运行并报告结果。它适合相同合同下的正常、边界和异常用例。
数据不是越多越好。应该从规则出发,例如数量必须大于零,就检查最小合法值、零和负数。异常情况用 raises 验证异常类型,必要时再检查消息或错误字段。
ids 可以让报告显示有意义的用例名。多个参数化装饰器会形成组合,容易让数量成倍增长,所以只在组合确实有意义时使用。
参数对象也不会自动为每个测试深拷贝。可变输入若在测试里修改,可能影响后续用例,需要准备独立对象或配合 fixture。参数化负责运行矩阵,不替我们决定预期。
知识点详解:每一组数据,都应该能解释为什么需要
先把合同拆成输入范围
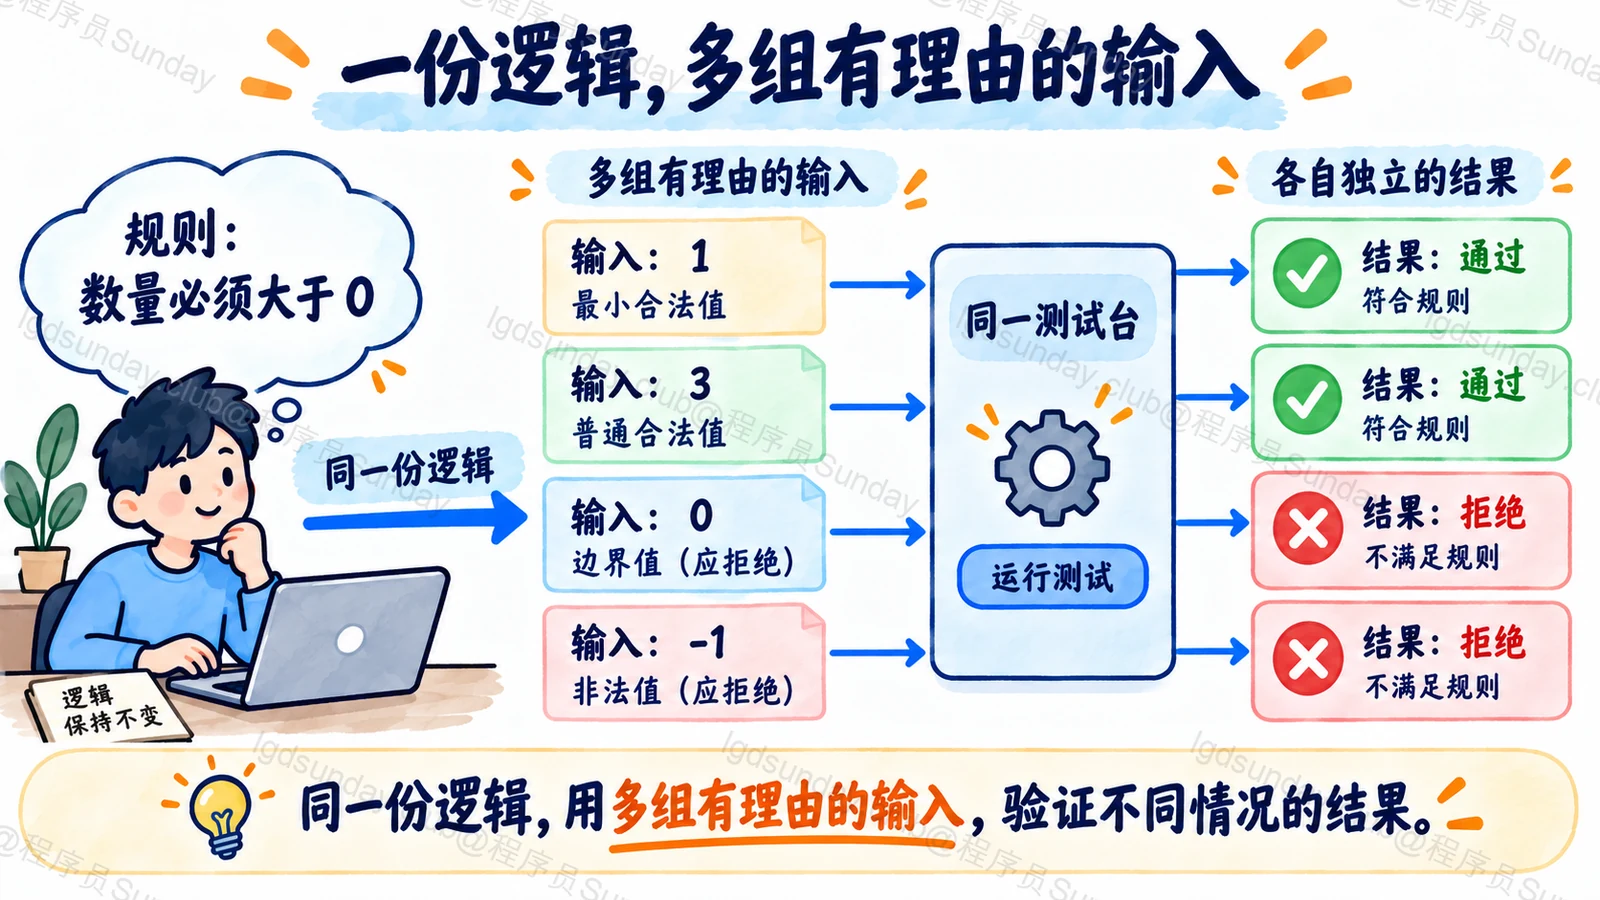
假设 normalize_quantity 要求数量大于零,合法时原值返回,非法时抛 ValueError。最小合法值 1 值得测,普通正数可以测,0 和负数分别验证拒绝。
这几条输入不是随机挑出的四个数字,各自对应规则上的位置。若还有上限,继续测上限及越界;若接受字符串,需要另列解析合同,别把自己没定义的转换当成默认功能。
参数化应当让这些理由更容易看到,不能把一大页数字放进去,却没人知道预期怎么算出来。
正常和异常,可以分成清楚的用例组
下面保存为 test_quantity.py。正常组比较值,非法组检查异常类型,失败报告用 ids 指明情况。
Python
import pytest

def normalize_quantity(value):
    if value <= 0:
        raise ValueError("数量必须大于零")
    return value

@pytest.mark.parametrize("value", [1, 3], ids=["最小合法值", "普通正数"])
def test_accepts(value):
    assert normalize_quantity(value) == value

@pytest.mark.parametrize("value", [0, -1], ids=["零", "负数"])
def test_rejects(value):
    with pytest.raises(ValueError, match="大于零"):
        normalize_quantity(value)
分开两类测试能让断言目的直观。也可以用 nullcontext 与 raises 组织混合表,但如果表里各种特殊开关比业务规则还多,拆开更好读。
异常消息可能是接口合同,也可能只是辅助文本。测试时要根据维护需求决定比对范围,不一定每次都锁死完整句子。
叠加参数化,会形成组合
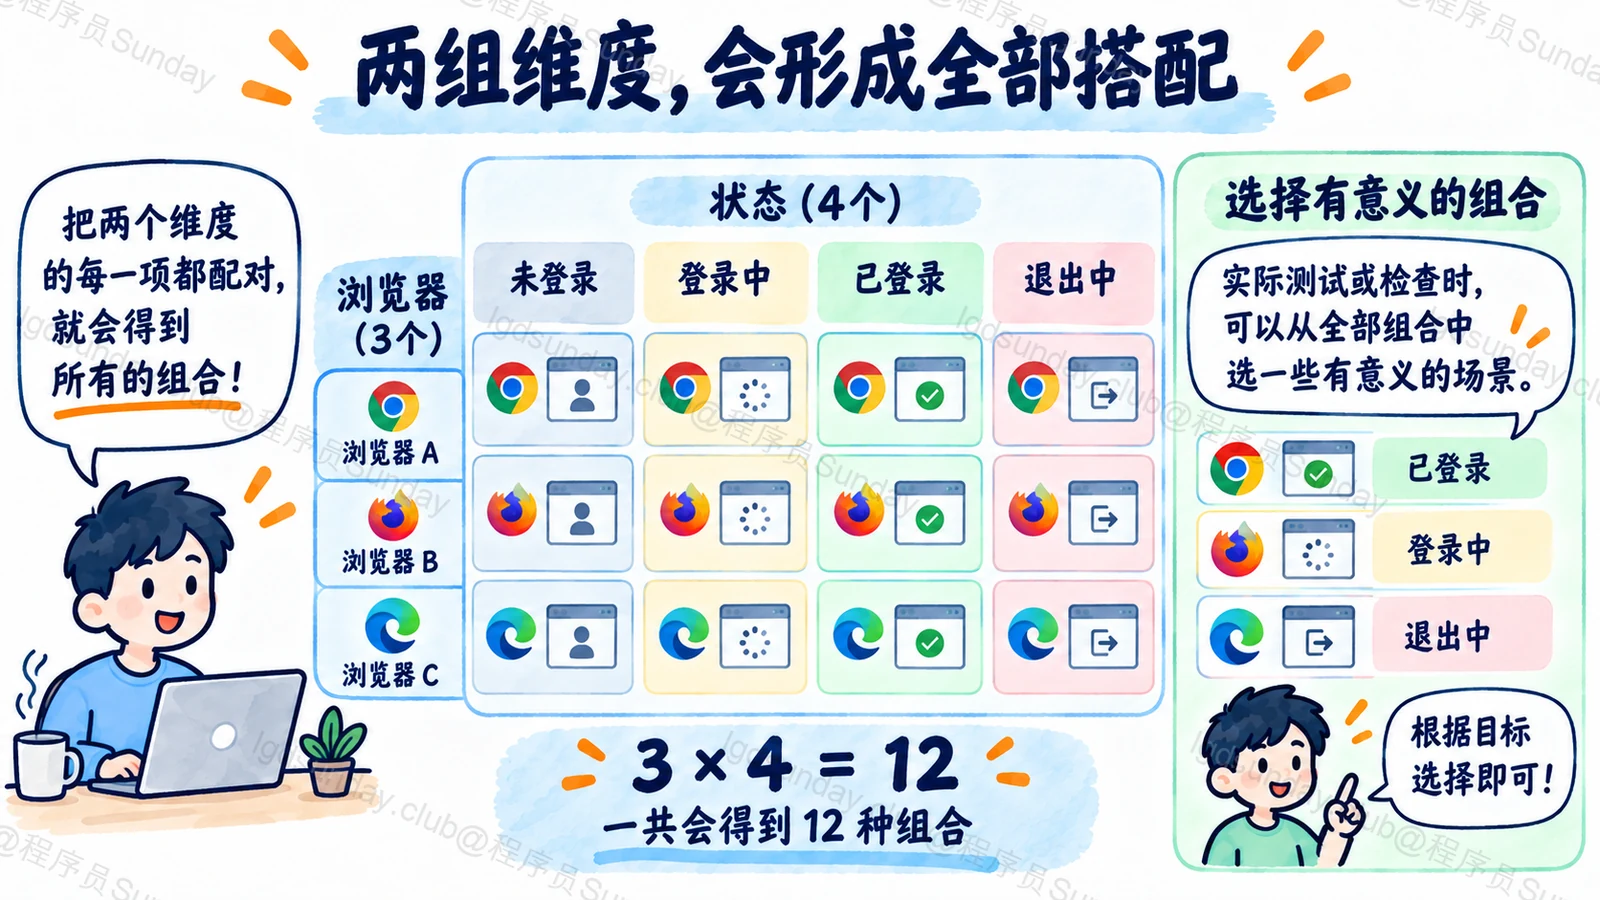
如果浏览器参数有三项,输入状态有四项,独立叠加通常形成十二种组合。数量增长来自乘积,不是把两张列表简单接起来。
只有确实需要验证所有搭配时,这种矩阵才有价值。大量不相关组合让测试变慢,也会让失败难解释。可以明确挑代表组合,把其他维度留给独立测试。
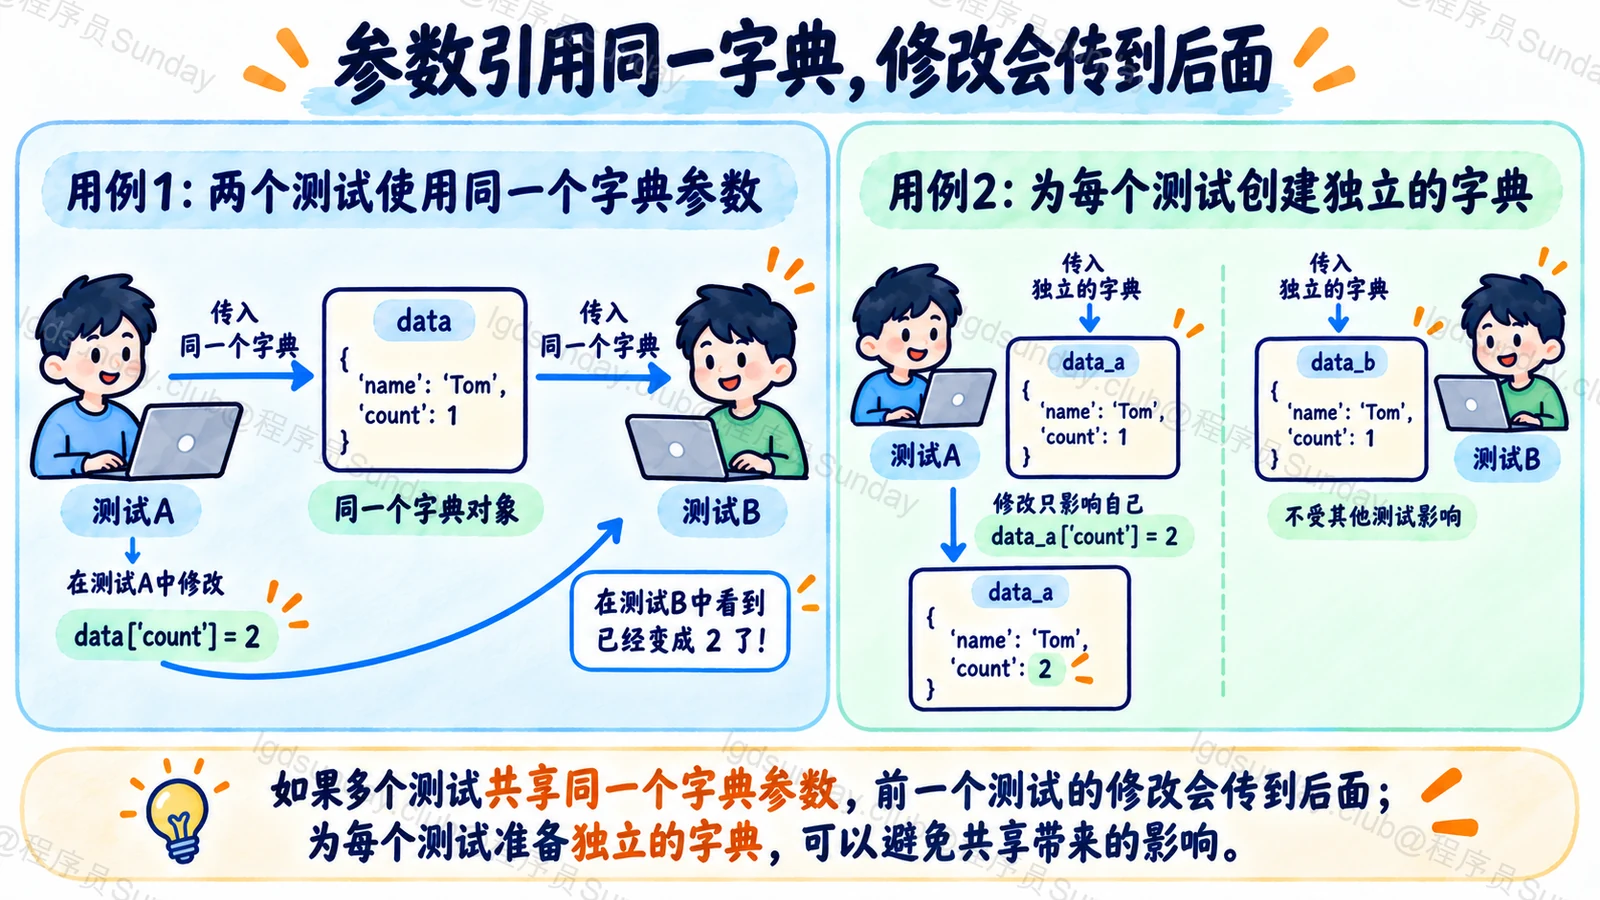
参数里的列表、字典会直接交给测试,并不会默认深拷贝。如果多组引用同一对象,又在测试里原地修改,后面可能拿到变化后的内容。使用对象工厂或独立数据能把状态隔离清楚。
TS 对照用真实测试运行器展开表
TypeScript(Node 表驱动测试)
import { test } from "node:test";
import assert from "node:assert/strict";

function normalizeQuantity(value: number): number {
  if (value <= 0) throw new Error("数量必须大于零");
  return value;
}
for (const value of [1, 3]) {
  test(`接受数量 ${value}`, () => {
    assert.equal(normalizeQuantity(value), value);
  });
}
for (const value of [0, -1]) {
  test(`拒绝数量 ${value}`, () => {
    assert.throws(() => normalizeQuantity(value), /大于零/);
  });
}
Node 这里用循环登记测试,不是 pytest 装饰器翻译。每条名字仍能找到对应输入,正常与异常断言保持同一合同。
复查一张参数表时,可以遮住实现,只看规则能否推出每个预期。如果只能抄当前函数输出当答案,那么代码错了,测试也可能跟着错。参数化提高组织效率,正确预期仍来自需求与独立判断。
依据:pytest 参数化、pytest raises、Node test runner。
面试官继续追问
参数化十个值就叫全面覆盖吗?
覆盖要对应合同分区和错误路径,十个相近正常值未必覆盖一个关键边界。
两个装饰器是相加还是组合?
通常形成笛卡尔组合,所以要检查数量和每种组合的意义。
共享一份字典作为参数安全吗?
测试若修改它可能影响后续使用,pytest 不默认深拷贝所有参数,需要独立数据或明确恢复。
面试速记卡
- parametrize 复用测试逻辑,逐组输入独立报告。
- 测试数据从合同边界和失败路径选择。
- ids 帮助定位具体输入。
- 多层参数化通常形成组合,数量按乘积增长。
- 可变参数不自动深拷贝,状态隔离需安排。
公司面试真题
真题根据求职者公开面经整理,题意经过概括,非逐字原话或公司官方题库;本文为 Sunday 的独立解析。
晓多科技 · 软件测试 · 原帖未明确批次
pytest 怎样实现参数化测试?(题意整理)
晓多科技 软件测试面经 ↗
原帖发布于 2024-08-01