
Python 的 itertools.groupby 怎么分组?为什么相同的 key 会出现多组?
下面是模拟面试对话,用来讲解本题,不是真实面经。
🧑💻 面试官:itertools.groupby 可以像 SQL GROUP BY 那样合并同 key 吗?
🙋♂️ 我:它按连续的相同 key 分组,数据顺序会影响结果。
🧑💻 面试官:A、B、A 这三个 key,会得到几组?
🙋♂️ 我:三组,后面的 A 不会自动回到第一组。
🧑💻 面试官:那我把每个 group 迭代器保存起来,等外层循环结束再读,为什么可能读不到数据?
groupby 沿着一条共享输入往前走,只切连续段。组的迭代器还跟着这条输入走,不是提前独立保存的桶。
面试速答(60 秒版)
itertools.groupby 根据相邻元素的 key 是否相同来切分连续组。输入 A、B、A 会产生三个组,不会自动合并两个不相邻的 A。
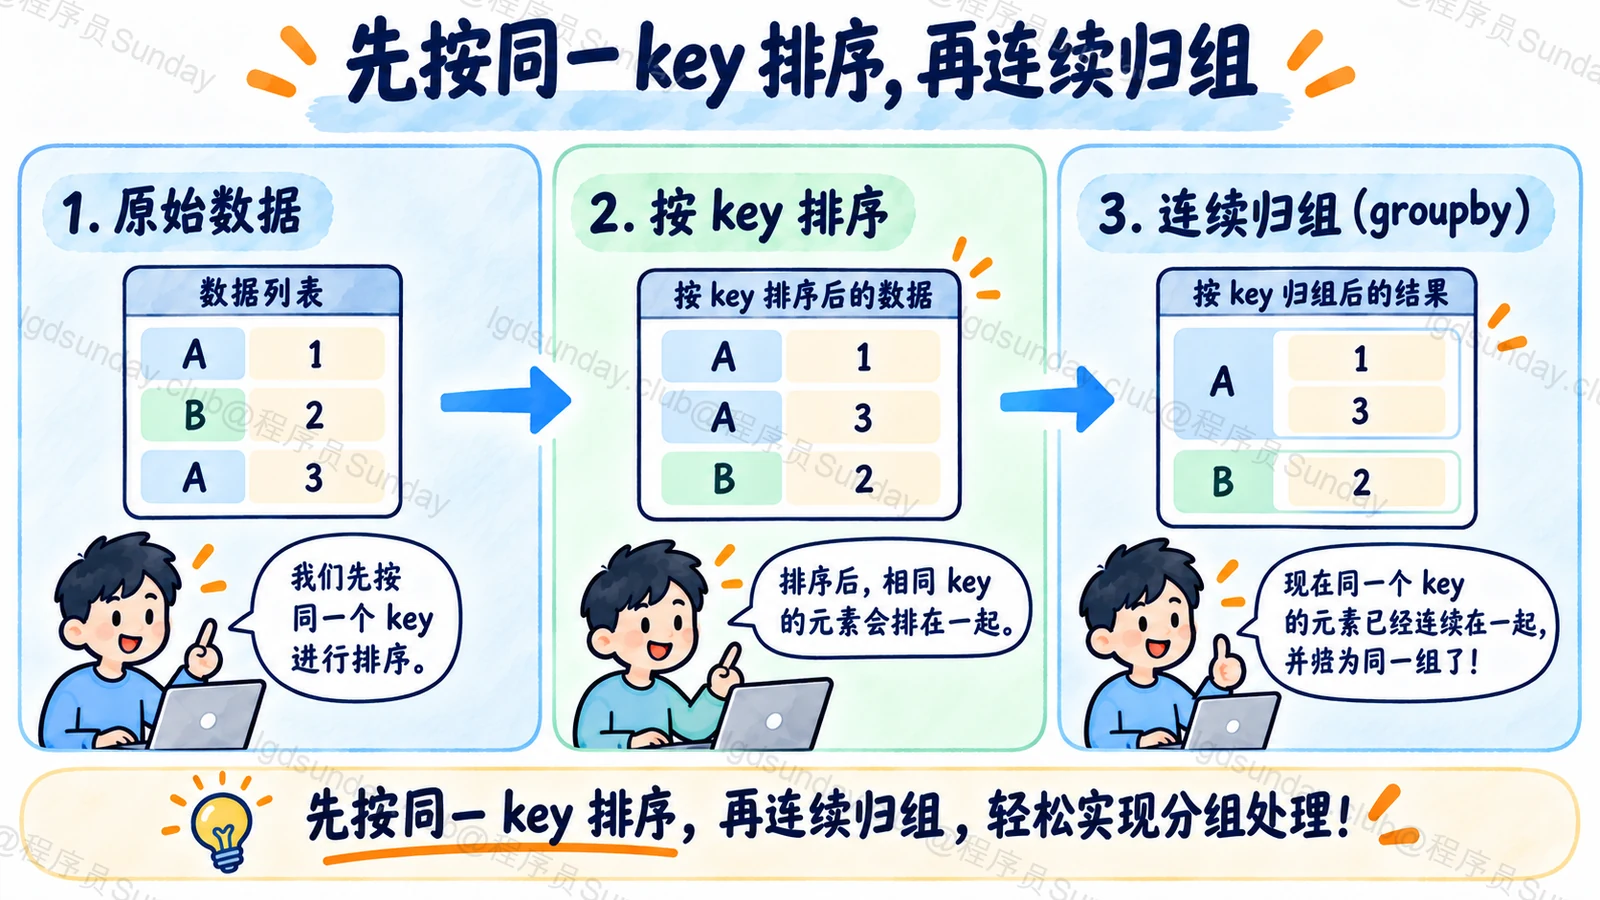
如果希望按 key 合并全部数据,可以先按同一个 key 排序,再 groupby,或者直接使用字典收集。排序会改变原顺序,也要消耗相应资源,不能说流式分组天然不需要准备。
groupby 返回的每组是迭代器,和外层共用输入。外层继续推进以后,前一组未消费的内容可能已经被跳过,因此需要后续保留时,应当当场把该组收集成列表。
选择时我会先确定需要连续段,还是全局归组,再决定是否排序和是否保留所有成员。
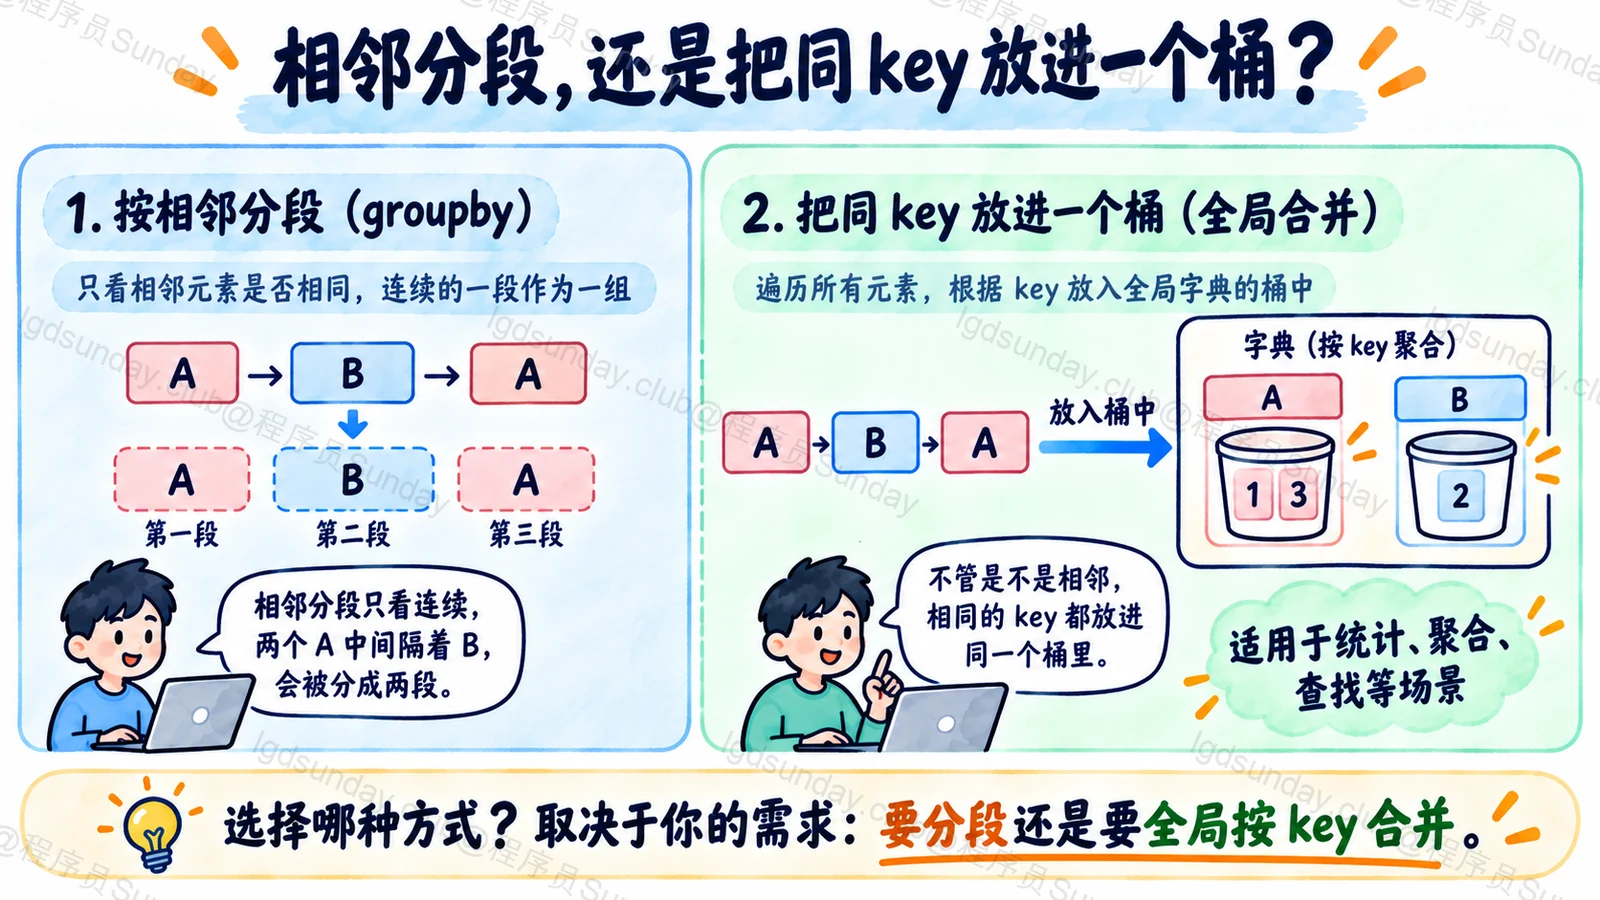
知识点详解:连续分段和全局归组,输入顺序决定区别
groupby 发现 key 改变,就开始下一组
假设事件记录依次是 A1、A2、B1、A3。groupby 按第一个字段判断,先产生 A 组包含 A1、A2,再产生 B 组,最后又产生一个 A 组。
这个行为很适合把已经按时间排列的状态记录切成连续区间。它不会为了最后的 A3 回头修改第一个组,也不会自动建立一个全局 A 桶。
SQL 的聚合分组和这个连续迭代器工具,名字相似但合同不同。面试时先讲“相邻相同”,比直接说“Python 的 GROUP BY”更准确。
要合并所有 A,先改变输入或换工具
下面先观察原顺序,再按相同 key 排序后归组。每一组都立即收集,所以后续不会只拿到过期的组迭代器。
Python
from itertools import groupby
from operator import itemgetter

rows = [("A", 1), ("B", 2), ("A", 3)]
key = itemgetter(0)

segments = [(name, list(group)) for name, group in groupby(rows, key)]
merged = [
    (name, list(group))
    for name, group in groupby(sorted(rows, key=key), key)
]
print(segments)  # A、B、A 三段
print(merged)    # A 两项,B 一项
排序和分组必须采用相匹配的 key。按时间排序,再按类型 groupby,并不能保证同类型已经相邻。
如果要保留输入顺序,同时收集每个 key 的全部成员,用 dict 或 defaultdict 累加通常更直接。它会保存成员,内存使用也需要跟着总量考虑。
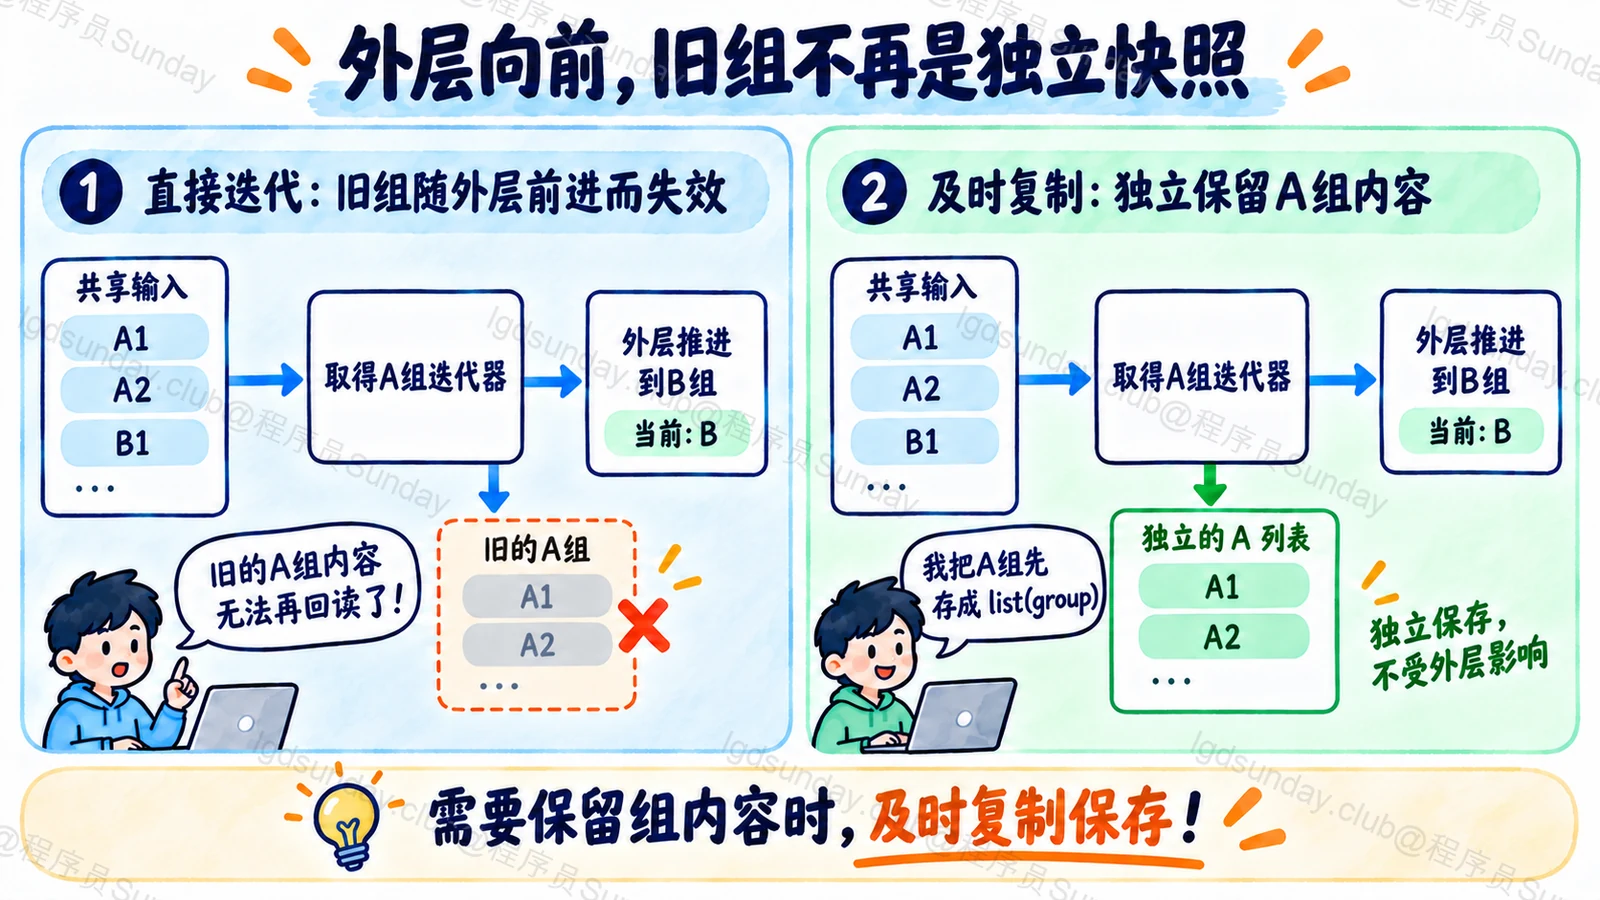
每组迭代器,和外层共用输入
拿到第一组以后,外层如果继续 next,就需要往后找下一组。这个推进过程会越过第一组剩下的成员。旧组迭代器随后再读,可能已经没内容。
因此保存 (key, group) 对,并不等于保存了这一组的所有数据。需要独立保留,就在切到下一组以前 list(group),或马上完成这组的处理。
这和“生成器保存数据快照”一样容易误解。这里保存的是继续读的能力,输入已经往前走,就不能凭空重新读回过去的成员。
TypeScript 可以用显式桶表达另一种合同
TypeScript(按 key 全局收集,不是连续 groupby)
const rows: Array<[string, number]> = [["A", 1], ["B", 2], ["A", 3]];
const groups = new Map<string, Array<[string, number]>>();
for (const row of rows) {
  const items = groups.get(row[0]) ?? [];
  items.push(row);
  groups.set(row[0], items);
}
console.log(groups.get("A")); // [["A",1],["A",3]]
这段建立独立桶,所以两个 A 会合并,行为故意不同。JS 不同版本与库的 groupBy 接口也有自己的返回结构,本题不用同名就声称等同 itertools.groupby。
验证时用 A、B、A 和 A、A、B 两份输入,再测试保存旧 group 但外层继续推进的情况。三个结果能说明需要的是连续段、全局桶,还是独立结果副本。
依据:Python 3.11 itertools.groupby、operator.itemgetter、collections.defaultdict。
面试官继续追问
先 sorted 就一定能按任意 key 合并吗?
排序键要让分组键相同的元素相邻,通常直接使用同一个 key。还要看键是否可比较以及数据规模。
只保留 group 引用,算保存了一组吗?
不算独立保存成员。组与外层共享输入,后续推进会影响旧组可读内容。
流式 groupby 能处理全局无限归组吗?
它能沿连续输入分段处理,不会无限保存所有 key 的全部成员。全局归组的资源与结束条件需要另一设计。
面试速记卡
- groupby 切相邻同 key 的连续段。
- A、B、A 会产生三个组。
- 全局合并可先按同 key 排序,或用桶收集。
- 组迭代器与外层共用输入。
- 要后续保留成员,应及时收集成独立结果。
公司面试真题
这道题暂未收录可核验的公司真题来源。你可以先阅读本文解析,或浏览已收录的公司面试真题。
浏览公司面试真题 →