
Python 的 read、readline、readlines 有什么区别?大文件应该怎么读取?
下面是模拟面试对话,用来讲解本题,不是真实面经。
🧑💻 面试官:read、readline 和 readlines 有什么区别?
🙋♂️ 我:read 读内容,readline 读一行,readlines 返回行列表。
🧑💻 面试官:用 for line in file 就一定只占很少内存吗?
🙋♂️ 我:还要看单行大小,以及处理后有没有把所有行保存起来。
🧑💻 面试官:那二进制分块读取文本,中文字符刚好跨块怎么办?
大文件读取要同时看一次拿多少、拿到后留多久。换成循环,不会自动消除单行过大或结果全部累计的问题。
面试速答(60 秒版)
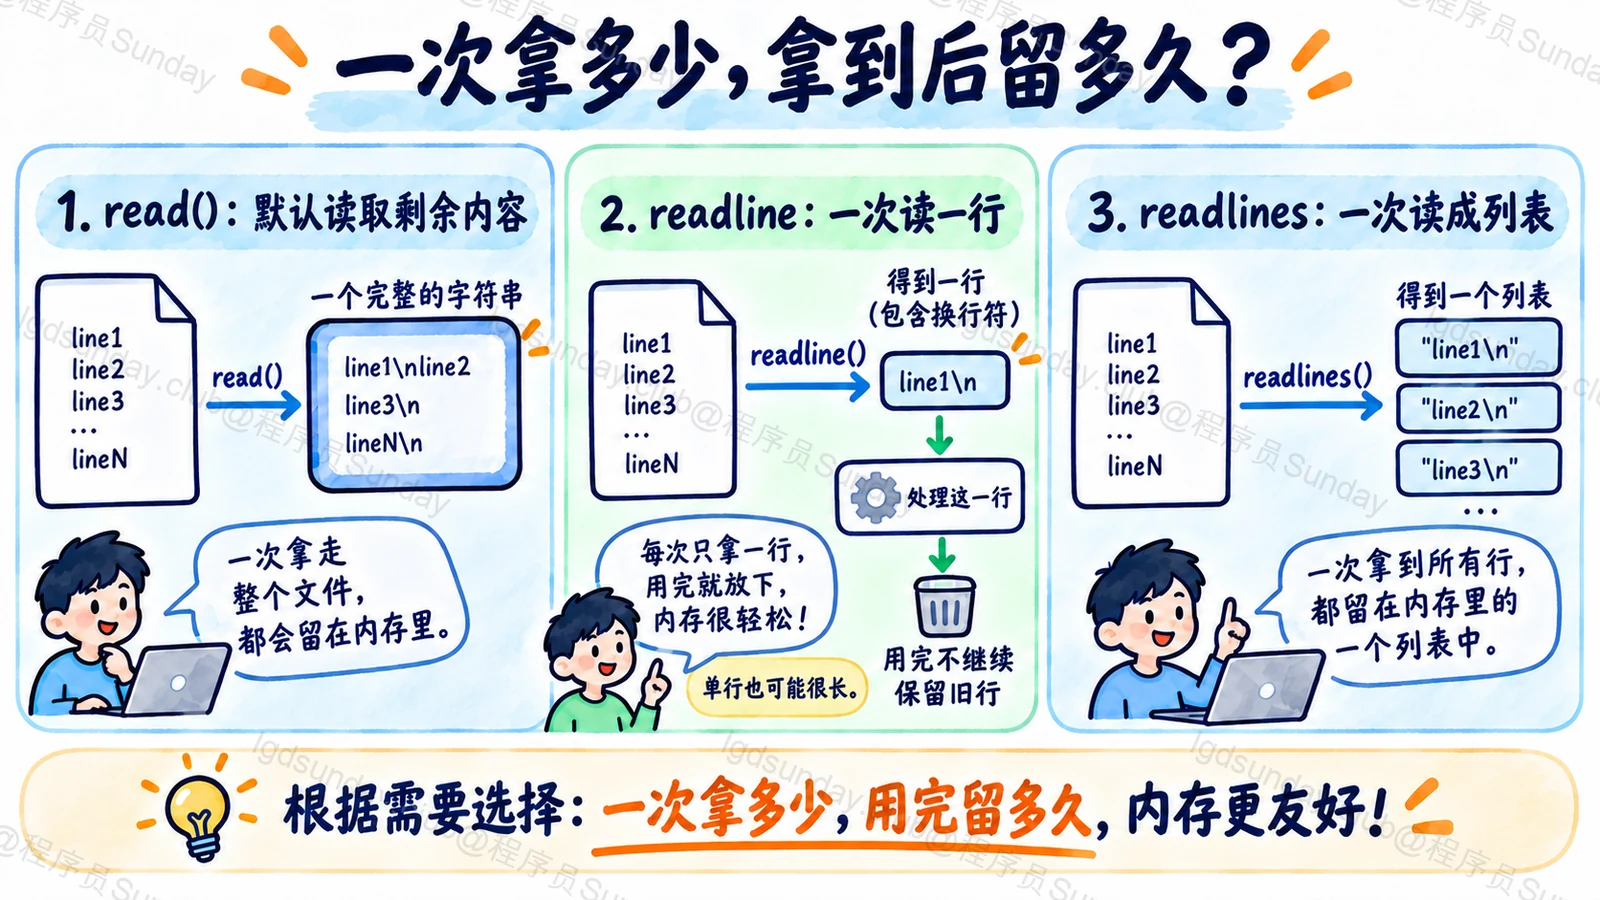
read 不给大小时通常读取剩余内容;readline 读取一行;readlines 返回行列表,可能一次保留大量字符串。文件迭代也按行提供内容,适合逐行处理。
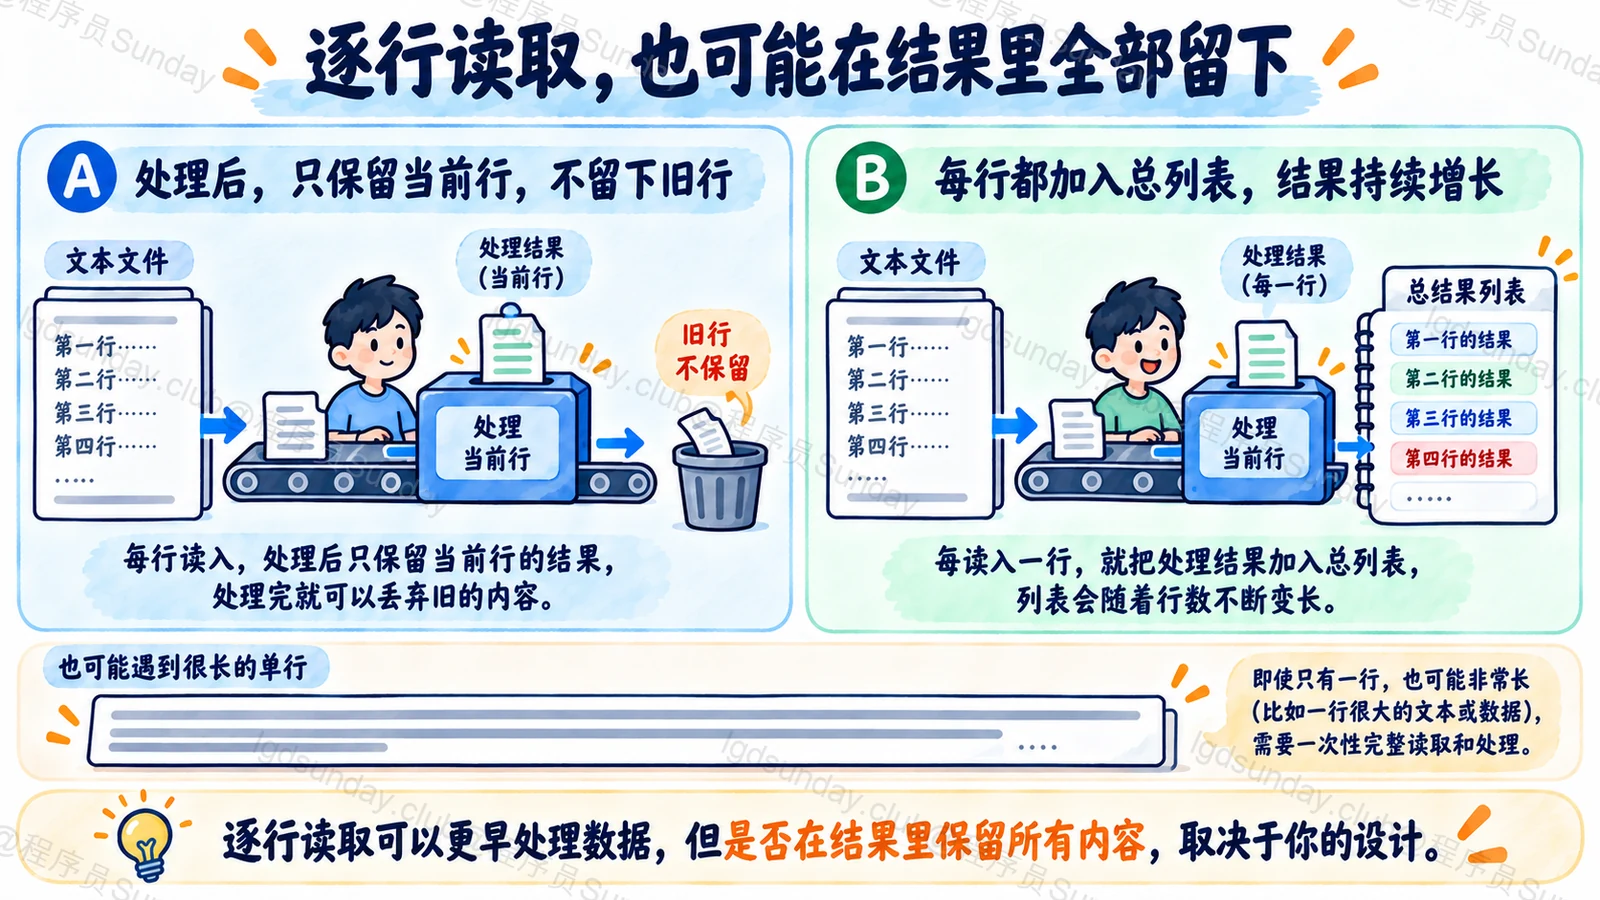
大文件我会根据数据格式选择按行或按块读取,并及时处理、释放已消费内容。单行特别长时,逐行也可能占很多内存;循环里又把每行 append 到总列表,仍会把数据积起来。
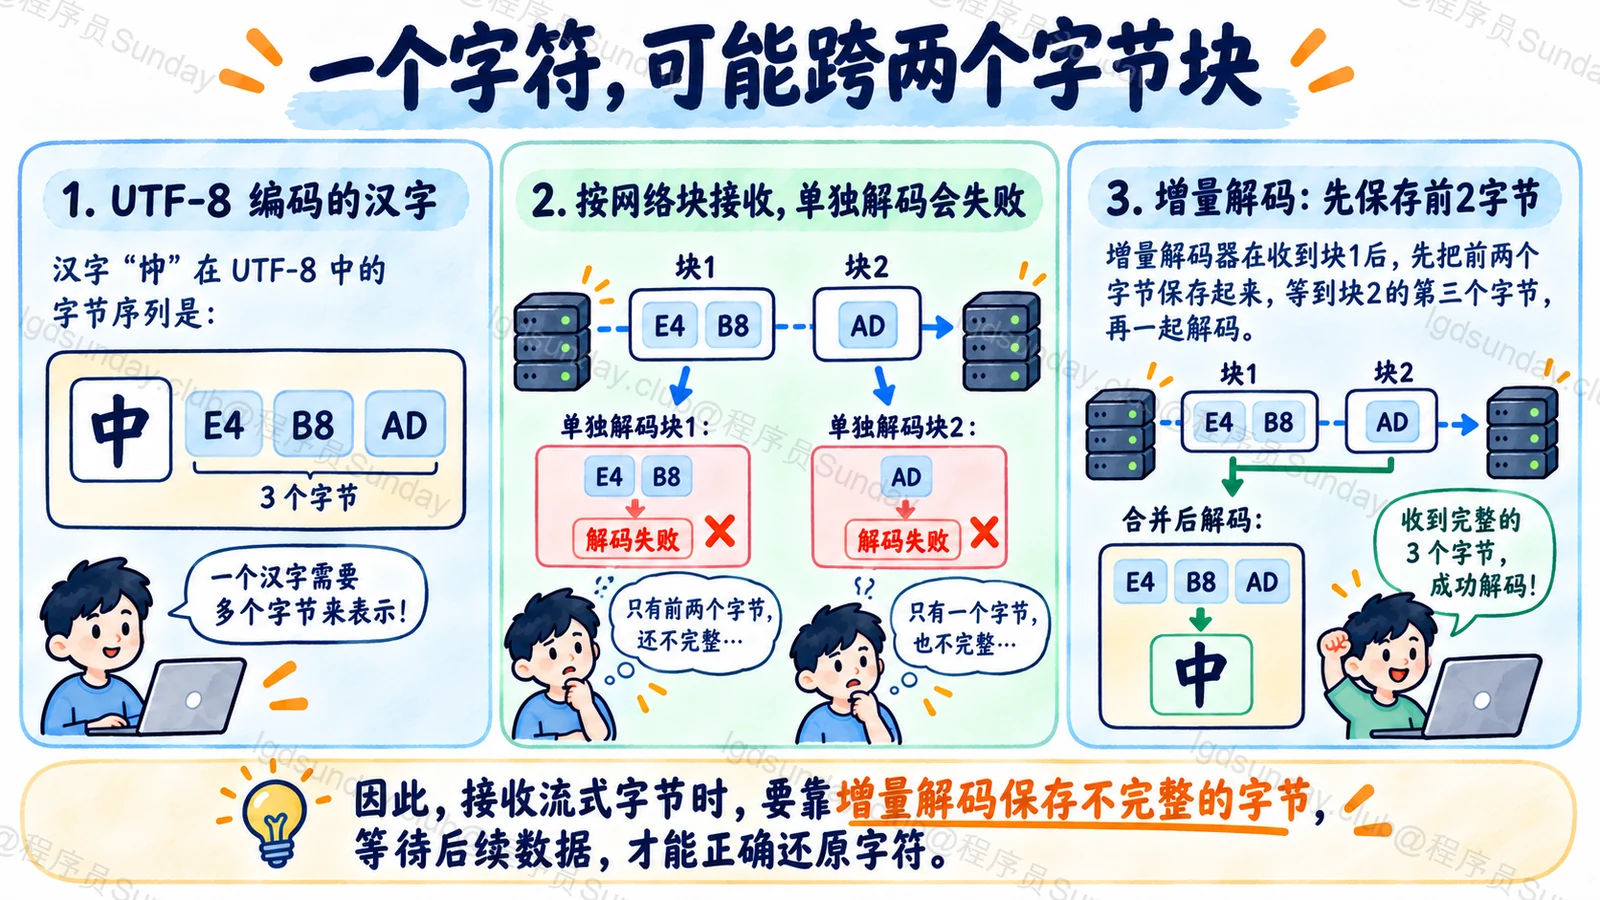
文本模式处理解码,read 的数量按字符理解;二进制模式返回字节,分块大小按字节。自己按字节切 UTF-8 时,不能每块独立 decode,字符可能跨块,需要增量解码或文本流。
还要明确编码、换行和关闭方式。读取完毕只是拿到内容,解析错误与输入资源限制仍要处理。
知识点详解:读取粒度和数据保留,决定内存使用
三个读取接口,返回形态不同
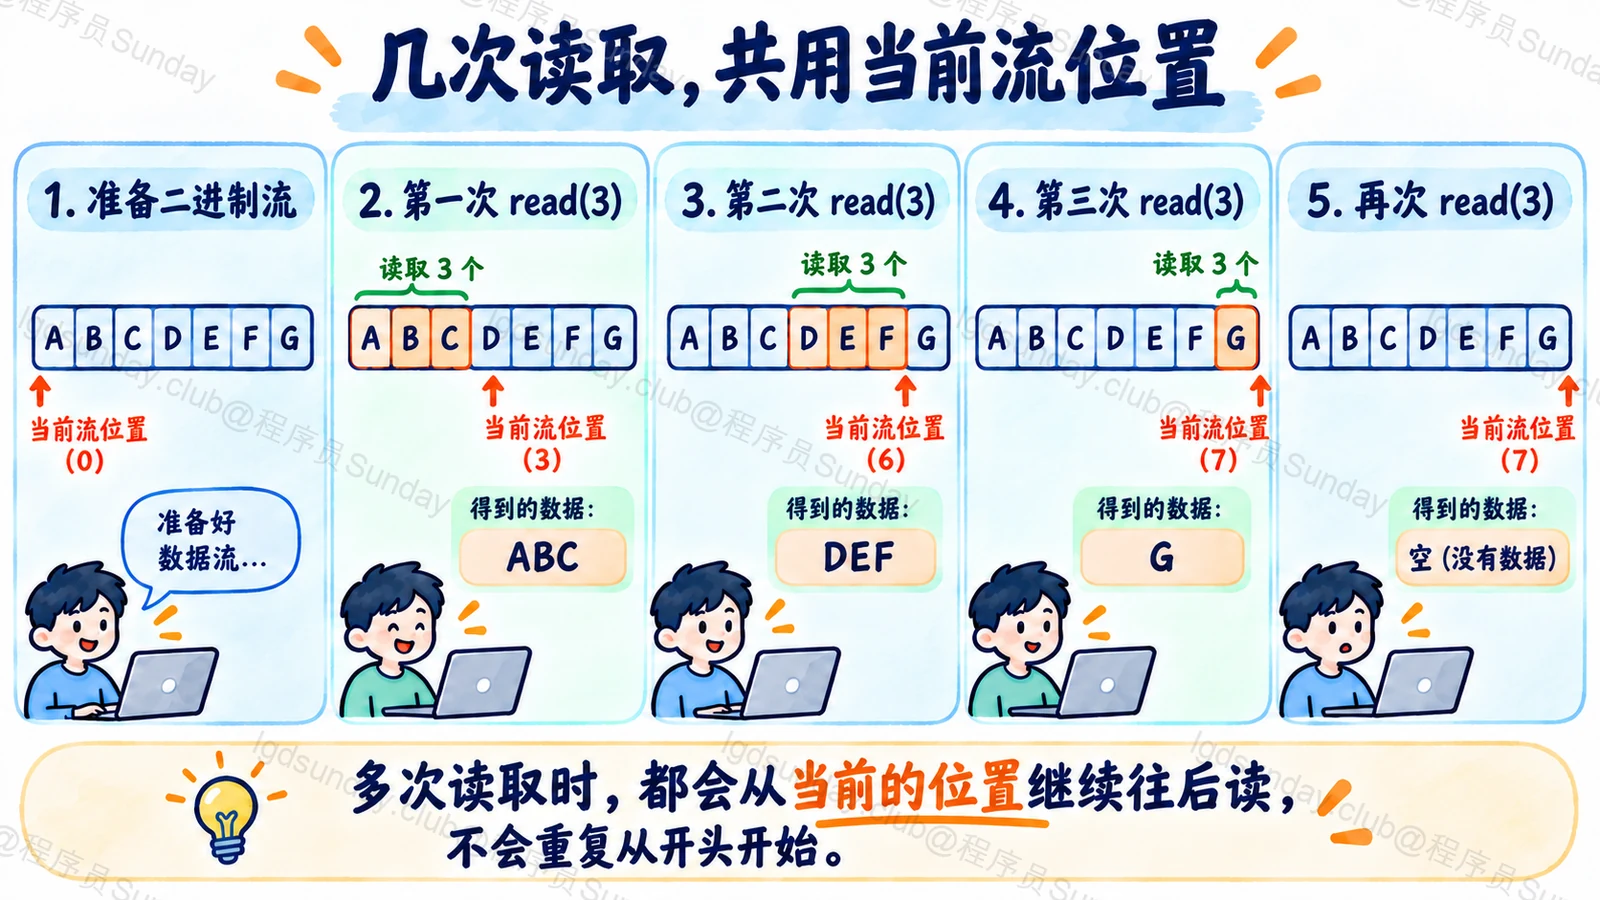
假设日志有三行。read 把剩余文本作为一个字符串返回,readline 给下一行,readlines 收集为一组行字符串。它们共享流的当前位置,前面已经读过的内容不会自动从头再给一次。
readline 读到的行通常保留换行符;末尾没有换行也可能得到正常最后一行。到达文本流结尾返回空字符串,不能把一个只有换行的空白行同结尾混淆。
用 StringIO 可以先观察这些行为,不必为了理解 API 先找一个几百 MB 文件。
迭代提供行,不代表所有工作都流式
下面每个例子重新建立流,所以能比较各自结果。最后一个循环处理一行就输出,不建立完整行列表。
Python
from io import StringIO, BytesIO

text = "第一行\n第二行\n末行"
print(StringIO(text).read())
print(repr(StringIO(text).readline()))  # '第一行\n'
print(StringIO(text).readlines())

with StringIO(text) as stream:
    for line in stream:
        print(line.rstrip("\n"))

with BytesIO(b"ABCDEFG") as stream:
    while chunk := stream.read(3):
        print(chunk)  # b'ABC', b'DEF', b'G'
真实文件可以用 with open(path, encoding=“utf-8”),按合同选编码。如果循环里继续把全部内容留在列表,内存仍会随总量增加;如果一行本身巨大,也要选择限长或按块解析。
文本字符和二进制字节,不能直接等同
UTF-8 中文通常由多个字节组成。假设每次从二进制流取两字节,一个字符可能被截成两块;分别 decode 会失败,忽略错误又可能丢字符。
文本流会结合解码器管理这类边界。需要自己处理原始字节时,可以使用增量解码器,并正确完成末尾处理。流式 JSON 或其他结构数据,还需要能跨块保存解析状态,不能把每块都当作一份独立完整文件。
按行、按块都只是读取策略,是否能流式解析还取决于格式。一次 json.load 一个巨大对象,后面仍可能建立完整对象结构。
Node 的行流与 Python 返回形态不同
TypeScript(Node 按行读取)
import { createReadStream } from "node:fs";
import { createInterface } from "node:readline";

async function main(): Promise<void> {
  const input = createReadStream("example.txt", { encoding: "utf8" });
  const lines = createInterface({ input, crlfDelay: Infinity });
  try {
    for await (const line of lines) console.log(line);
  } finally {
    lines.close();
    input.destroy();
  }
}
void main();
这个例子需要自行准备 UTF-8 example.txt。Node readline 提供的行文本通常不含终止换行,和 Python 的行迭代细节不同。错误路径还应按所用 Node 版本和流合同处理,不能机械翻译函数名。
判断内存是否受控时,测不同文件大小、单行长度和结果保留方式。把“读取缓冲、解析状态、累计结果”分开观察,才能知道哪一层真正增长。
依据:Python 3.11 I/O、文件读写教程、增量解码器、Node readline。
面试官继续追问
readlines 的 hint 是严格字节上限吗?
不是简单的硬字节配额。具体接口按累计行大小提示停止等规则工作,不能用它保证全流程固定内存。
逐行读后转 list 还能省内存吗?
最终仍收集所有行。它可能保留迭代方便性,但不能借此承诺内存不随文件增长。
二进制 read(3) 是三字符吗?
是至多相应字节数。文本模式按字符处理,编码后的字节数量可能不同。
面试速记卡
- read 不限大小通常取得剩余内容。
- readline 一行,readlines 收集行列表。
- 文件循环仍可能被巨型单行或累计结果拖大内存。
- 文本字符与二进制字节粒度不同。
- 跨字节块解码需保留解码状态。
公司面试真题
真题根据求职者公开面经整理,题意经过概括,非逐字原话或公司官方题库;本文为 Sunday 的独立解析。
虾皮 · 运维(原帖标签) · 校招
Python 的 read、readline、readlines 有什么区别?(题意整理)
shopee 2面面经(凉透了) ↗
原帖编辑于 2020-03-24百度 · 算法 · 日常实习
readline 和 readlines 有什么区别?(题意整理)
21届腾讯百度等算法日常实习面经 · 百度部分 ↗
原帖发布于 2019-08-28;21 届是作者届次,面试日期未明确