
Python logging 为什么会重复打印?Logger、Handler 和 propagate 是什么关系?
下面是模拟面试对话,用来讲解本题,不是真实面经。
🧑💻 面试官:logging 为什么会重复打印?
🙋♂️ 我:可能加了多个 Handler,或者日志又传到父 Logger。
🧑💻 面试官:子 Logger 已经输出一次,propagate=True 又会做什么?
🙋♂️ 我:同一条记录还会交给祖先 Logger 的 Handler。
🧑💻 面试官:把父 Logger 级别提高,能不能保证拦住所有从子级传来的记录?
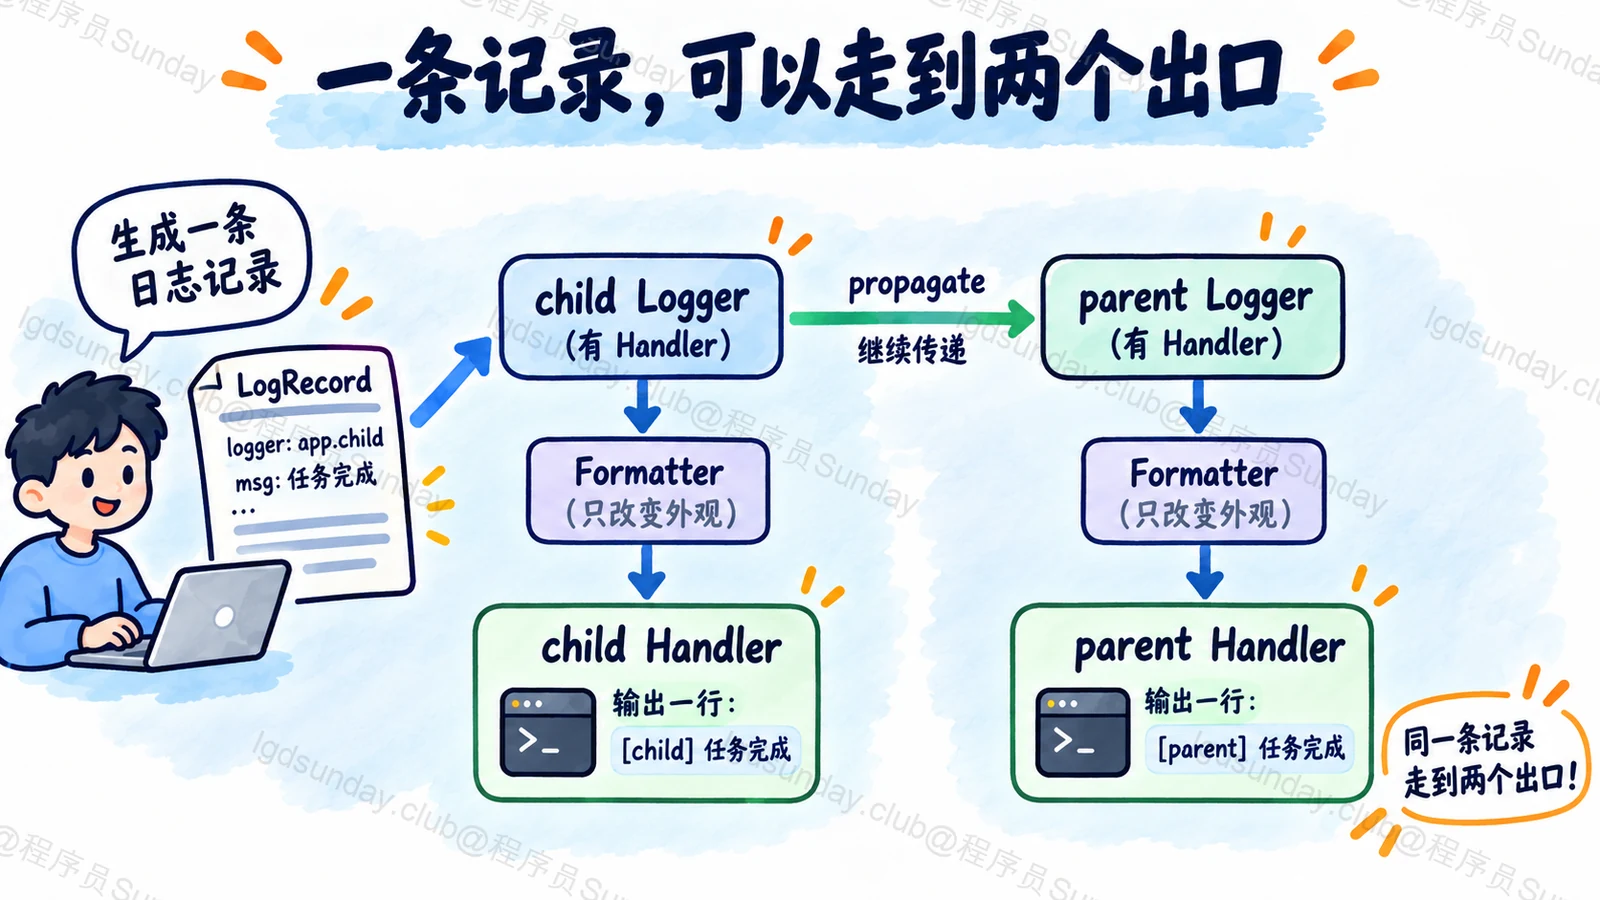
先把一条日志记录的路线画出来。记录可能没有生成两次,却在两个出口各输出了一次。
面试速答(60 秒版)
Logger 负责接收日志调用并决定是否产生记录,Handler 负责把记录写到终端、文件等位置,Formatter 决定展示格式。
重复输出常见于两种情况,一是在同一个 Logger 上重复添加 Handler;二是子 Logger 有 Handler,同时 propagate=True,记录又交给祖先的 Handler。
排查时我会查看名字层级、实际 Handler 和传播路线,而不是只改日志文本。
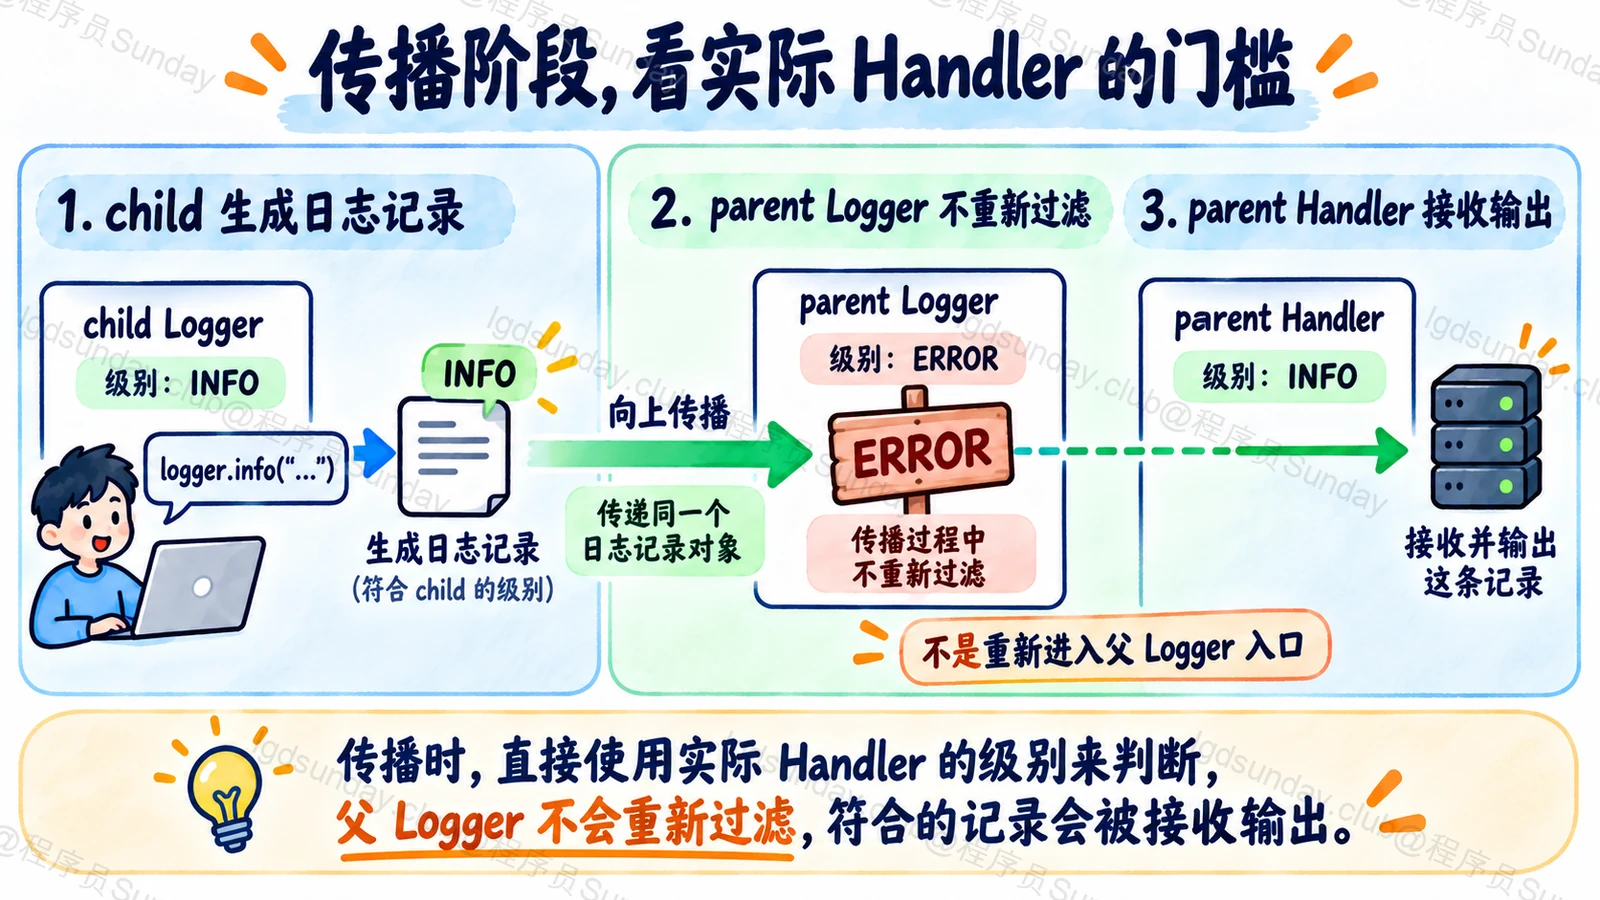
传播到祖先时,记录直接交给祖先 Handler,不会重新按祖先 Logger 的级别和过滤器做完整入口判断。所以输出门槛还要检查 Handler 级别。
通常应用集中配置出口,业务模块只 getLogger(name);需要某模块独立输出时,再明确是否停止传播。库也不要擅自替应用重复配置 root。
知识点详解:同一条记录,为什么走到多个输出出口
Logger、Handler 和 Formatter 分别做什么
假设模块 logger 名为 demo.service。logger.info 接受消息,如果当前有效级别允许,就生成记录。记录再交给相应 Handler,后者可以分别写到终端或文件。
Formatter 决定时间、级别和消息怎样排列,不决定是不是又生成一条业务日志。输出两行同内容,可能只有一条记录,只是被两个 Handler 展示。
因此看日志重复,先画出口数量。不要看到两行就认定业务函数执行了两次。
子级输出后,还可以继续向上传播
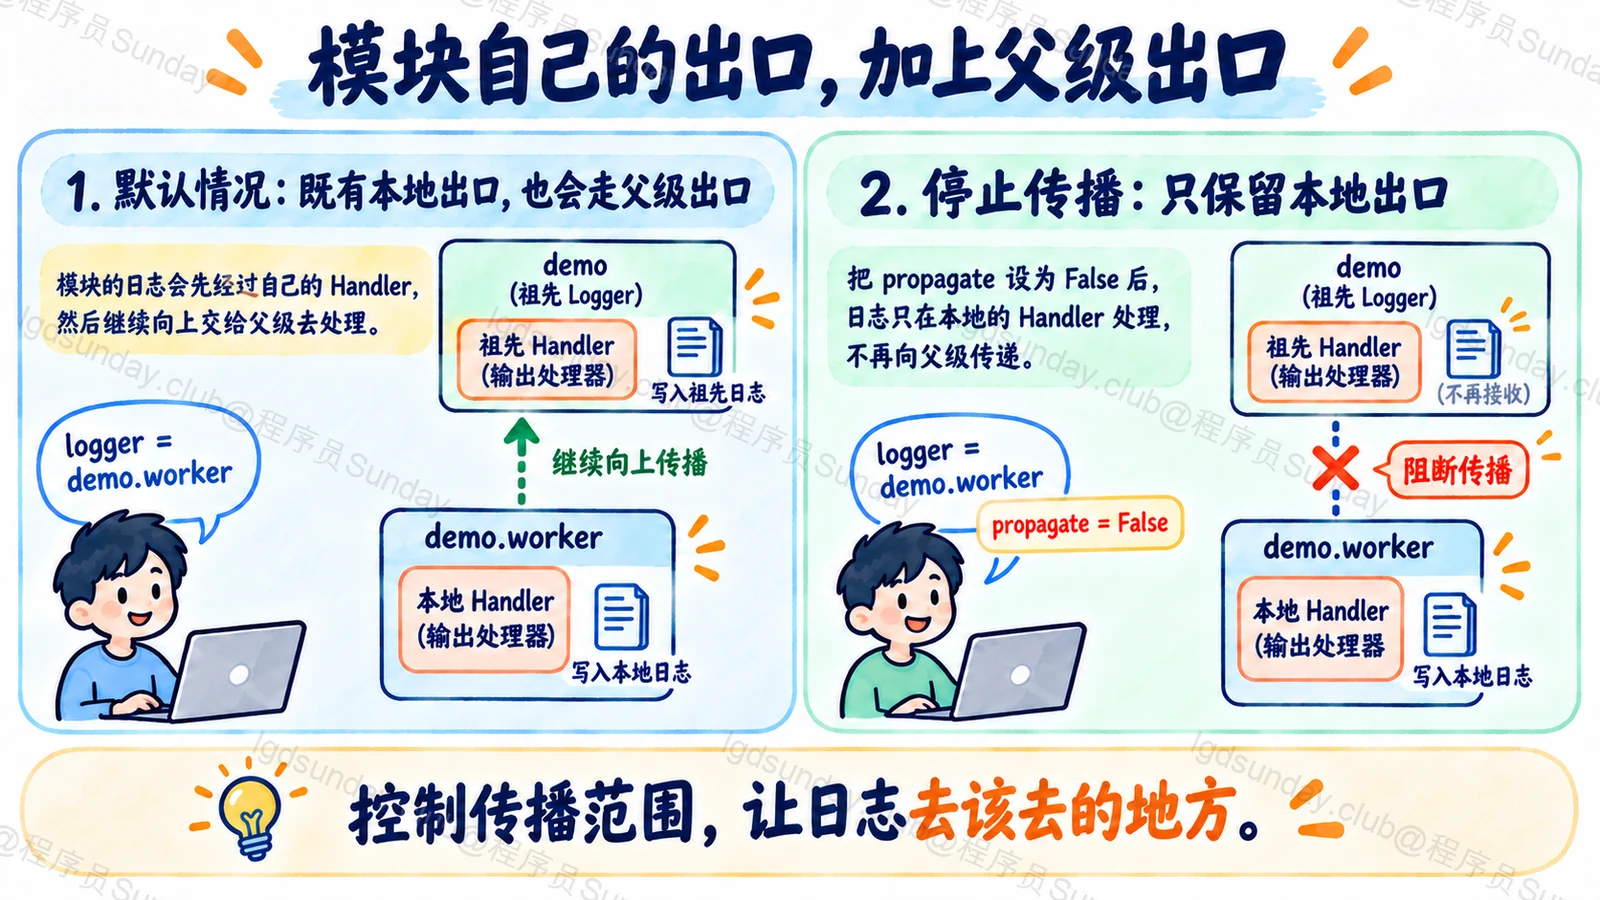
下面建立一个独立层级,避免修改示例运行环境的 root 配置。child 自己有出口,parent 也有出口;传播打开时会出现两行。
Python
import logging
from io import StringIO

output = StringIO()
parent = logging.getLogger("interview_demo")
child = logging.getLogger("interview_demo.worker")
parent.handlers.clear()
child.handlers.clear()
parent.setLevel(logging.INFO)
child.setLevel(logging.INFO)
parent.propagate = False
child.propagate = True

for logger in (parent, child):
    logger.addHandler(logging.StreamHandler(output))

child.info("任务完成")
print(output.getvalue().splitlines())  # ['任务完成', '任务完成']
child.propagate = False
output.seek(0)
output.truncate(0)
child.info("任务完成")
print(output.getvalue().splitlines())  # ['任务完成']
独立输出时停止传播是一种选择,不代表所有项目都应该关闭。集中 root 输出时,业务 Logger 不配自己的 Handler,保留传播就很自然。
父 Logger 级别,不是传播记录的第二次入口
child 是否建立记录,看自己的有效级别。记录往上交时,祖先 Handler 的级别和过滤规则会影响实际输出,但不会完整重做祖先 Logger 的入口过滤。
所以 child 已生成 INFO 记录,即使 parent 的 Logger 设置了更高级别,低门槛的 parent Handler 仍可能输出它。想控制具体出口,要给 Handler 明确级别。
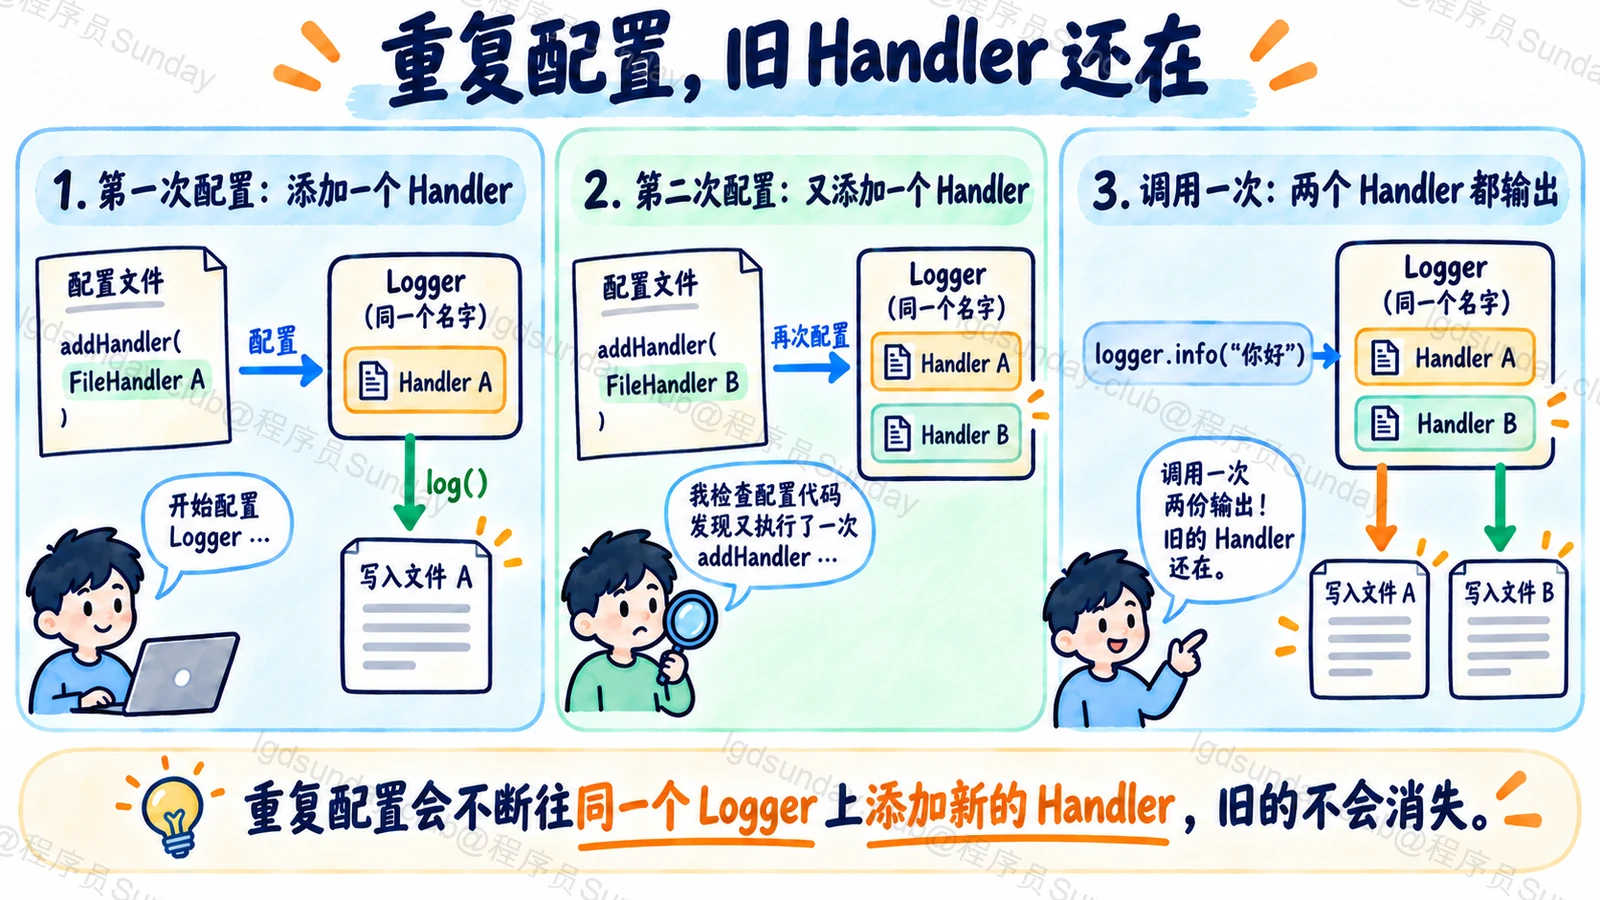
还有另一种重复,初始化函数每调用一次就 addHandler。getLogger 通常返回同名 Logger,因此多次配置不意味着每次都是新空对象,旧 Handler 会留着。
把配置职责放到应用入口
业务文件可以使用 getLogger(name),让名字对应模块层级。应用在启动时集中决定输出位置、级别和格式,避免模块导入时各自重复装 Handler。
TypeScript(显式两个出口对照)
type Sink = (message: string) => void;
const lines: string[] = [];
const terminal: Sink = message => { lines.push(message); };
const archive: Sink = message => { lines.push(message); };
function log(message: string): void {
  for (const sink of [terminal, archive]) sink(message);
}
log("任务完成");
console.log(lines); // 同一消息被两个出口接收
这是出口关系对照,不是 Python Logger 层级 API。Node 日志库各有配置合同,不能拿这段函数声称实现了级别、传播或线程安全。
排查时列出实际 Logger 名称、Handler 数量和 propagate,再测试一次调用出现几条输出。最后检查重载、测试重复启动和工作进程各自配置是否符合预期,不只在首次启动时看一眼。
依据:Python 3.11 logging Logger.propagate、logging HOWTO、logging Cookbook。
面试官继续追问
关闭 propagate 就能彻底解决所有重复吗?
不能。同一 Logger 自己有重复 Handler 时仍会重复,进程或业务层也可能真的调用多次。
hasHandlers 能用来判断本 Logger 是否已配置吗?
它还可能查看祖先可用 Handler,不能直接等同 logger.handlers 非空。要明确检查本地还是整个传播路径。
库为什么常用 NullHandler?
库避免擅自决定应用输出配置,让应用选择实际出口。具体用法按 logging 官方库作者建议处理。
面试速记卡
- Logger 接收记录,Handler 决定实际输出出口。
- 重复行不一定代表业务执行了两次。
- 子级 Handler 加祖先 Handler,可能重复展示同一记录。
- 传播记录不重做祖先 Logger 的入口级别过滤。
- 应用集中配置,模块获取自己的命名 Logger。
公司面试真题
这道题暂未收录可核验的公司真题来源。你可以先阅读本文解析,或浏览已收录的公司面试真题。
浏览公司面试真题 →