
Python 的 dataclass 是什么?和普通类、namedtuple 有什么区别?
下面是模拟面试对话,用来讲解本题,不是真实面经。
🧑💻 面试官:dataclass 是做什么的?
🙋♂️ 我:它能自动生成数据类的一些常用方法。
🧑💻 面试官:只加了类型注解,输入字符串就一定会被拒绝吗?
🙋♂️ 我:不会,注解本身不做运行时校验。
🧑💻 面试官:那 frozen=True 和 namedtuple 都不能随意赋值,里面放列表又会怎样?
数据类帮我们生成重复代码,但生成方法、检查输入和冻结整个对象结构,是三种不同需求。
面试速答(60 秒版)
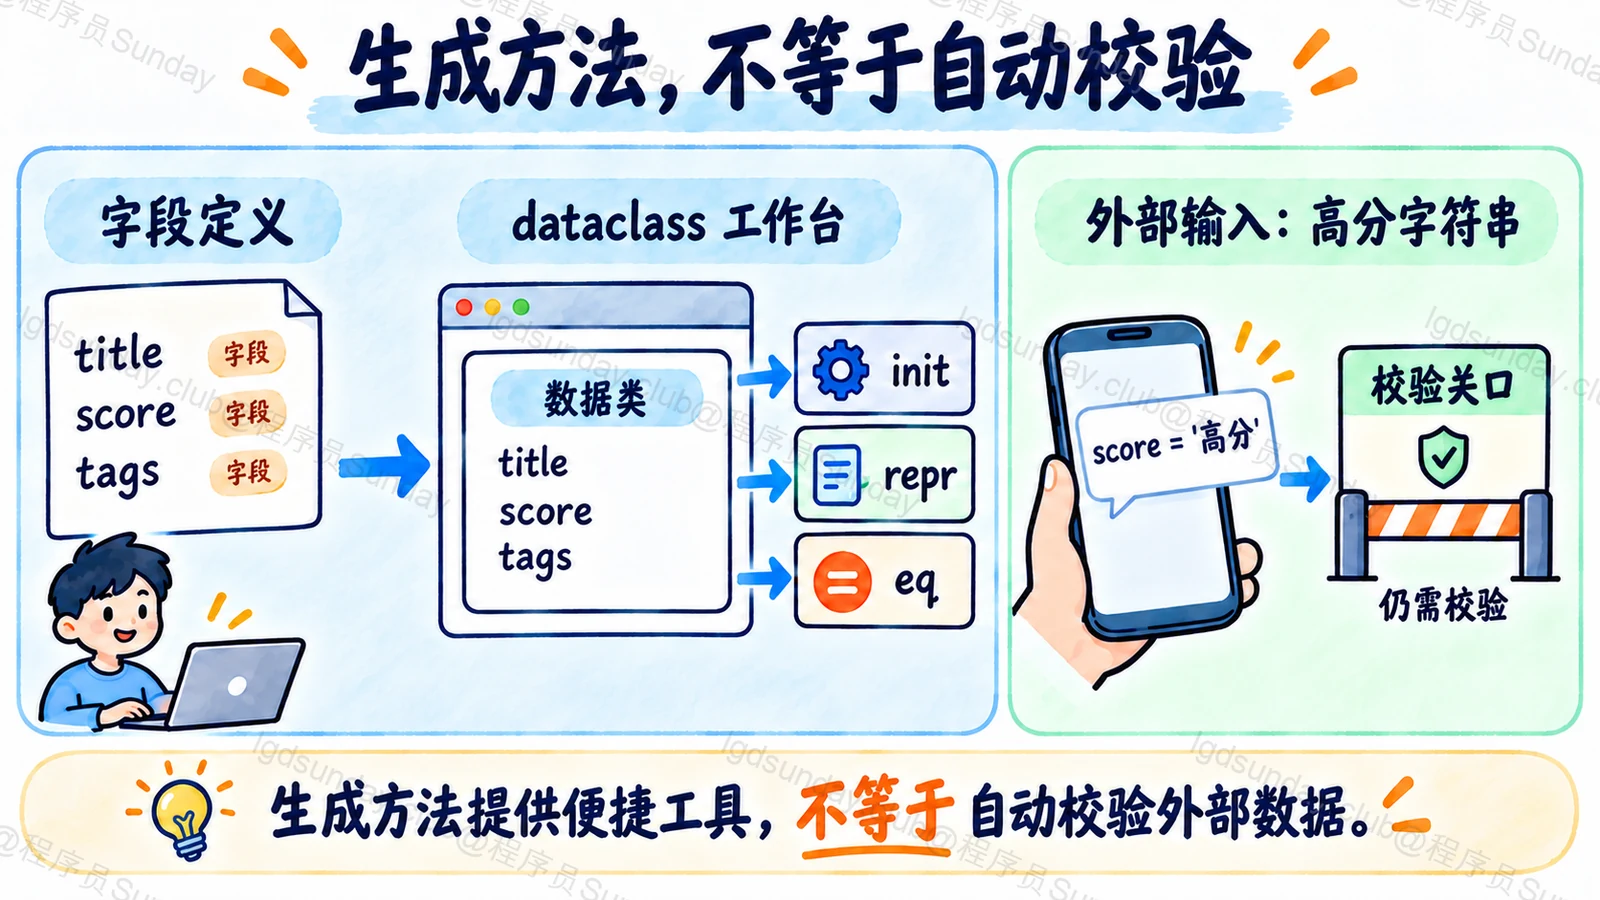
dataclass 适合以字段为主的数据对象。它根据字段生成 init、repr 和比较等方法,减少普通类里重复写字段赋值的工作,也允许我们补自己的业务方法。
字段注解参与数据类生成,但不会自动把所有输入转换或校验成指定类型。需要接口校验时,要另外使用实际校验代码或相应模型库。
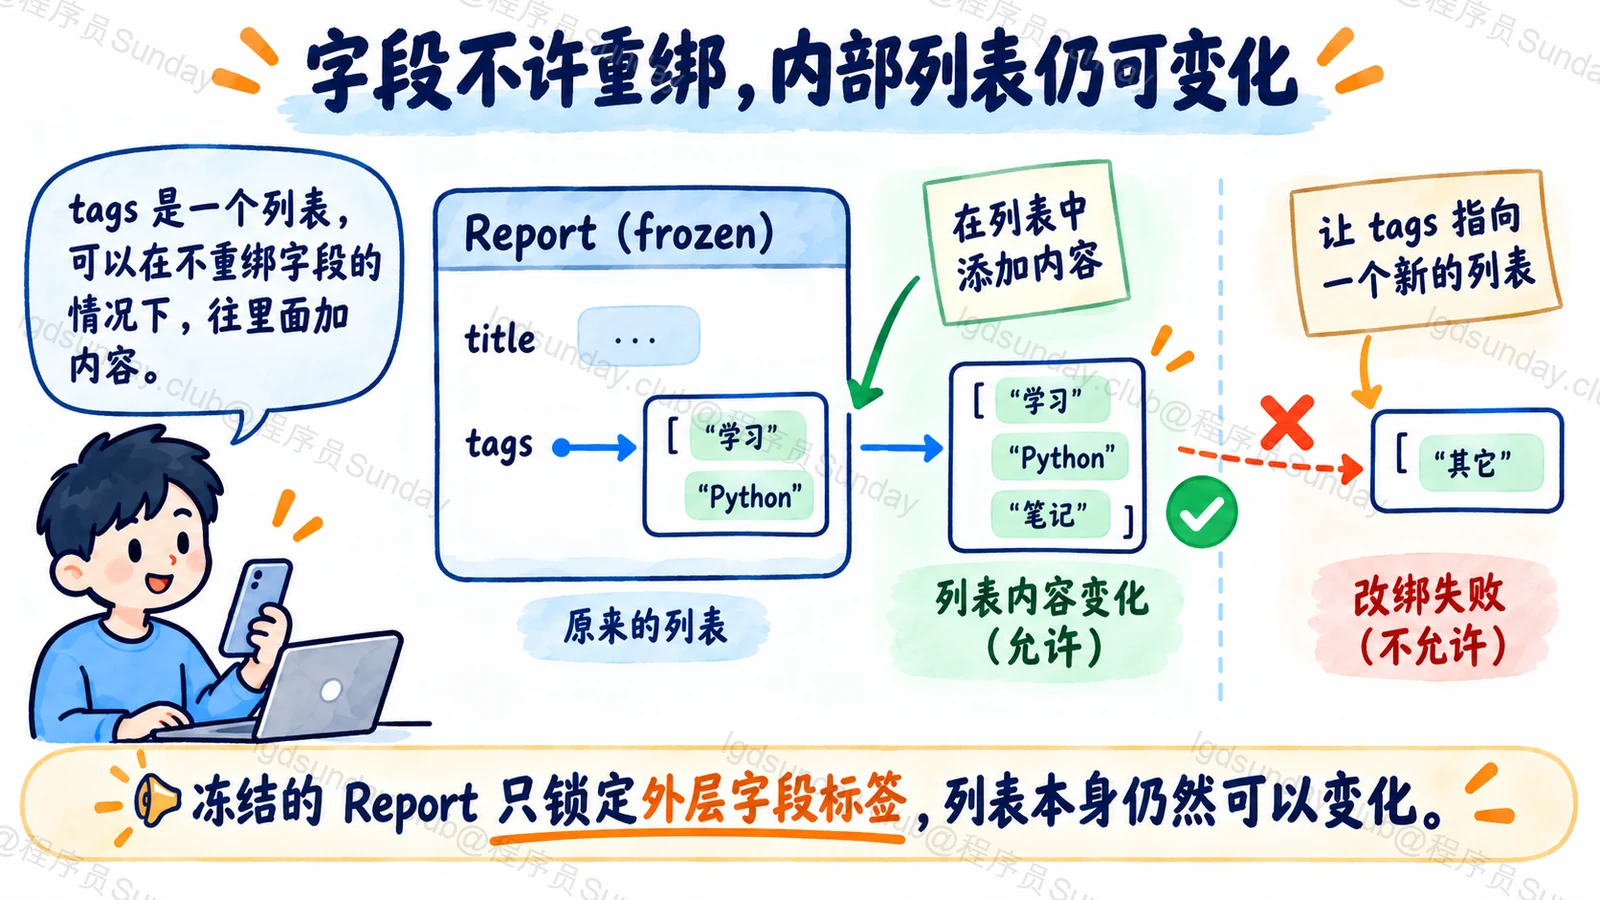
普通 dataclass 通常允许修改字段,frozen=True 会限制常规字段赋值,但不是深度不可变。字段里有列表,列表自己的内容仍然可以变化。
namedtuple 是带字段名的元组,也支持按位置使用,成员位置创建后不能替换。只需要轻量、固定记录时可以考虑它;需要方法、默认值、继承安排和更明确的类行为时,dataclass 往往更容易扩展。
知识点详解:dataclass 生成哪些代码,哪些责任仍由我们负责
先从重复的字段赋值开始
假设接口内部要传递一份报告,包含标题、分数和标签。普通类可以把这几个值在 init 里逐一保存,再手写调试表示和比较逻辑。
dataclass 会根据标记为字段的注解生成这些常见方法。它仍然是一个类,既能定义自己的方法,也能调整哪些字段参与初始化、表示和比较。
因此它的价值是减少数据对象的样板代码,不能推导为“装饰以后就是完整接口模型”。请求解析、权限判断和数据库映射仍是不同的工作。
列表默认值应该每实例创建
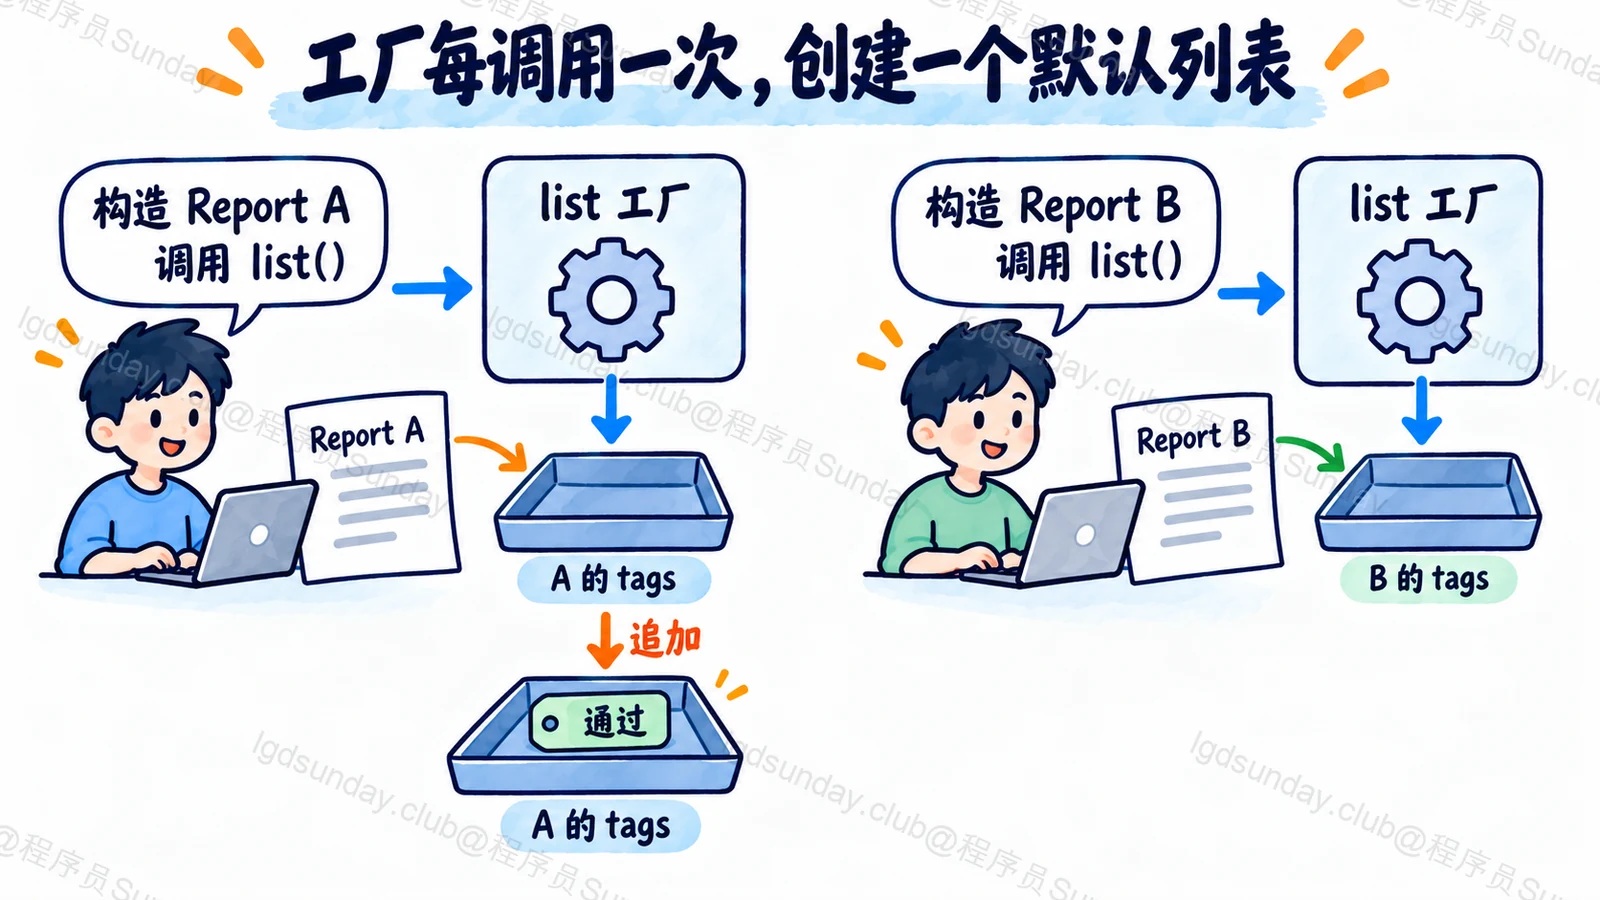
tags 是每份报告自己的内容,所以用 default_factory=list。创建两个实例时分别调用工厂,避免意外共用同一个默认列表。
Python
from dataclasses import dataclass, field
from collections import namedtuple

@dataclass
class Report:
    title: str
    score: int
    tags: list[str] = field(default_factory=list)

a, b = Report("A", 90), Report("B", 80)
a.tags.append("通过")
print(a.tags, b.tags)       # ['通过'] []

Point = namedtuple("Point", ["x", "y"])
point = Point(1, 2)
print(point.x, point[0])    # 1 1
默认生成的 eq 会比较相应字段,并要求比较对象具有相同的类身份。namedtuple 保留元组式的比较和位置语义,不能当作相同的比较合同。
TypeScript(显式数据类对照)
class Report {
  constructor(
    public title: string,
    public score: number,
    public tags: string[] = []
  ) {}
}
const a = new Report("A", 90);
const b = new Report("B", 80);
a.tags.push("通过");
console.log(a.tags, b.tags);
TS 这个类没有自动生成 Python 数据类的值比较规则,JS 的对象相等默认也不是逐字段比较。这里仅对照字段定义和每实例初始化。
类型注解和 frozen 都有自己的边界
Report(“A”, “高分”) 在这个简单定义里仍能构造成功,因为 dataclass 不会自动执行完整的类型校验。希望 score 非负,可以在 post_init 中明确检查;希望外部 JSON 经过解析和错误报告,则需要专门的入口模型设计。
frozen=True 通常禁止通过常规属性赋值修改字段。但字段引用的内部列表仍能 append,这和元组内放列表一样,要看限制在哪一层。它也不是用于抵抗恶意代码的安全沙箱。
可哈希能力还取决于配置和实际字段。不要为了把一个可变对象塞进集合,就随手启用 unsafe_hash。对象内容改变而哈希语义不稳定,会带来更难发现的问题。
普通类、数据类和命名元组怎么选?
字段很多、对象主要承担记录职责时,dataclass 通常让定义更清楚。行为和不变量复杂时,普通类也可以把构造过程与状态修改控制得更明确;数据类并不排斥方法,但不必为套装饰器牺牲表达。
namedtuple 在需要字段名,又确实希望保持元组的位置、解包与不可替换成员语义时合适。字段持续增加,调用方还大量按位置读取,就要注意兼容性。
验证时可以检查默认列表是否独立、相同字段如何比较、错误类型输入会不会被拒绝,以及 frozen 下哪层仍可修改。这样选的是数据合同,不能只看哪个代码行数最少。
依据:Python 3.11 dataclasses、collections.namedtuple、PEP 557 数据类设计。
面试官继续追问
asdict 是不是零成本查看字段?
它会递归处理数据类、字典、列表和元组,其他对象会深拷贝。大对象转换要关注复制和序列化需求,不能当成免费视图。
frozen 数据类必然可哈希吗?
生成规则取决于 eq、frozen 等配置,实际字段也要可哈希。包含列表的字段可能让 hash 调用失败。
dataclass 能直接代替 Pydantic 吗?
它们默认职责不同。标准库数据类生成对象方法,Pydantic 还提供实际解析、校验和错误信息,不能只按字段长得像就互换。
面试速记卡
- dataclass 根据字段生成初始化、表示和比较等方法。
- 注解不会自动完成运行时类型校验。
- default_factory 为每实例提供独立默认对象。
- frozen 限制常规赋值,不是深度冻结。
- namedtuple 保留带名字的元组语义。
公司面试真题
这道题暂未收录可核验的公司真题来源。你可以先阅读本文解析,或浏览已收录的公司面试真题。
浏览公司面试真题 →