
Python 的 lru_cache 和 cached_property 有什么区别?缓存为什么会占住内存?
下面是模拟面试对话,用来讲解本题,不是真实面经。
🧑💻 面试官:lru_cache 和 cached_property 都能缓存,它们有什么区别?
🙋♂️ 我:一个缓存函数结果,一个缓存对象的属性。
🧑💻 面试官:给实例方法加 lru_cache,缓存里会不会留着 self?
🙋♂️ 我:会,self 也是参数的一部分。
🧑💻 面试官:对象删了为什么可能还没释放?输入数据变了,缓存又会不会自动更新?
缓存放在哪里、按什么找、什么时候清掉,决定了这两个 API 的使用边界。少算一次只是结果,生命周期才是工程里更需要交代的部分。
面试速答(60 秒版)
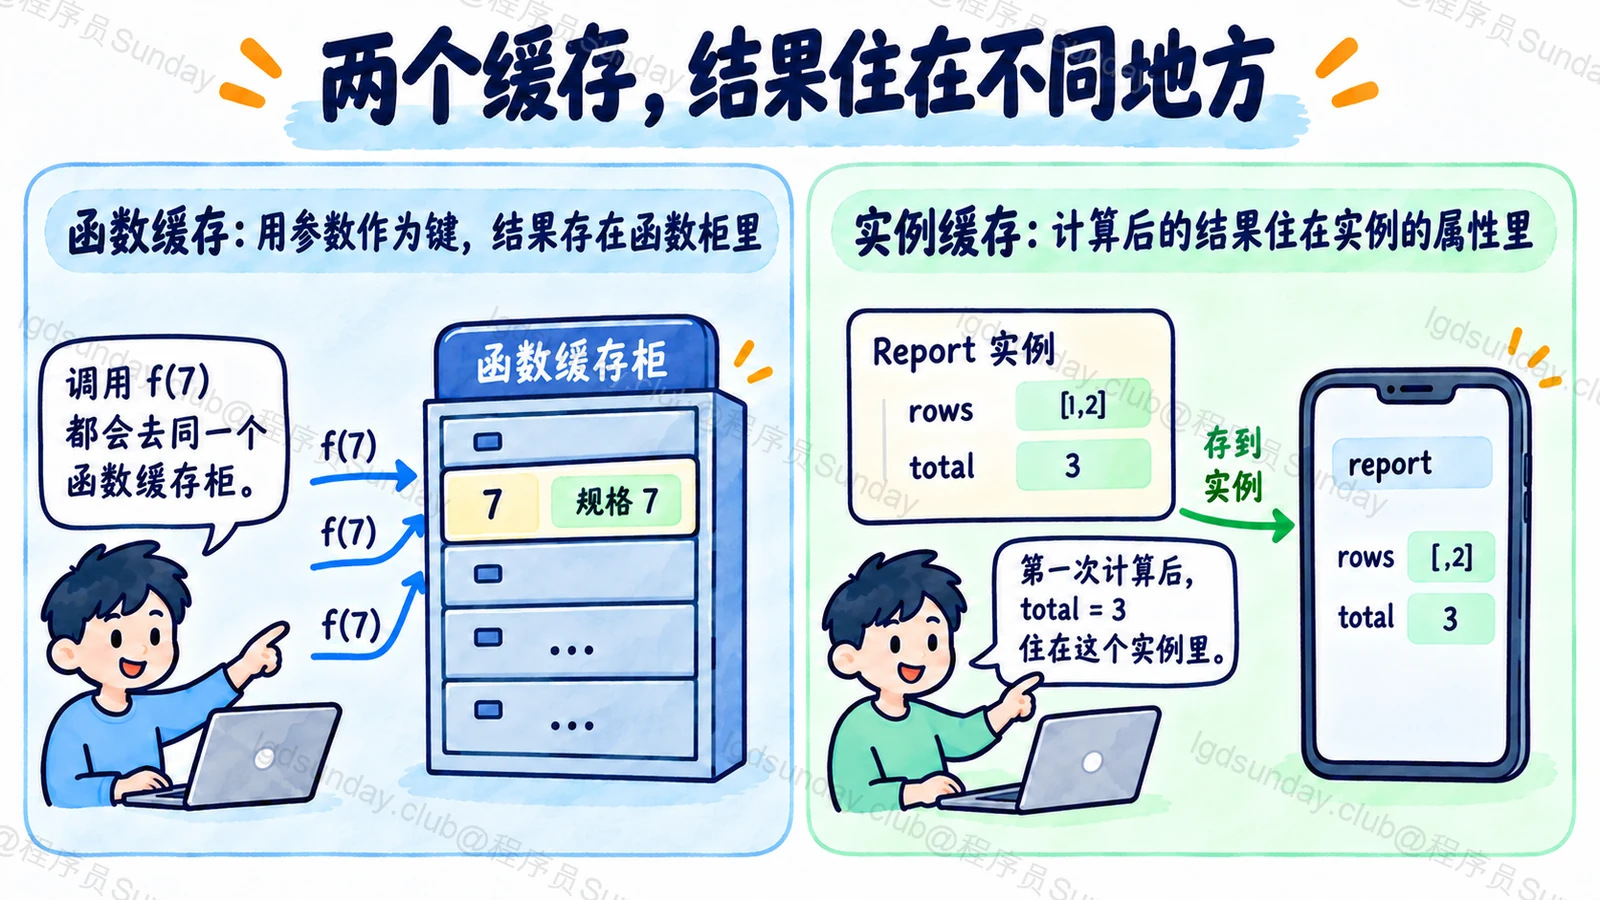
lru_cache 按函数调用参数缓存返回值,最多保存 maxsize 条近期记录。参数需要可哈希,缓存会保留参数和返回值的引用;缓存实例方法时,self 也在键里。
cached_property 则把某个实例的计算结果写到这个实例的同名属性中。之后读取通常直接拿已有值,删除这个属性后才能重新计算。它需要实例有可写的 dict。
两者都不会因为底层数据改变,就自动知道结果过期。用之前要先确定失效规则,而且不要直接缓存一次性协程、生成器或应该每次返回独立可变对象的函数。
并发也要另看。lru_cache 的缓存结构保持一致,不等于同一个键在并发首次请求时只计算一次。cached_property 的并发细节还存在版本差异,不能把它当作业务锁。
知识点详解:函数参数缓存和实例属性缓存,寿命不同
lru_cache 把调用参数作为查找依据
假设一个函数根据规格编号构建只读说明,同一编号在当前进程中会反复查询。如果数据在这段时间内稳定,缓存函数返回值能减少重复计算。
下面第二次读取 7 会命中;cache_info 可以观察命中与未命中,cache_clear 可以明确清掉记录。
Python
from functools import lru_cache, cached_property

@lru_cache(maxsize=32)
def describe(code: int) -> str:
    print("计算规格", code)
    return f"规格-{code}"

print(describe(7))
print(describe(7))
print(describe.cache_info().hits)  # 1

class Report:
    def __init__(self, rows):
        self.rows = tuple(rows)

    @cached_property
    def total(self):
        return sum(self.rows)

report = Report([1, 2])
print(report.total)       # 3
report.rows = (10, 20)
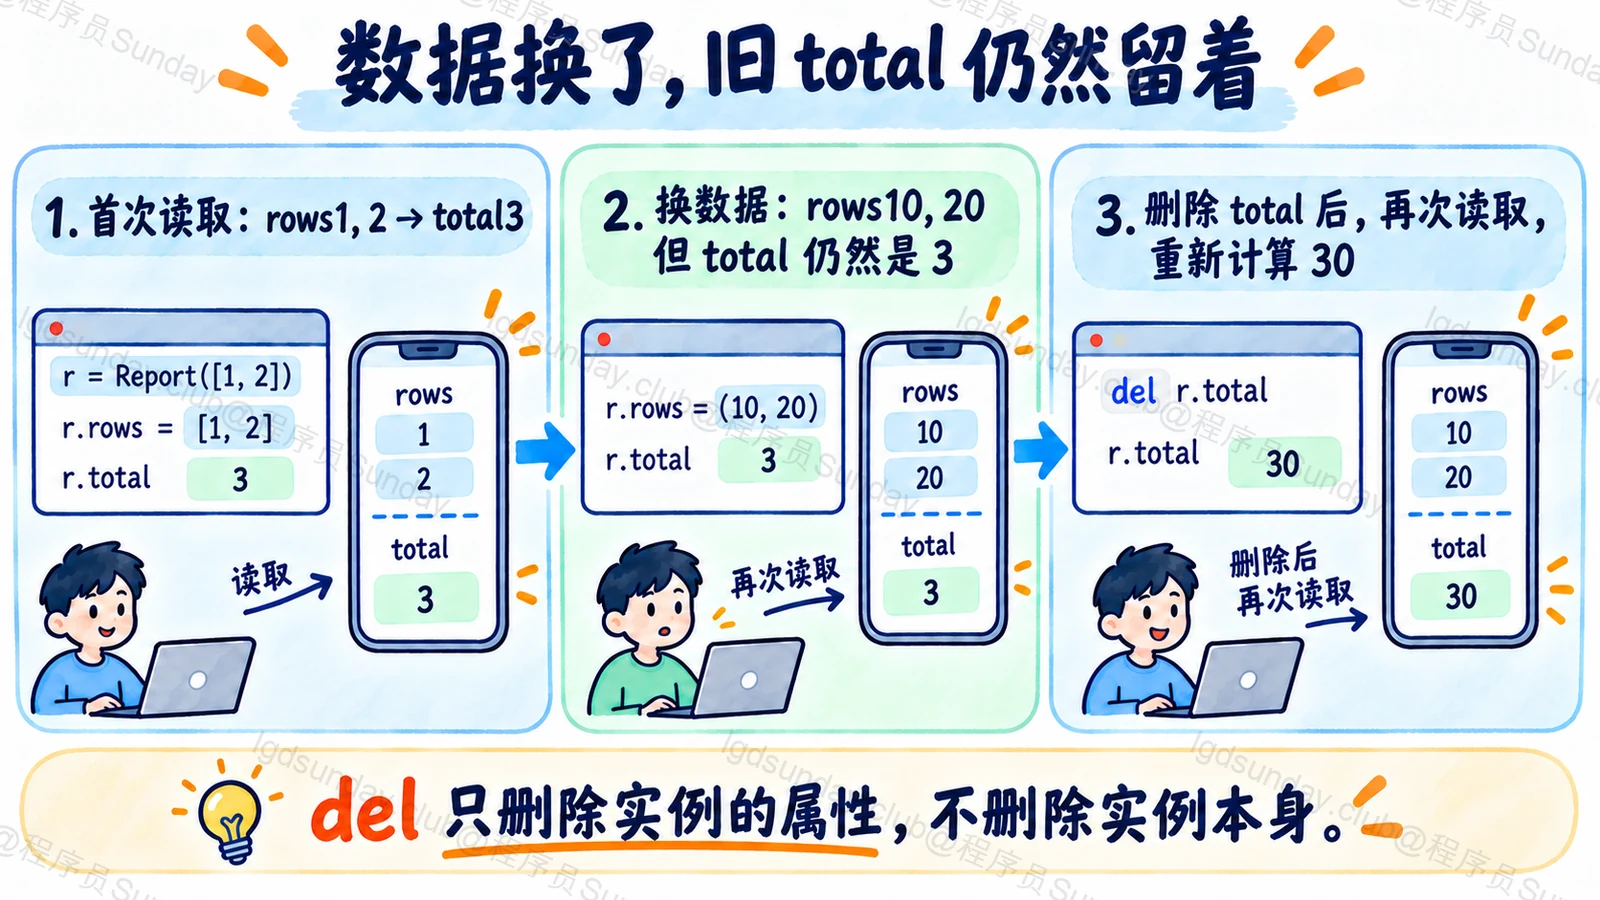
print(report.total)       # 仍然是 3
del report.total
print(report.total)       # 重新计算,30
注意,缓存不是按“看起来一样的请求”随意合并。参数形式、关键字顺序等可能形成不同记录,typed 的含义也不能理解成对所有嵌套成员做递归类型判定。让调用方式保持一致,比猜缓存一定会合并更可靠。
cached_property 的结果住在实例里
Report 第一次读取 total 时,计算结果写入它自己的属性。修改 rows 不会自动删掉 total,因此刚才仍读到旧的 3。删除 total 之后,再次读取才重新计算。
这很适合创建后基本不变、需要昂贵派生值的对象。不适合每次输入更新都期待自动重算,却没有任何失效处理的对象。
只定义 slots 而没有 dict 的实例,一般不能直接使用这个 cached_property 机制。想省实例字典,又要保存派生值,可以显式设计一个槽和失效规则,而不是机械叠加装饰器。
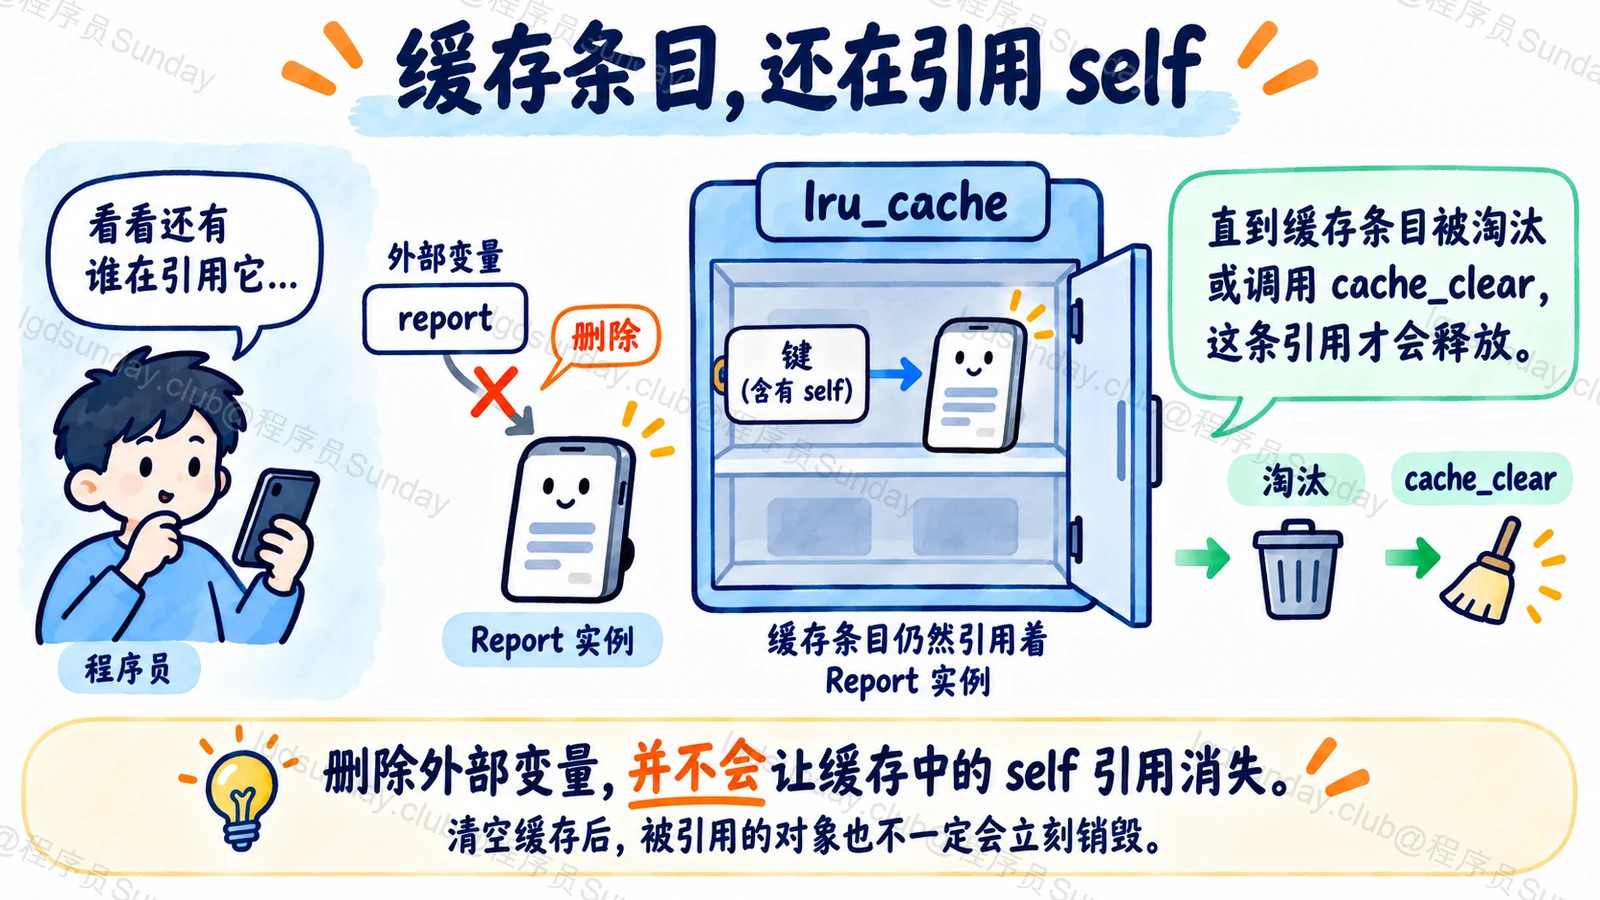
缓存为什么会延长对象寿命?
lru_cache 会持有键和结果的引用。实例方法的 self 是键的一部分,所以即使外部删掉那个实例的变量,缓存条目仍可能让它继续存活,直到条目被淘汰或清空。
maxsize=None 又没有其他失效策略时,参数不断变化就可能积累大量记录。限制条数也不等于限制总字节数,一条结果可能比其他结果大得多。
TypeScript(显式键与清理对照)
const cache = new Map<number, string>();
function describe(code: number): string {
  if (!cache.has(code)) cache.set(code, `规格-${code}`);
  return cache.get(code)!;
}
describe(7);
cache.clear(); // 清理时机由应用自己规定
Map 本身没有自动 LRU 淘汰,也不是 cached_property 的对应 API。这个小例子只是把“持有哪些对象、由谁清掉”写得更明显,真正使用时仍要补容量与失效设计。
并发首次计算,可能重复发生
lru_cache 的线程安全主要保证缓存数据结构不会被并发更新弄坏。同一键的首次计算还没结束,另一个线程又进来,底层函数可能执行两次。对带副作用的操作,这个差别尤其重要。
cached_property 在 Python 3.12 去掉了此前未公开的锁安排。本文的代码使用 CPython 3.11 验证数值行为,不依赖某版本恰好只执行一次。确实要求每实例初始化一次时,要在业务代码里安排同步和幂等性。
验证缓存时可以检查命中率、更新输入后的结果、cache_clear 或 del 后是否重算,以及大量不同参数后的内存变化。只有命中率高,还不足以证明缓存没有返回过期结果。
依据:Python 3.11 functools、Python 3.12 cached_property 版本变更。
面试官继续追问
能给 async 函数直接加 lru_cache 吗?
它缓存的会是协程对象,而不是等待后的普通结果。协程通常不能反复等待,所以不能用这种方式替代异步结果缓存。
cached_property 自动知道依赖字段变了吗?
不会。对象需要在更新字段时删除旧缓存,或改用明确重算的属性设计。
maxsize=32 等于内存固定吗?
它限制条目数量,不限制每条参数和结果占多少字节;方法键还可能持有实例。
面试速记卡
- lru_cache 按参数找结果,参数需要可哈希。
- 缓存条目持有参数和结果,方法键包含 self。
- cached_property 将结果写到实例同名属性。
- 底层数据更新,不会自动触发失效。
- 缓存一致性不等于并发首次只算一次。
公司面试真题
这道题暂未收录可核验的公司真题来源。你可以先阅读本文解析,或浏览已收录的公司面试真题。
浏览公司面试真题 →