
Python 的 import 是怎么工作的?循环导入为什么会报 partially initialized module?
下面是模拟面试对话,用来讲解本题,不是真实面经。
🧑💻 面试官:Python 的 import 是把文件复制进来吗?
🙋♂️ 我:它会加载模块,后续导入可以复用缓存。
🧑💻 面试官:A 导入 B,B 又从 A 导入一个函数,为什么会提示 partially initialized module?
🙋♂️ 我:可能是 A 还没有执行到那个函数的定义。
🧑💻 面试官:那把所有 import 移到函数里就解决设计问题了吗?同一个文件还可能有两份状态吗?
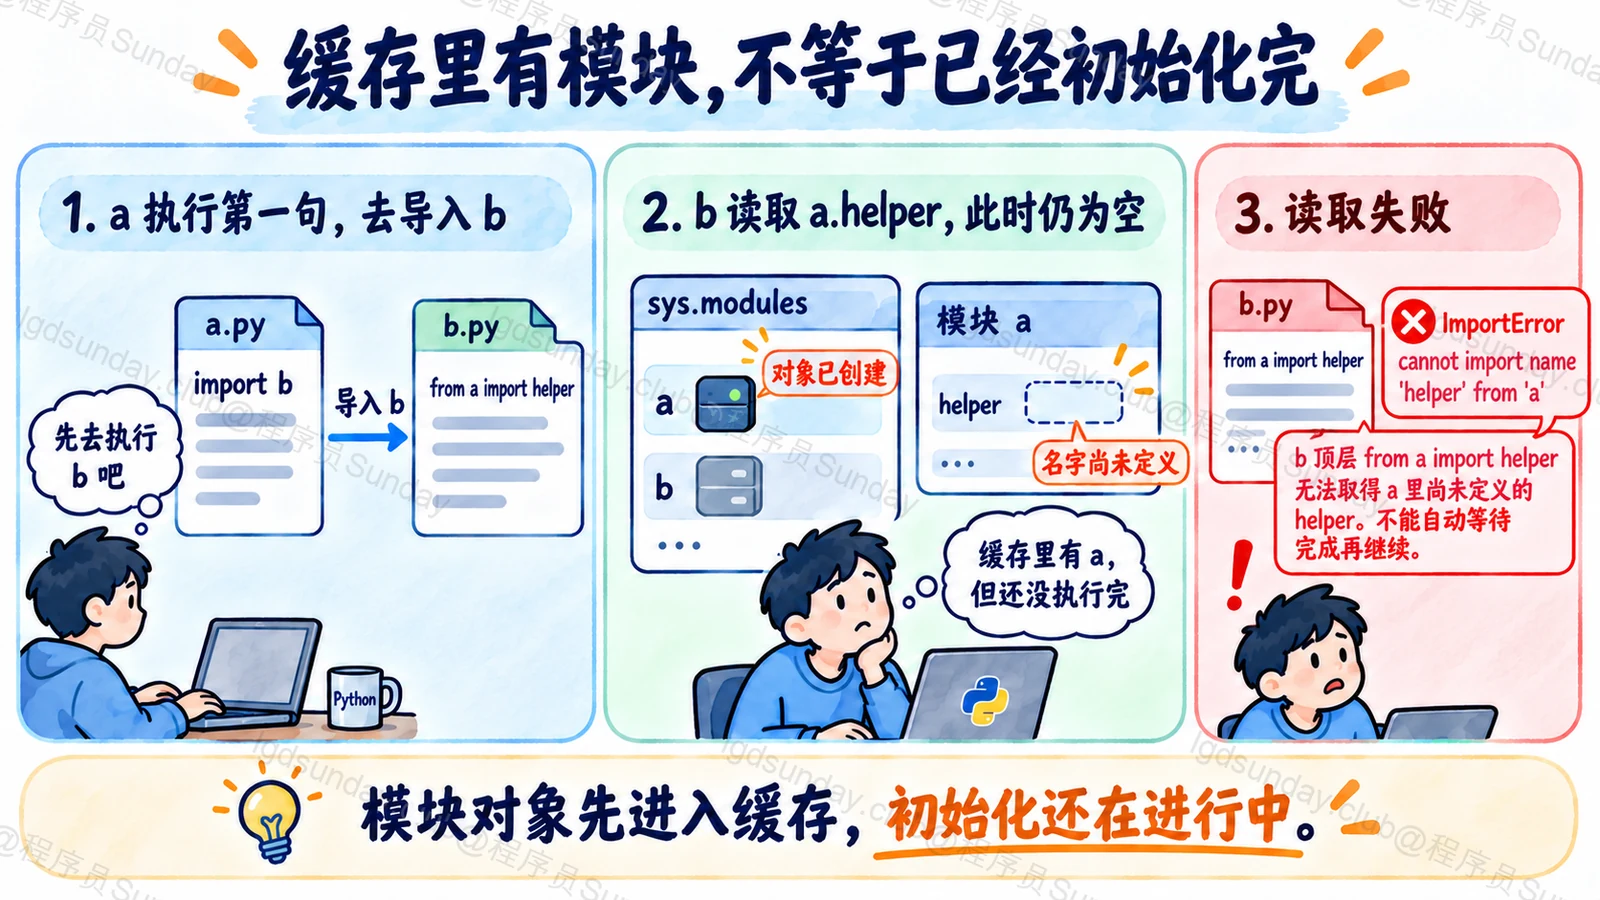
模块进入缓存,不代表它已经执行完毕。循环导入里的报错,往往发生在“已经有模块对象,但目标名字还没创建”的时候。
面试速答(60 秒版)
import 会按模块名寻找模块。通常先检查 sys.modules,已经加载的模块可以复用;没有时,再寻找加载器,创建模块并执行模块代码。
模块在顶层代码执行完成前就会进入 sys.modules。这样才能处理递归导入,但也意味着其他模块可能拿到一份尚未初始化完的模块。
如果 A 正在导入 B,B 又立即读取 A 后面才定义的名字,就容易遇到 partially initialized module 的报错。
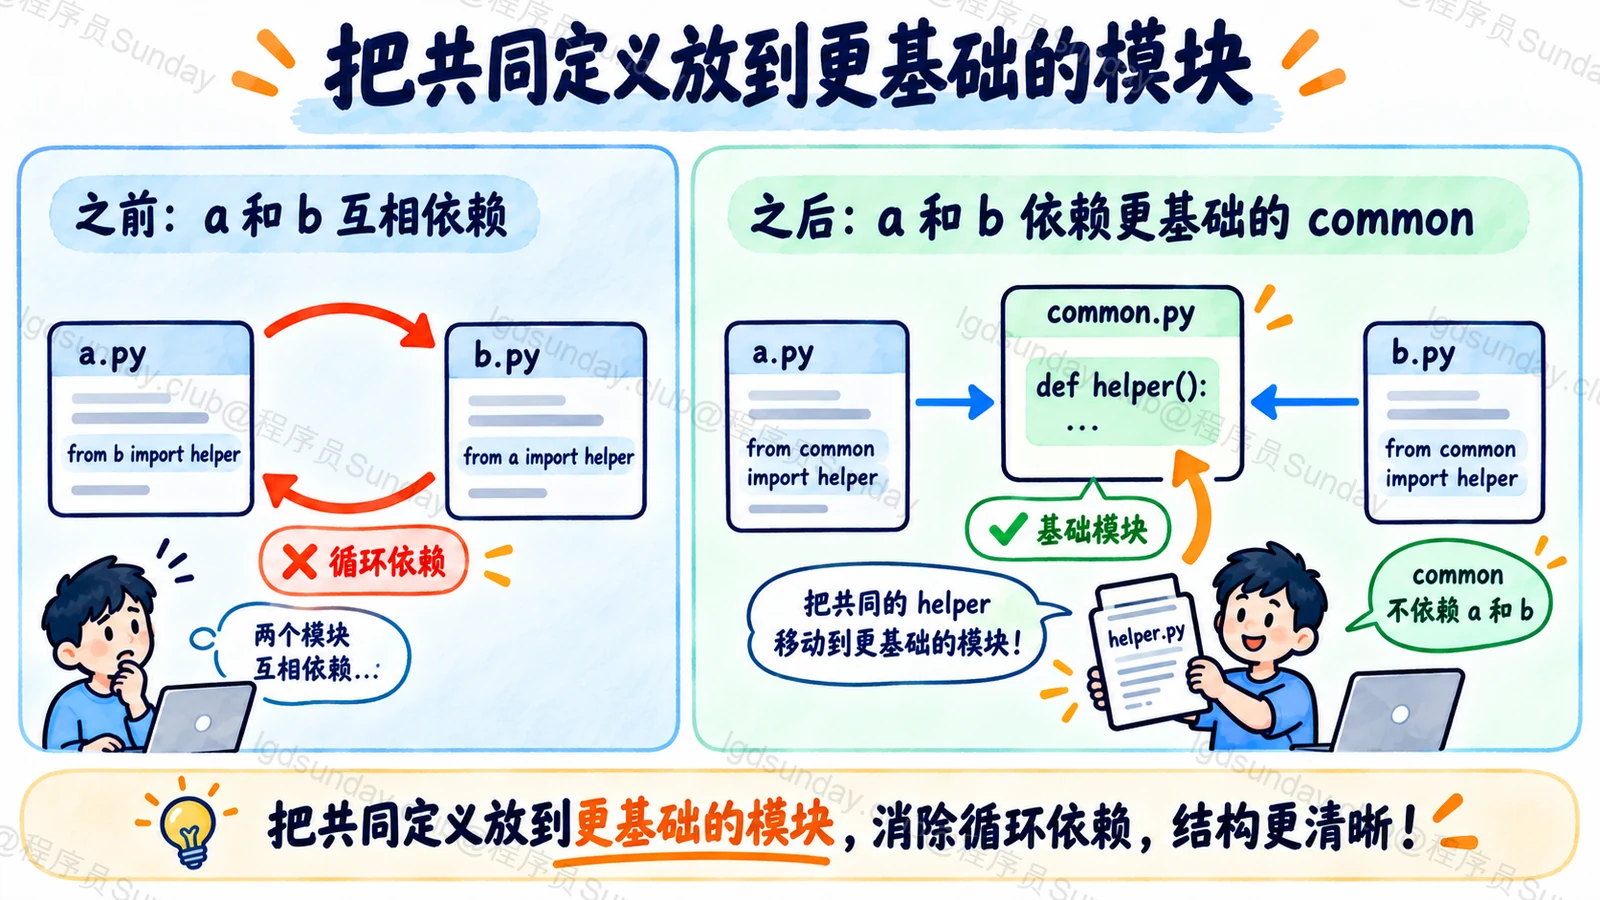
处理时我会先看依赖方向。双方都需要的数据或接口,可以放进更基础的模块;确实只在调用时才需要的依赖,也可以延后导入。延后导入能避开部分初始化时机问题,但不能自动消除职责耦合。
知识点详解:循环导入卡在模块尚未准备好的时刻
导入先找的是模块身份
假设业务代码写 import report。Python 要处理的是 report 这个模块名,再沿着相应查找规则找到它。加载结果会记录在 sys.modules 中,后续按同一名字导入时,通常可以直接取回已有模块。
因此 import 不等于每次都把源码重新运行一遍,也不等于把整个文件内容复制到当前局部变量。import report 给当前命名空间绑定模块对象;from report import render 则把当时取到的 render 对象绑定进来。
如果 report.render 后来被重新赋值,前面 from 导入出来的那个名字不会因此自动重新绑定。需要始终通过模块访问当前属性时,import report 后使用 report.render 更清楚。
A 和 B 互相等待时,具体缺了什么?
下面假设两个同目录文件。在普通模块搜索路径能找到它们的环境下执行 import a,会形成循环。
Python
# a.py
from b import run

def helper():
    return "ready"

# b.py
from a import helper

def run():
    return helper()
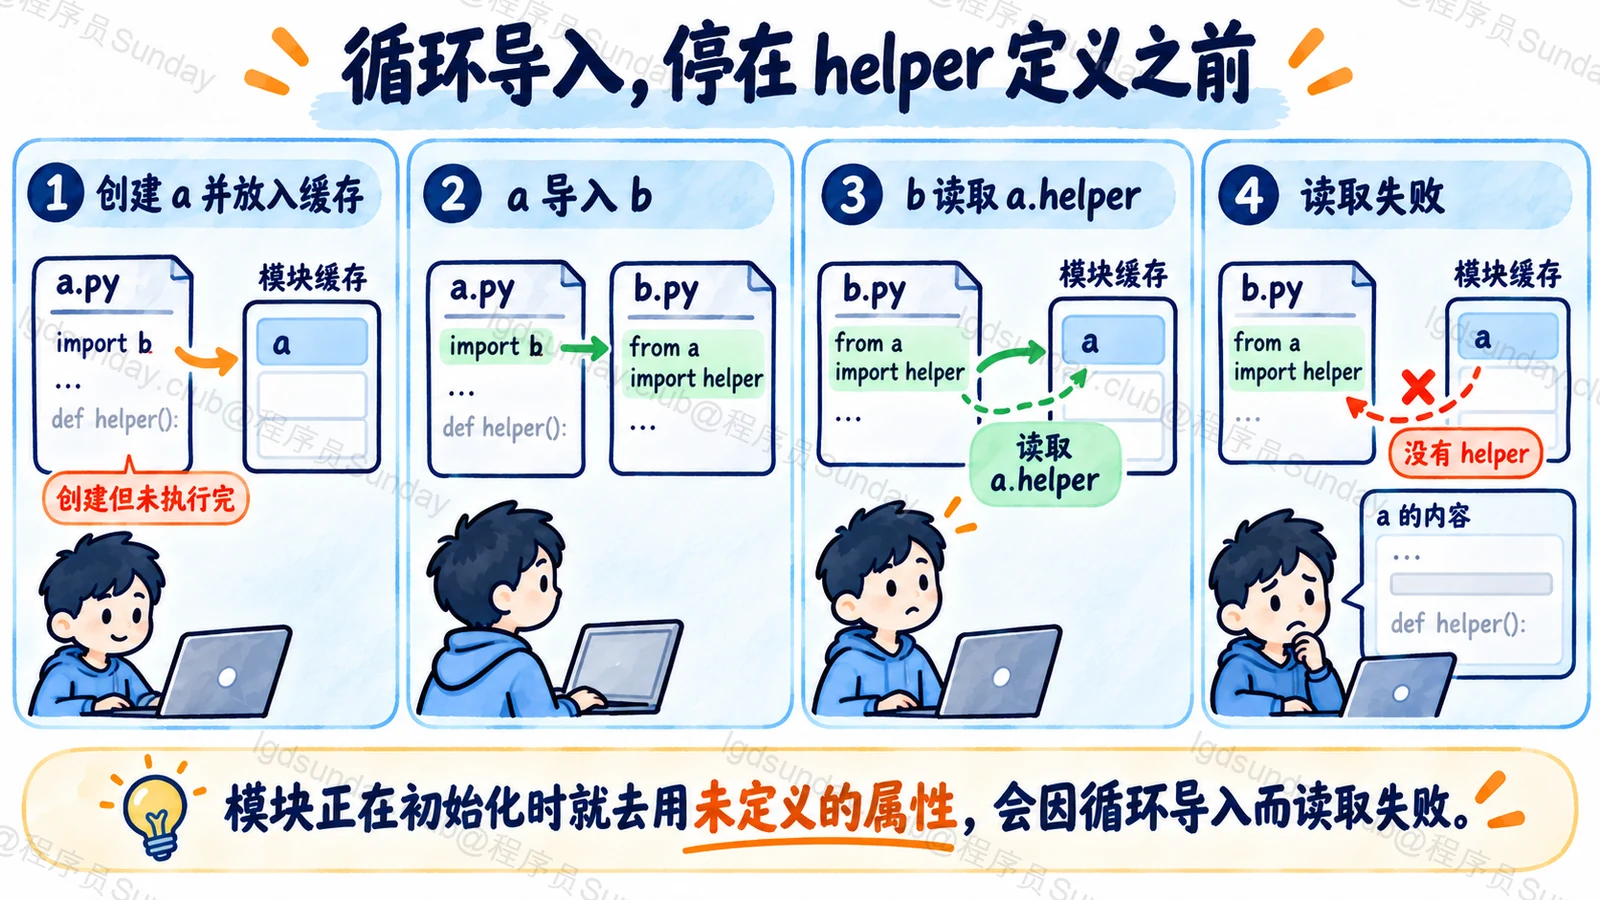
时间顺序很重要。Python 创建 a,并把它放进缓存;a 开始执行,第一句要求导入 b;b 又想从 a 取 helper。但 a 还停在第一句,helper 的定义没有执行,当然取不到。
缓存里存在 a,所以不会简单地重新从头执行 a 来“补齐”。这份模块是部分初始化状态,错误信息正是在提示这个时机问题。具体异常措辞可能随写法和版本不同,不能把某个报错字符串当成唯一识别条件。
把共同依赖移到更低的一层
对这个例子,可以把 helper 放入 common.py,让 a 和 b 都依赖 common,而不是互相要求对方在初始化时提供名字。这样看文件的依赖箭头,就没有 a ↔ b 的闭环了。
也可以让 b 先 import a,等 run 被调用时再访问 a.helper。前提是调用时 a 已经完成初始化。如果 b 的顶层立即调用 run,问题还会回来。
函数内导入也是类似道理,它改变的是发生时间。偶尔用于可选依赖、昂贵初始化或确有需要的局部依赖很合理;一个项目到处延后导入,则应该检查是不是核心模块互相知道太多。
TypeScript(依赖方向对照)
// common.ts
export function helper(): string { return "ready"; }

// b.ts
// import { helper } from "./common";
// export function run(): string { return helper(); }
TS/JS 模块的绑定和初始化规则与 Python 不同,这里只对照“抽出共同依赖”的结构,不把 partially initialized module 的机制照搬过去。
同一文件也可能被加载成不同模块
模块缓存以模块名为键,并不是简单按文件内容去重。例如直接运行某文件时,它的名字可能是 main,其他代码再按包名导入它,就有可能产生另一份模块对象和顶层状态。
所以别靠模块顶层变量实现一个不管运行方式都绝对唯一的单例。入口文件尽量薄,把可以复用的逻辑放到稳定的包模块中,执行入口调用它即可。
排查时可以记录模块的 name、file 和 sys.modules 中的名称,画出顶层导入的实际顺序。删除缓存或手动 reload 不是循环依赖的通用修复;模块已有引用、资源和初始化副作用都可能让结果更复杂。
依据:Python 3.11 导入系统、importlib 模块缓存与加载。
面试官继续追问
import 会在每个请求里重新执行顶层吗?
正常同一进程、同一模块名再次导入通常复用缓存。新进程、显式重载或不同模块身份需要另外判断。
只改成 import a 就一定没事吗?
还要看何时读取 a 的属性。顶层马上读取一个还未建立的属性,仍可能失败。
怎么判断该拆公共模块还是延后导入?
双方共同使用且不依赖上层的定义,适合下沉。只有特定调用才需要的依赖,可以延后;最终还是要让职责和依赖方向合理。
面试速记卡
- import 按模块名加载并缓存模块。
- 进入 sys.modules 时,模块代码可能还没执行完。
- 循环导入常在过早读取尚未创建的名字时失败。
- 共同依赖可以下沉,延后导入只改变时机。
- main 和包名导入可能形成不同模块身份。
公司面试真题
这道题暂未收录可核验的公司真题来源。你可以先阅读本文解析,或浏览已收录的公司面试真题。
浏览公司面试真题 →