
日志、指标和链路追踪有什么区别?Trace ID 怎样串起跨服务请求?
下面是一段教学用的模拟面试。
🧑💻 面试官: 日志、指标和链路追踪有什么区别?
🙋♂️ 我: 都是记录系统运行情况,日志详细,指标能告警,Trace 看调用链。
🧑💻 面试官: 指标显示接口突然变慢,你下一步怎样找到是哪一次请求、哪一段调用?
🙋♂️ 我: 用 Trace 看各段耗时,再找相应日志。
🧑💻 面试官: 日志里没有关联 ID,调用下游时也没传上下文,你能把它们可靠拼起来吗?
三种信号不是各建一个页面就完成了。真正有用的是:从异常趋势走到具体请求,再走到相关事件。
面试速答(60 秒版)
指标把运行情况聚合成时间序列,适合看请求量、错误率、延迟分布和资源趋势,帮助发现异常。
日志记录具体事件与上下文,适合解释发生了什么;Trace 把一次请求的多个操作连起来,用 Span 表达各段工作,帮助定位跨服务路径和耗时。
它们互相补充:先用指标发现范围,再用 Trace 缩小到具体链路,最后结合相关日志分析原因。日志与 Trace 需要可用的关联信息,跨服务还要正确传播上下文。
同时要控制成本与风险:采样可能让部分 Trace 缺失,高基数标签可能增加指标成本,日志不能不加选择地记录敏感内容。没有采到,不等于没有发生。
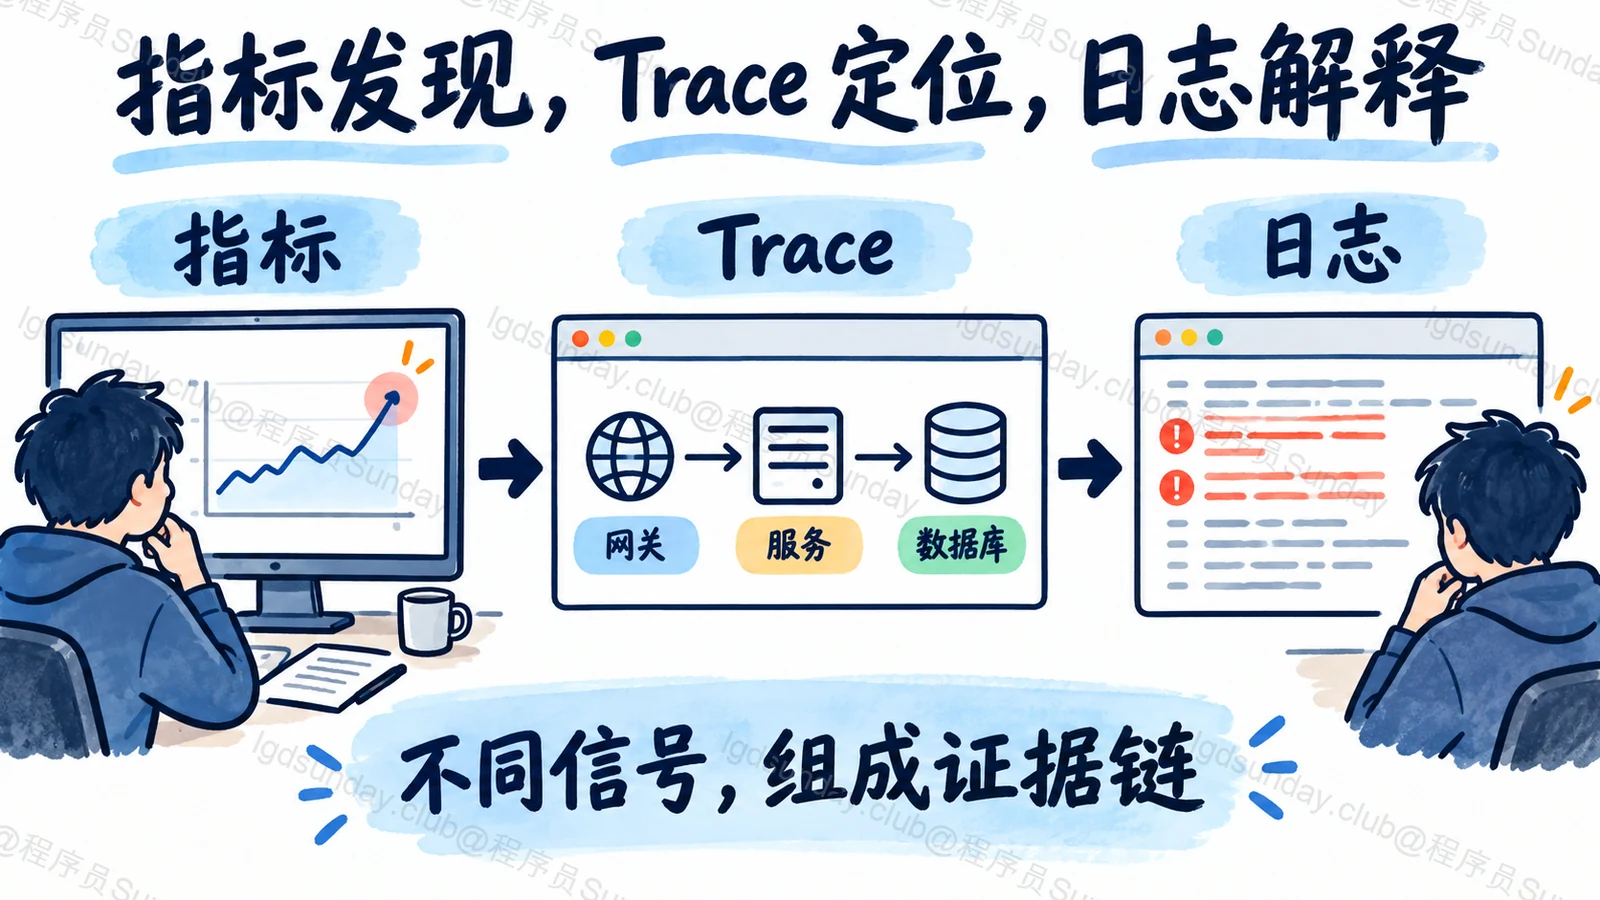
图:指标发现,Trace 定位,日志解释。
知识点详解:同一个慢请求,三种信号分别回答什么?
指标先告诉我们哪里异常了
假设订单接口最近十分钟明显变慢。请求延迟分布、错误率和流量能帮助判断:是所有请求都慢,还是尾部变慢;是访问量突然增加,还是相同流量下处理能力下降。
这里要关注分布,而不只看平均值。一小部分极慢请求可能被平均数掩盖。指标适合描述这类总体变化,但通常不能直接还原某个用户的一次完整操作。
也不能给每个请求都增加唯一 request_id 指标标签,再指望它仍保持聚合成本。标签组合越多,时间序列数量可能越大。
Trace 把一条请求拆成具体工作段
假设一次请求依次经过网关、业务服务和数据库。每段操作可以记录为 Span,放在同一个 Trace 的关系里。
观察时可以看到父子关系、开始结束和相应属性,帮助判断慢在哪里。不过,父 Span 的时间常包含子操作,不能把所有父子耗时简单相加。
多个子调用并行时,也要按重叠时间看,不是把图上每段长度都累加成总延迟。三类信号定义可以结合 OpenTelemetry Signals理解。
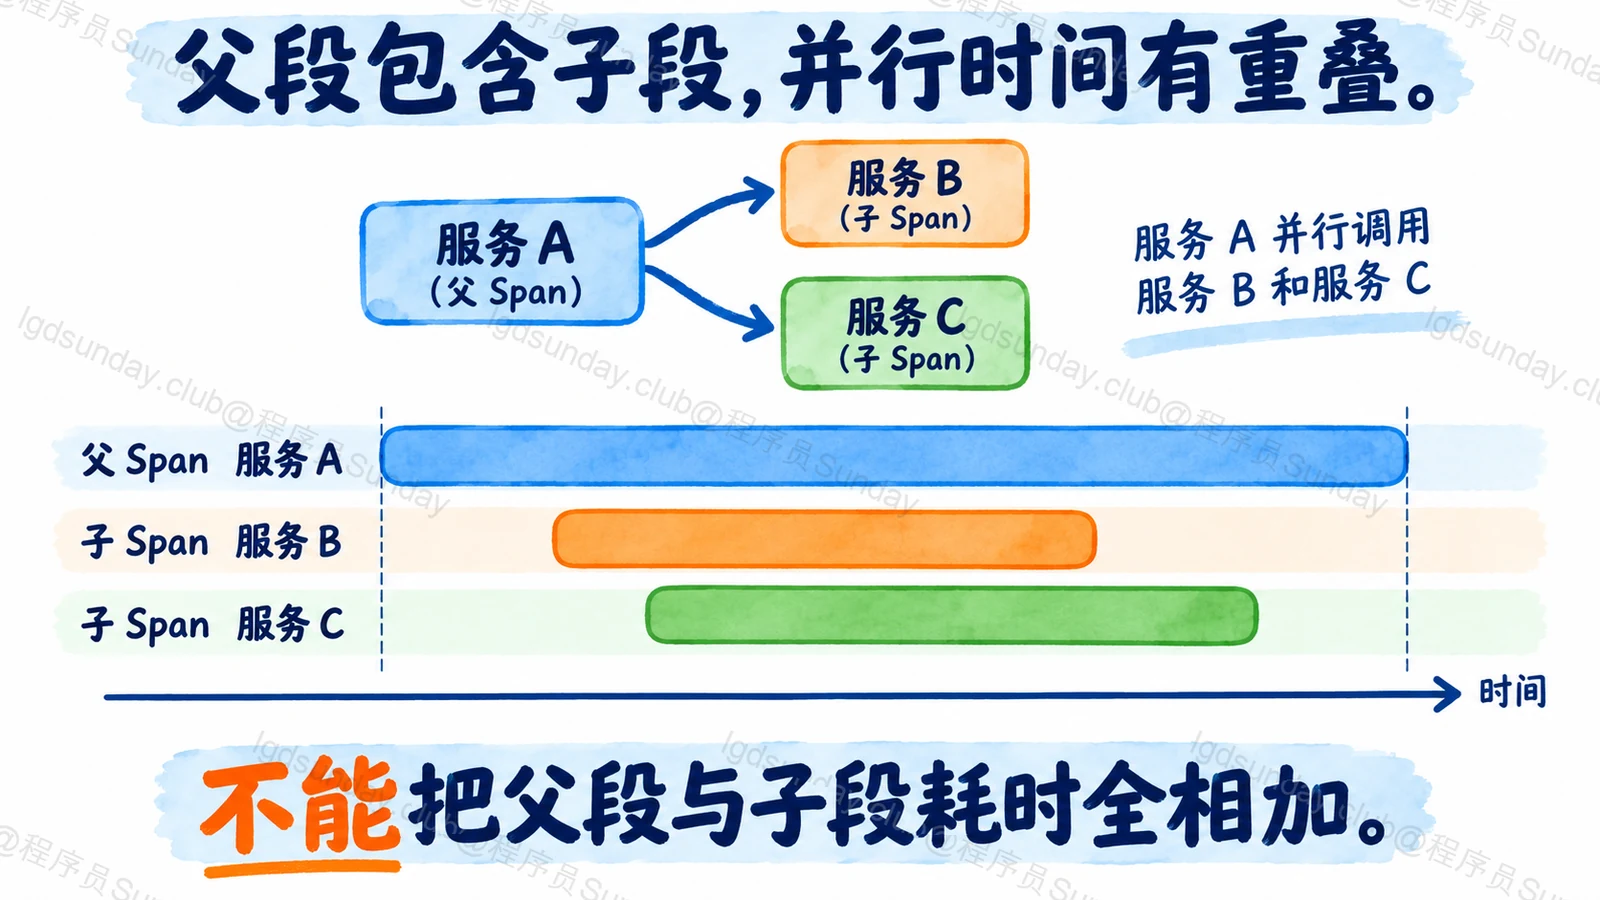
图:父子与并行耗时,不能全相加。
日志补充事件细节,而不是再画一条时间线
Trace 指向某段数据库调用较慢,日志可能进一步说明重试、连接等待、错误类型或某个业务检查结果。
日志应该记录足以解释事件的信息,但不是把全部请求体、令牌和用户资料无差别保存。结构化字段和明确的敏感数据策略,通常比“大字符串里什么都有”更便于查询。
如果记录了对应 trace_id、span_id 等关联信息,就更容易从链路定位到相关事件。时间接近只能帮助缩小范围,不能在高并发下可靠证明两条记录属于同一次请求。
上下文为什么需要跨服务传播?
服务 A 调用服务 B,如果 B 重新开始一个完全独立的 Trace,我们就难以直接看到这条跨服务链路。
传播机制把相应追踪上下文带过去,让下游建立正确的关联。W3C Trace Context规定了相关头的格式与处理要求。
不过追踪头不是用户认证凭证,也不应直接当作可信业务权限。异步任务、消息和线程切换也需要按工具能力正确传递上下文,不能认为 HTTP 配好就覆盖全部执行方式。
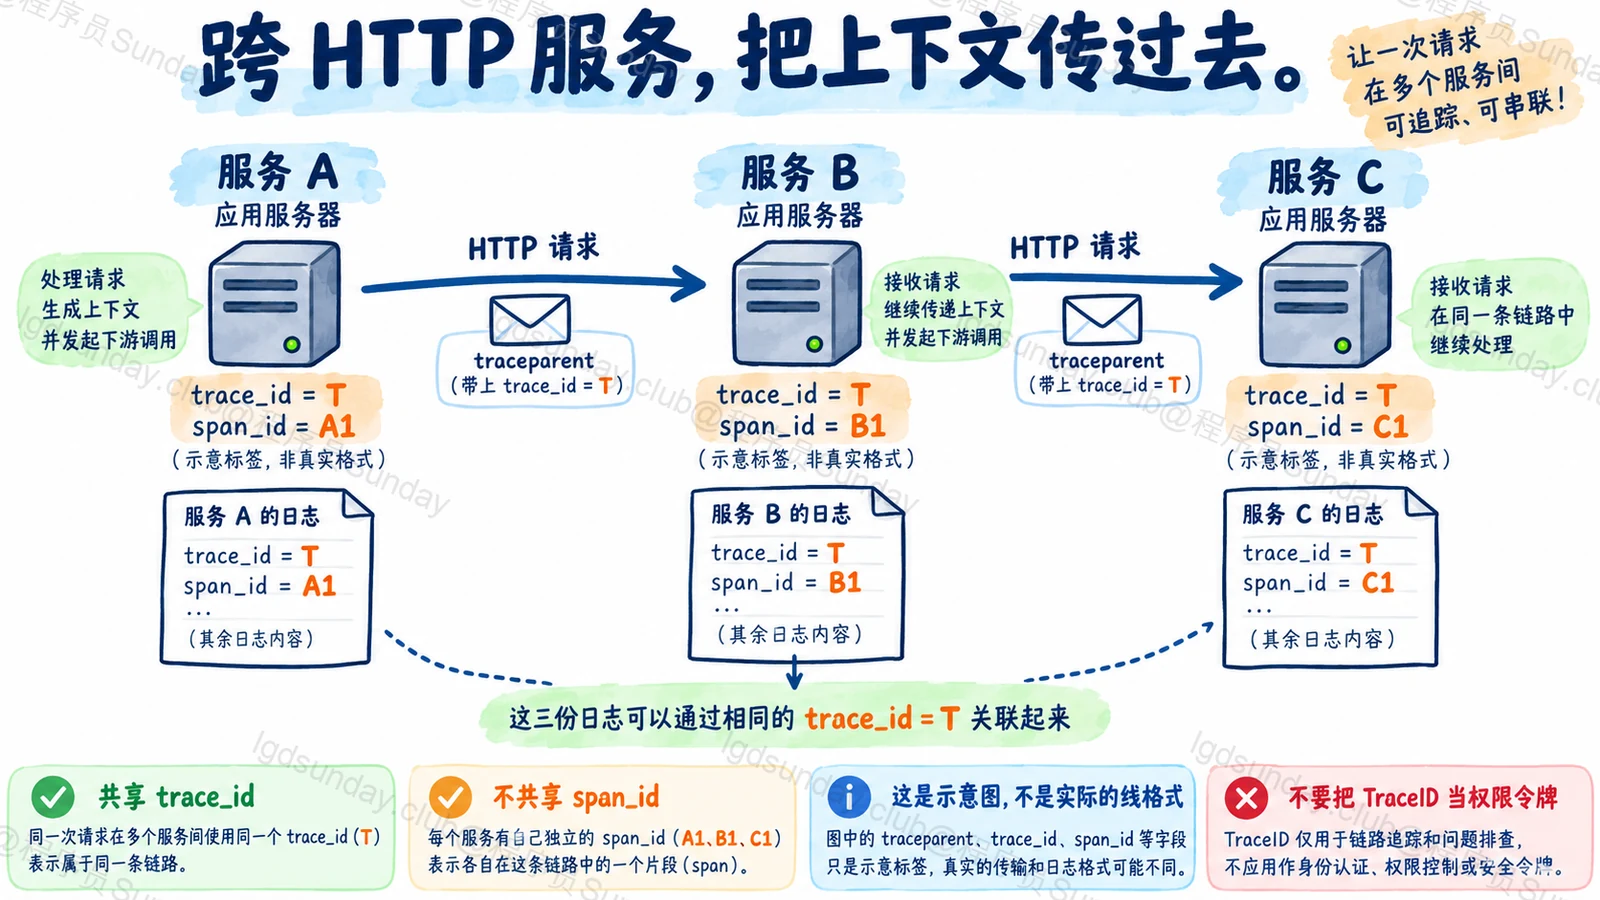
图:跨服务,把上下文传过去。
没有数据,为什么不能直接排除故障?
采样、丢弃、上报失败和保留期都可能让记录缺失。因此,“找不到一条失败 Trace”不能证明请求没失败。
设计时应明确哪些指标持续保留,哪些请求可能采样,错误日志怎样保存,以及观测系统自己如何被监控。工具安装成功,不等于证据链完整。
本文讲观测模型,不提供绑定某个 SDK 版本的伪完整接入代码,也没有虚构一次生产故障。
面试官继续追问
有 Trace,日志就不需要了吗?
不对。Trace 提供操作关系,日志提供具体事件;有些事件也不属于一条请求。应按调查需要分工,不靠一个信号替代全部。
怎么验证关联真的成立?
制造一条已知路径的测试请求,检查跨服务、异步段和日志能否定位到同一上下文,再验证异常与采样路径,而不只看正常首页。
面试速记卡
- 指标:聚合趋势与异常范围。
- Trace:请求关系与各操作段。
- 日志:具体事件与原因线索。
- 关联:传播上下文,记录可用的 Trace/Span 标识。
- 边界:采样缺失、标签基数、敏感内容和观测成本。
公司面试真题
这道题暂未收录可核验的公司真题来源。你可以先阅读本文解析,或浏览已收录的公司面试真题。
浏览公司面试真题 →