
分布式 ID 怎么生成?Snowflake、UUID、号段模式怎么选?
🧑💻 面试官:分布式 ID 用 Snowflake 就行吗?
🙋♂️ 我:时间戳加机器编号加序列号,唯一而且递增。
🧑💻 面试官:两台机器用了同一个编号,或者时钟回拨呢?
🙋♂️ 我:就可能出问题。
🧑💻 面试官:你需要全局严格递增,还是大致有序?ID 能不能作为授权凭证?
唯一、有序、不可猜和可用是不同要求。先定约束,再选 ID。
面试速答(60 秒版)
常见方案有数据库序列或号段、Snowflake 类时间 ID、UUID 等。它们在协调成本、排序特性、长度和故障依赖上不同。
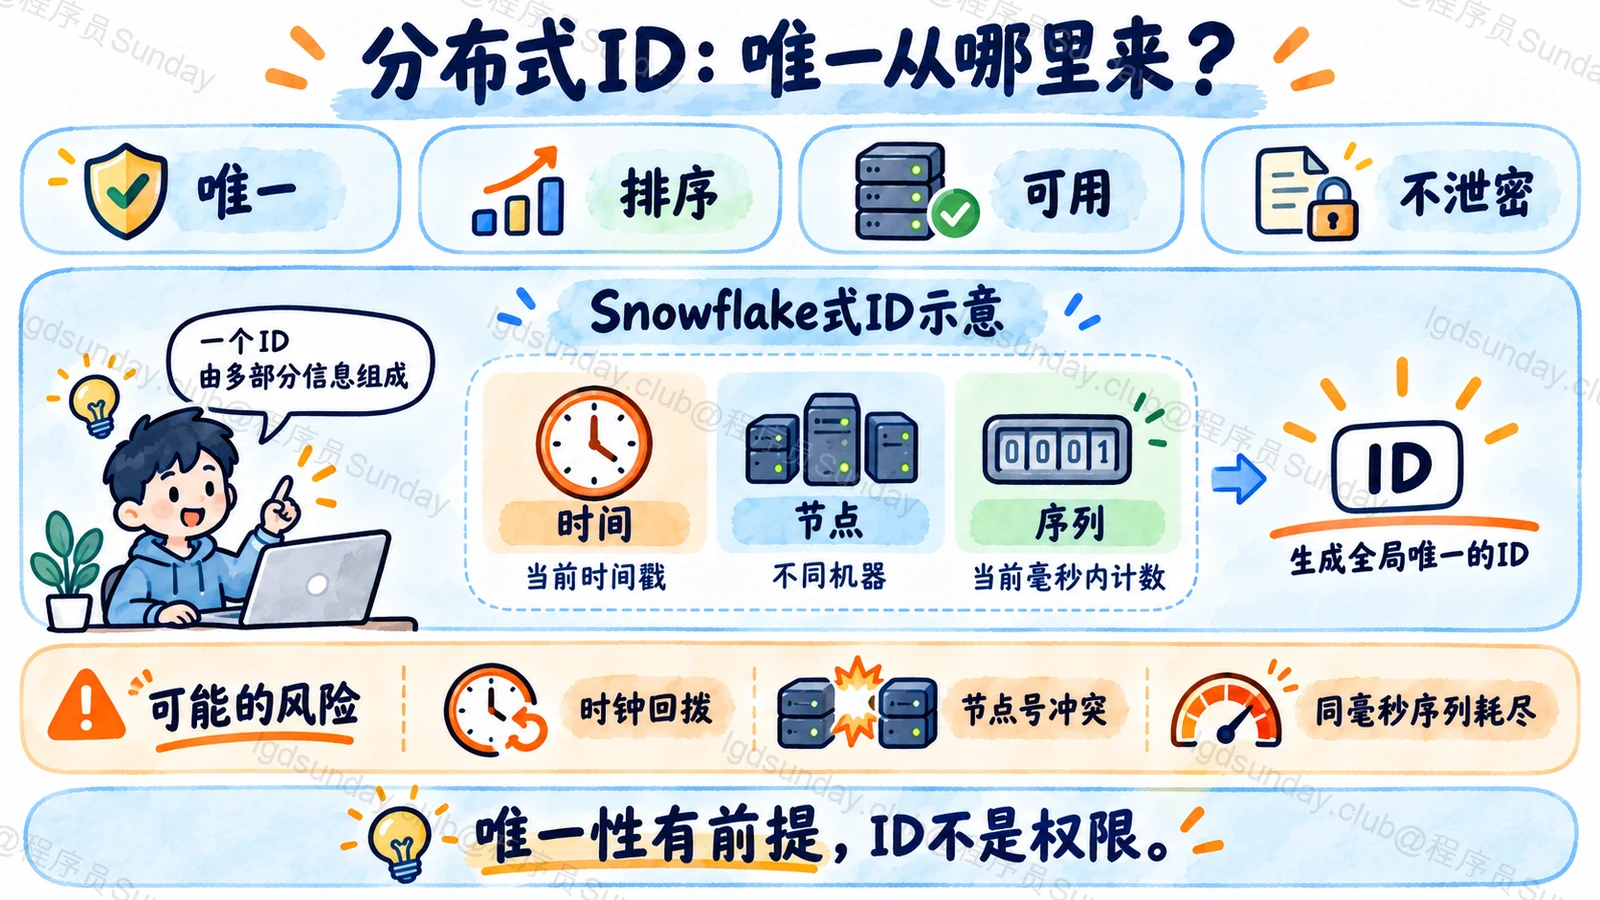
经典 Snowflake 类方案把时间、节点和同时间单位内序列组合起来,依赖节点号不冲突、序列不超限,以及明确的时钟回拨策略;不能默认多节点全局严格按生成先后递增。
UUID v4 主要使用随机位,UUID v7 使用时间相关布局,有利于时间排序,但也不是天然全局严格序列。唯一性仍需按生成方法和概率、协调约束讨论。
选型要看写入索引、离线生成、节点管理、回拨处理和表示精度。TS 中大整数避免 Number 丢精度,公共接口可用字符串;不可把 ID 难猜当成授权。
知识点详解:你要的不只是一个很大的数字
先把要求拆成能测试的四件事
假设记录要跨机房生成。唯一要求不撞号;有序可能只要求索引写入局部集中,不一定要求所有机器严格按真实时间排队。
公共短码如果不希望被枚举,还涉及可预测性;生成服务不能用时,又涉及是否能独立产生新 ID。四件事并不自动一起满足。
数据库自增容易理解,但迁移、分片和生成服务依赖要处理。号段可以减少每个 ID 都去协调的次数,却需要可靠分配和避免段重复使用。
Snowflake 的字段不是装饰,它们承担不撞号条件
经典 Twitter 实现使用时间、worker 标识和序列组合。具体位数、起点和节点布局属于该实现,不是所有所谓 Snowflake 库都相同。
两个生成器在同一时间使用相同节点号和相同序列,字段组合就可能相同。序列耗尽后也不能直接从零继续,必须等待、切换策略或拒绝。
时钟回拨时,等待、报错或采用额外逻辑时钟都有代价。重启后也要考虑旧状态与节点号复用,而不是只在运行中加一个判断。
UUID 也要说版本,时间有序不等于严格序号
v4 和 v7 的生成结构不同。v4 的随机性适合独立生成,v7 把时间相关部分放到适合排序的位置,其余部分和生成策略仍有约束。
即使 ID 含时间,不同机器时钟也可能偏移,同一时间范围内的顺序还依赖具体生成方法。因此不能从“能排序”推导出真实事件全局先后。
如果业务必须严格顺序,就应设计序列分配或日志位置等机制,明确吞吐和可用性成本,不把它藏进 ID 名字。
长度、精度与授权常在接口处出问题
假设后端返回 64 位整数,前端用 JS Number 接收,超过安全整数范围就可能丢精度。用字符串传输,或在明确支持的内部场景使用 BigInt,并定义 JSON 转换。
ID 只负责标识资源。用户能猜出某个 ID,也必须经过授权;猜不出也不能免掉授权。
验证需要并发生成、节点重复配置、时钟回拨、序列耗尽与重启,不只生成一千个然后看没重复。
本题机制参考:UUID RFC 9562、Twitter Snowflake 原实现、Snowflake 归档说明。
面试官继续追问
Snowflake 保证 ID 连续无缺口吗?
不保证。字段编码、等待和进程生命周期都可能带来间隔,它不是业务连续编号。
UUID 绝对不重复吗?
不能这样承诺。不同版本依赖不同条件;随机版本按概率讨论,并可结合存储唯一约束。
ID 时间字段能代替业务发生时间吗?
不能默认。生成时机和业务事件时机可能不同,应保存明确的业务时间。
面试速记卡
- 先定要求:唯一、排序、预测性、可用性。
- Snowflake:节点号、序列与时钟策略共同保障。
- 时间 ID:不默认多节点全局严格递增。
- UUID:说清 v4/v7 与具体生成条件。
- 接口:大整数精度与资源授权独立处理。
公司面试真题
真题根据求职者公开面经整理,题意经过概括,非逐字原话或公司官方题库;本文为 Sunday 的独立解析。
美团 · Java后端 · 实习
UUID、号段和雪花算法怎样生成分布式 ID?(题意整理)
4.21美团Java实习一二面面经 ↗
面试记录为 2020-04-21、2020-04-24;原帖编辑于 2020-11-14