
RPO 和 RTO 是什么?备份、主从复制和容灾有什么区别?
下面是一段教学用的模拟面试。
🧑💻 面试官: RPO 和 RTO 是什么?有备份就能达标吗?
🙋♂️ 我: RPO 是能丢多少数据,RTO 是多久恢复。每天备份,应该就够了。
🧑💻 面试官: 业务只允许丢五分钟数据,昨晚的备份能做到吗?数据库启动了,用户却还不能登录,算恢复完成吗?
🙋♂️ 我: 还需要持续日志,以及完整业务链路恢复。
🧑💻 面试官: 那恢复目标怎么证明?备份任务绿色,还是实际演练过?
灾备能力不看“备份按钮有没有成功”,而看发生故障后能恢复到哪里、多久能重新提供业务。
面试速答(60 秒版)
RPO 是恢复点目标,表达发生故障时最多能接受多长时间范围的数据损失;RTO 是恢复时间目标,表达从故障到业务恢复能接受多长时间。
它们是业务目标,不是工具自动保证的结果。每天一份备份,不能直接满足几分钟的 RPO;服务器启动,也不一定意味着满足 RTO。
方案需要结合备份、日志、复制、切换、依赖服务和验证过程。复制减少部分数据风险,但错误删除也可能复制过去,因此不能替代可恢复的备份。
最后要通过恢复演练核对实际恢复点、业务可用时间与数据一致性。没有演练过的恢复能力,不能只凭配置表就写成已经达标。
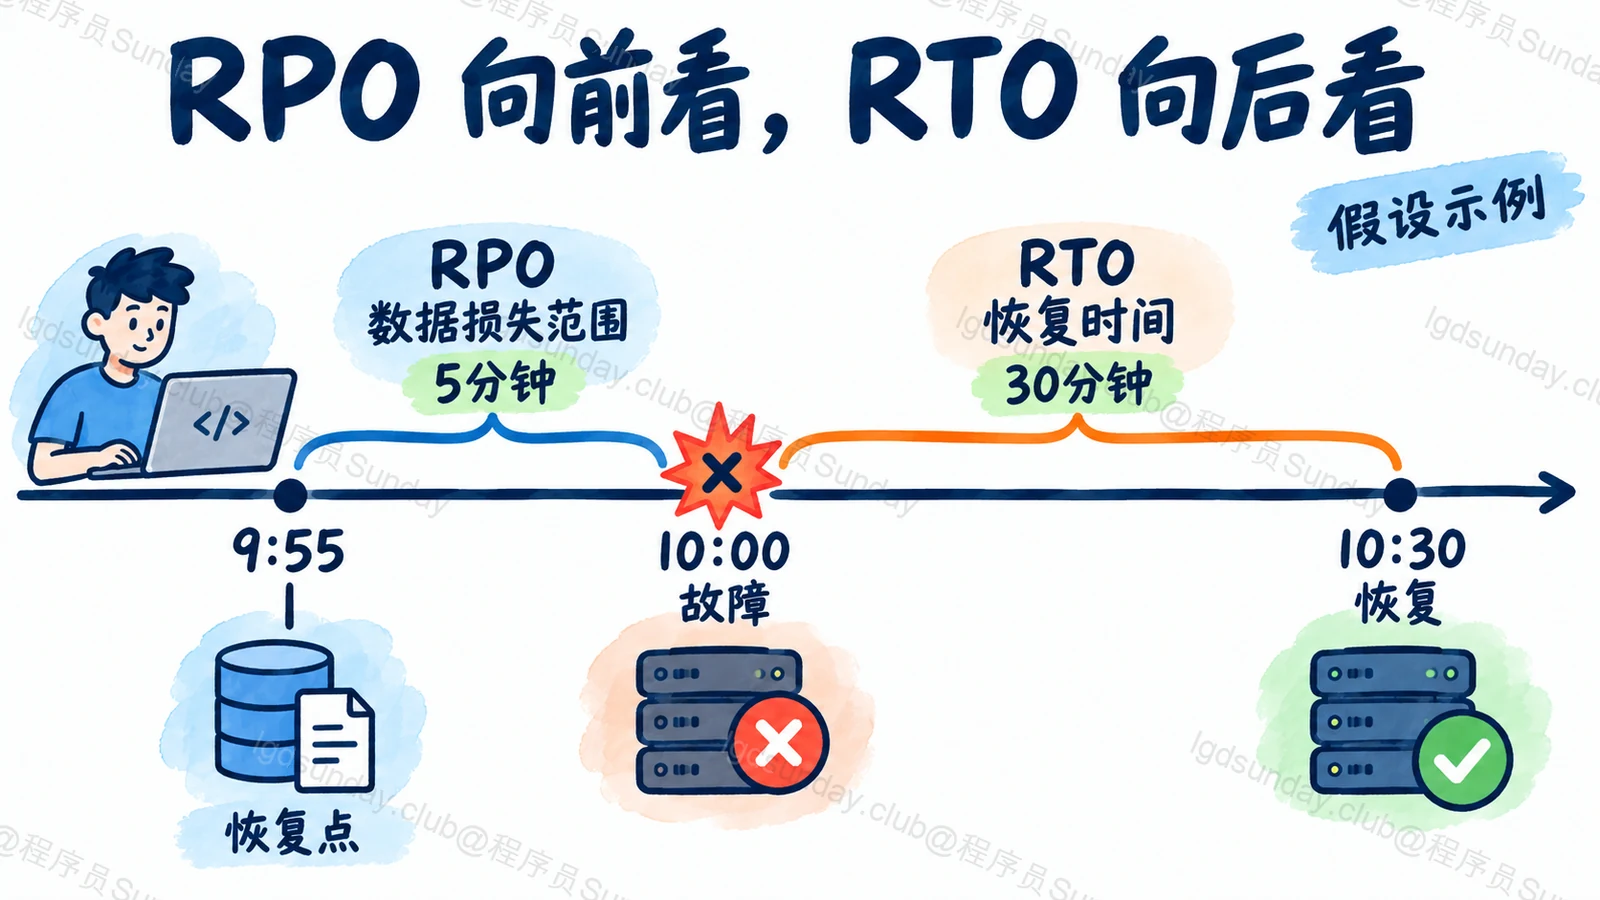
图:RPO 向前看,RTO 向后看。
知识点详解:能恢复哪些数据,与多久恢复业务,分别判断
先把两个目标画在故障时间线上
假设故障发生在 10:00,系统能够恢复到 9:55 的有效数据。数据可能损失的时间范围是五分钟,这一维度对应 RPO。
如果服务到 10:30 才重新达到约定的可用状态,那么恢复用了三十分钟,这一维度对应 RTO。
两者不是同一根刻度,也不能把“备份每五分钟执行一次”直接等同“任何故障都满足五分钟 RPO”。备份是否完成、是否可读,以及日志缺口,都要检查。
这些目标与方案取舍可以参照 AWS 灾难恢复方案说明,本文不照搬某个云产品的收益数字。
为什么只保留昨晚备份不够?
一份较早的完整备份,只能提供那时的恢复基础。想恢复到更近的时刻,还需要后续可用且完整的日志等数据。
例如 MySQL 的时间点恢复,可以从备份恢复,再应用所需的 binary log,见 MySQL 时间点恢复说明。
但是日志存在,不代表自动达到任意时刻。需要核对连续性、保留范围、停止位置与可用性,不能回放到错误操作之后,再声称避免了误删。
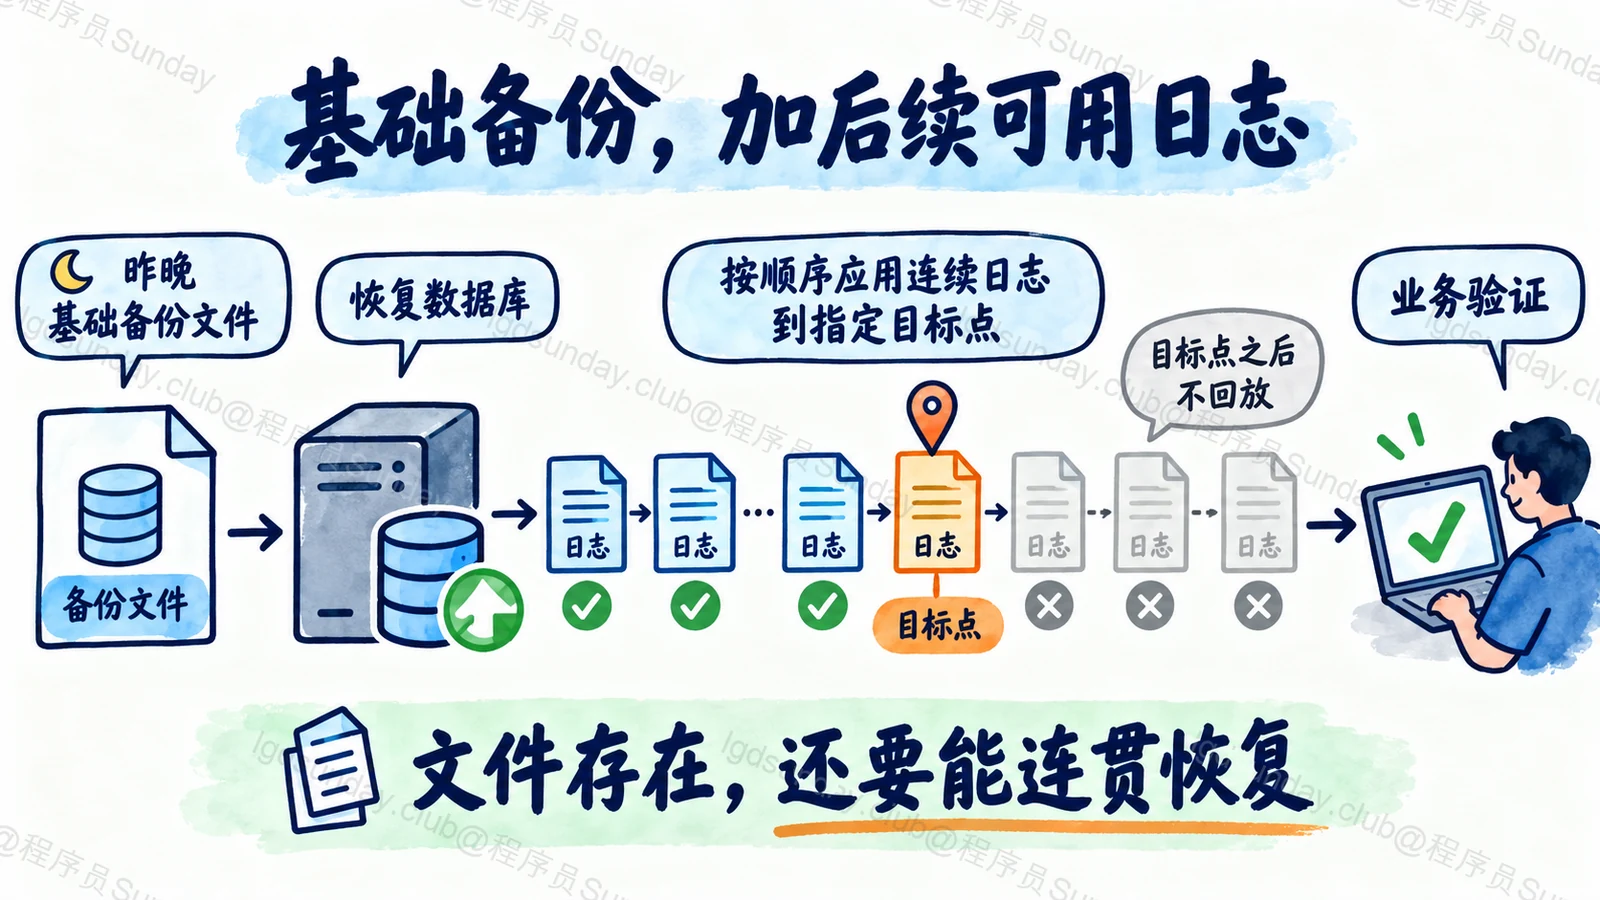
图:基础备份,加后续可用日志。
有副本,为什么仍要备份?
复制有助于提高可用性,并缩短某些故障的切换过程。但主库的误删或错误写入,也可能被复制到副本。
因此,副本与备份保护的是部分不同风险。可用副本不能替代历史恢复点;历史备份也不一定具备快速接管能力。
异步复制还有延迟和故障时未复制数据的可能。所谓“零数据损失”,必须带上故障模型与确认条件,不是勾一个复制选项就成立。
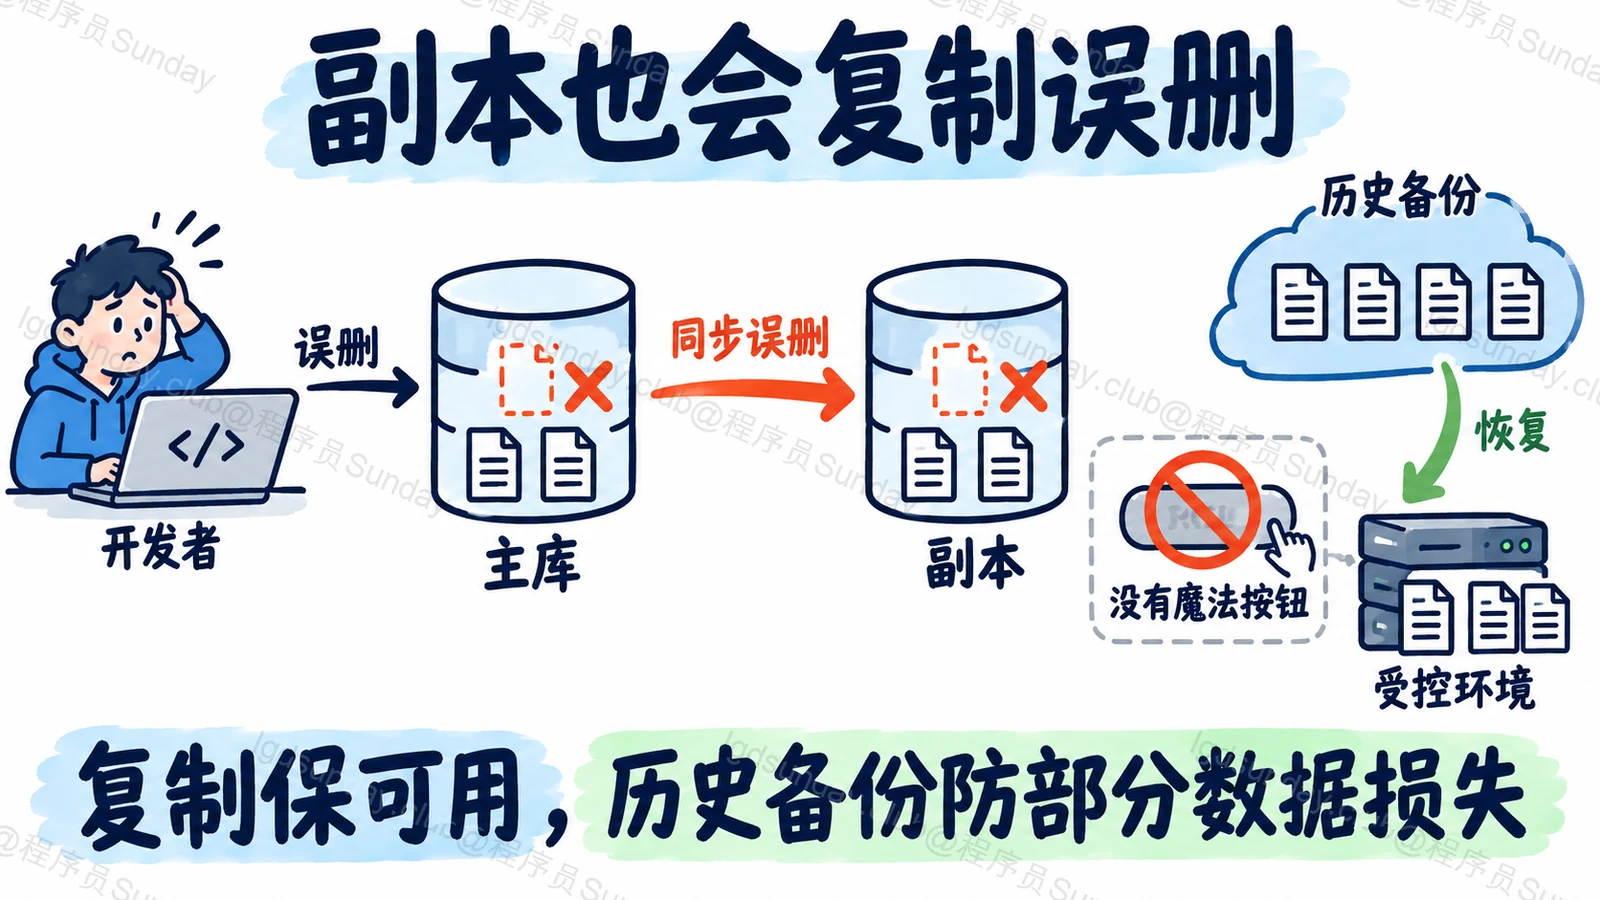
图:副本也会复制误删。
RTO 为什么不能只测数据库启动?
用户还需要应用、配置、认证、缓存、网络路由等依赖。数据库启动了,但应用连到旧地址、权限不可用,业务仍没有恢复。
因此,演练应该从实际约定的故障时刻开始计时,包含发现、决策、恢复、切换和验证。结束点也要明确,比如关键业务路径达到约定成功率与容量,而不是进程刚出现。
时间主要花在哪一步,决定我们该优化数据恢复、自动化切换,还是依赖配置。没有分段记录,就很容易把所有慢都归因于“备份太大”。
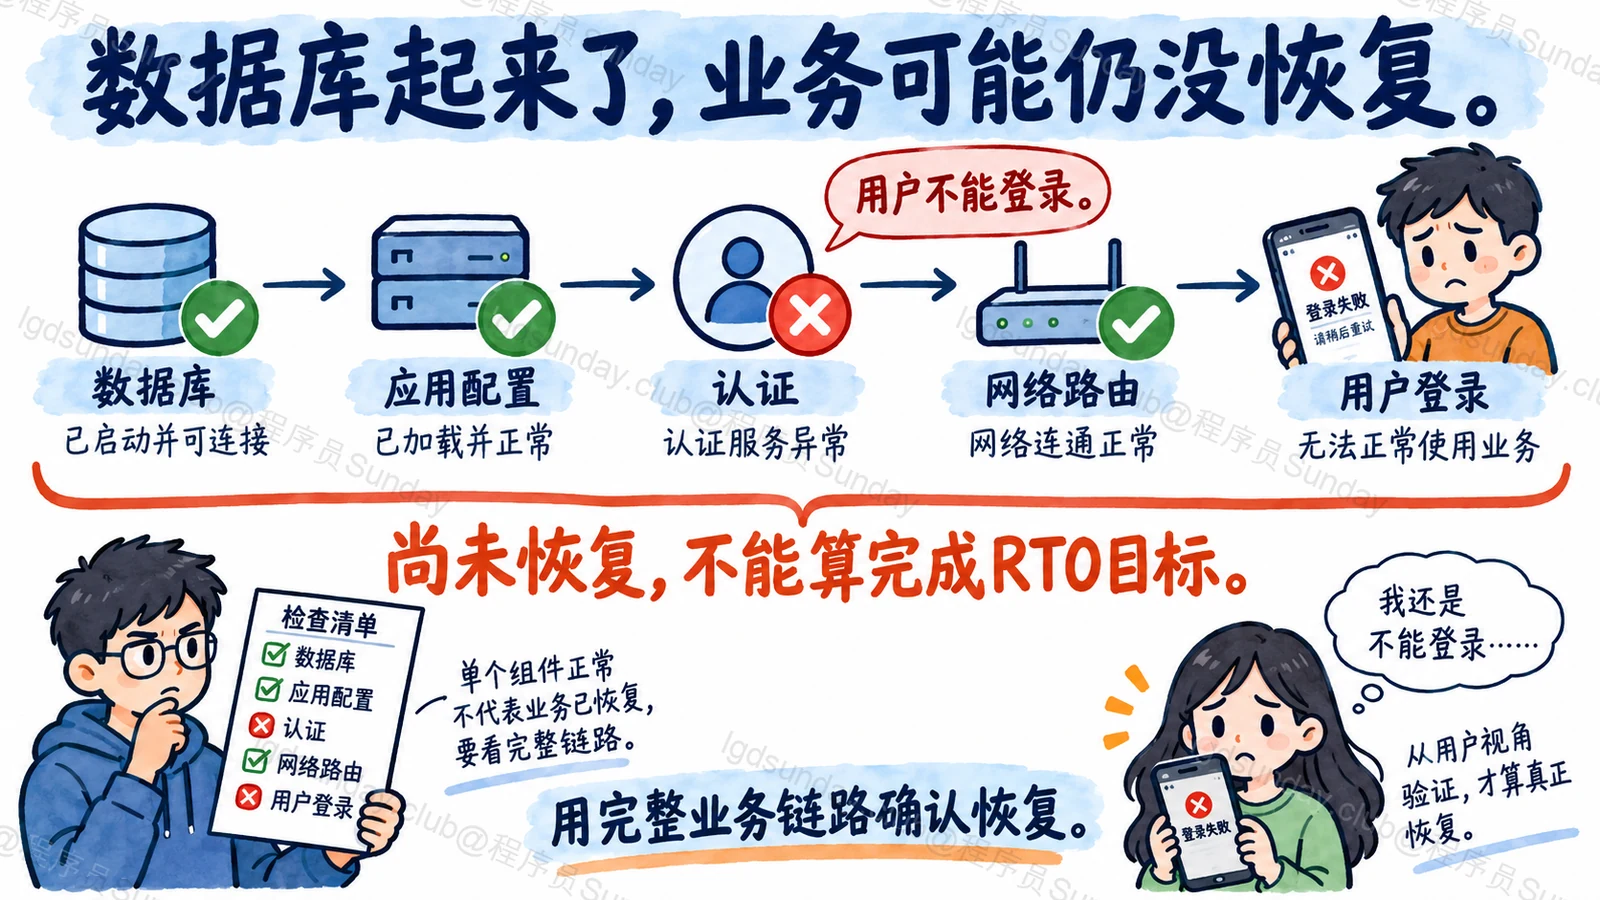
图:业务恢复,不止数据库启动。
演练怎样形成可信证据?
在受控环境按选定故障情形恢复,记录可用备份与日志、实际恢复点、各阶段耗时,以及业务核对结果。
检查权限、备份隔离和可用密钥也很重要;不能到了恢复现场才发现文件在、解密或访问条件却不在。
本文的时间是明确的假设示例,没有冒充线上恢复测量。方案越接近零损失、极短恢复,成本与复杂度通常越高,要由业务目标驱动,而不是所有系统都追同一指标。
面试官继续追问
备份校验通过,就证明能恢复吗?
不够。校验可帮助发现文件问题,实际恢复还涉及版本、依赖、日志与业务一致性。需要执行恢复验证。
怎样评估演练成功?
同时看数据恢复范围和业务恢复时间,再检查一致性与容量。只达成其中一项,不能说两个目标都满足。
面试速记卡
- RPO:可接受的数据损失时间范围。
- RTO:可接受的业务恢复时间。
- 备份与日志:基础恢复点加后续可用变化。
- 复制:帮助可用性,不替代历史恢复与误操作保护。
- 证明:恢复演练,核对数据、依赖、耗时与业务验证。
公司面试真题
这道题暂未收录可核验的公司真题来源。你可以先阅读本文解析,或浏览已收录的公司面试真题。
浏览公司面试真题 →