
HashMap 底层怎么实现?put、扩容和链表转红黑树经历了什么?
下面是一段模拟面试对话。
🧑💻 面试官: HashMap 放入一个键值对,内部会做什么?
🙋♂️ 我: 算出哈希值,找到桶,冲突就挂到链表上。链表长度到 8 就转成红黑树。
🧑💻 面试官: 桶数组只有 16 个位置,也会立刻树化吗?已经存在的 key 再 put 一次,会让 size 增加吗?
🙋♂️ 我: 树化还得看数组容量,覆盖原来的值也不算新增。
🧑💻 面试官: 那扩容时,为什么一个桶里的节点只会去两个位置?
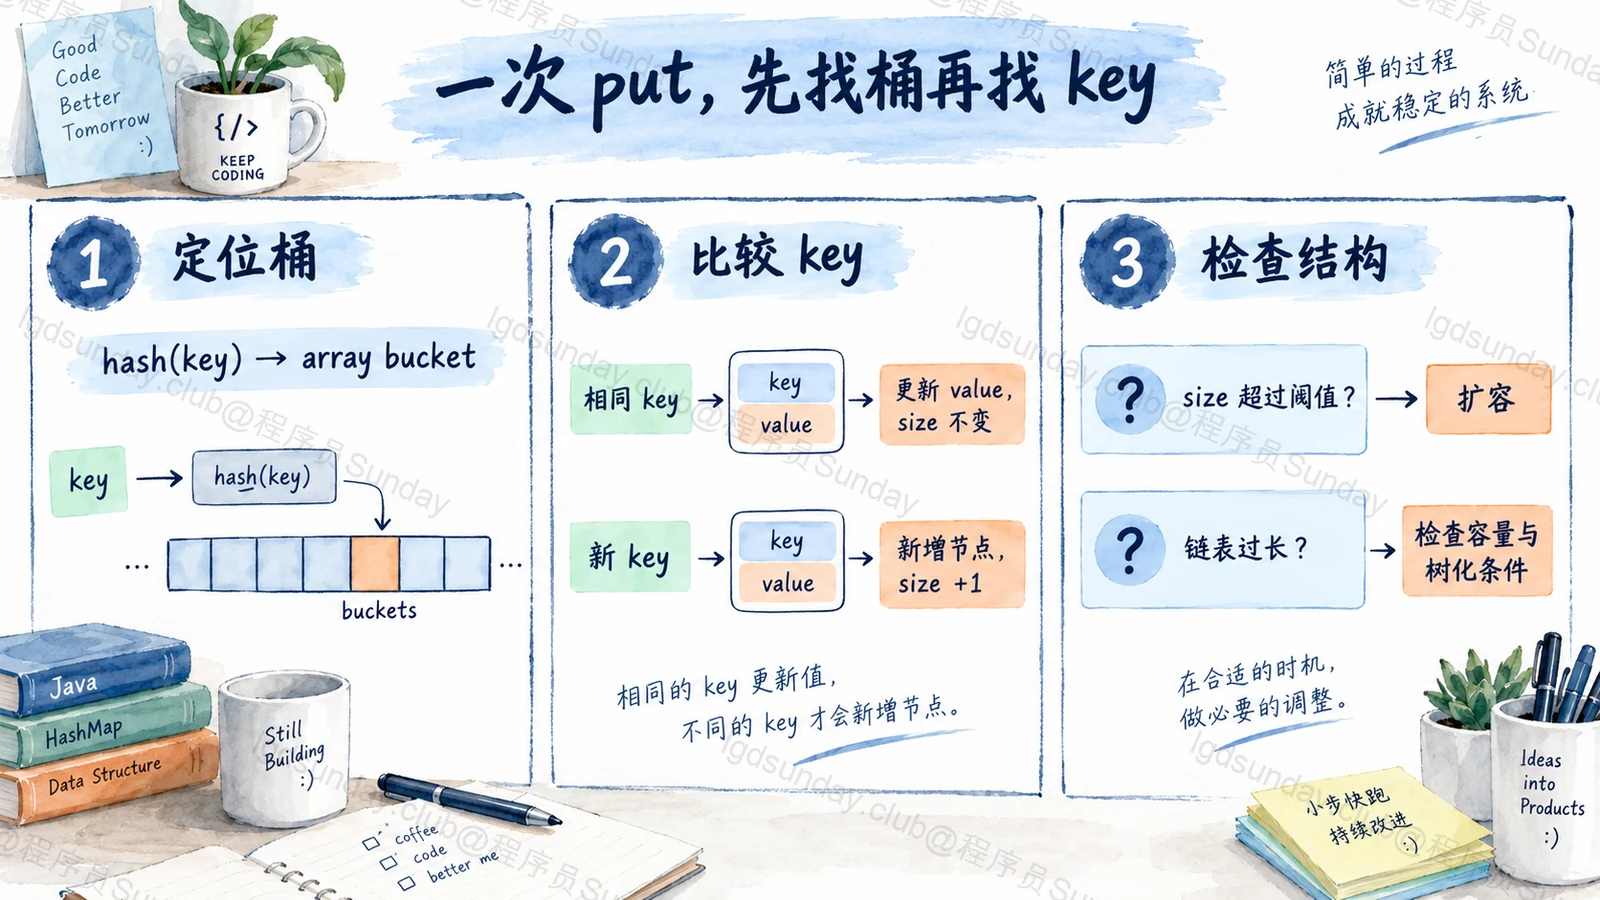
跟着一次 put 往下看,分清三件事就好:找到哪个桶、覆盖还是新增、什么时候需要改变存储结构。
面试速答(60 秒版)
以 OpenJDK 21 的实现为例,HashMap 主要用桶数组保存节点,同一个桶里可以是链表,也可以是红黑树。
put 时先对 key 的哈希值做扰动,再用数组长度定位桶。桶为空就放入新节点;桶不为空,就继续比较 key,找到相同的 key 时更新值,没有找到才插入。
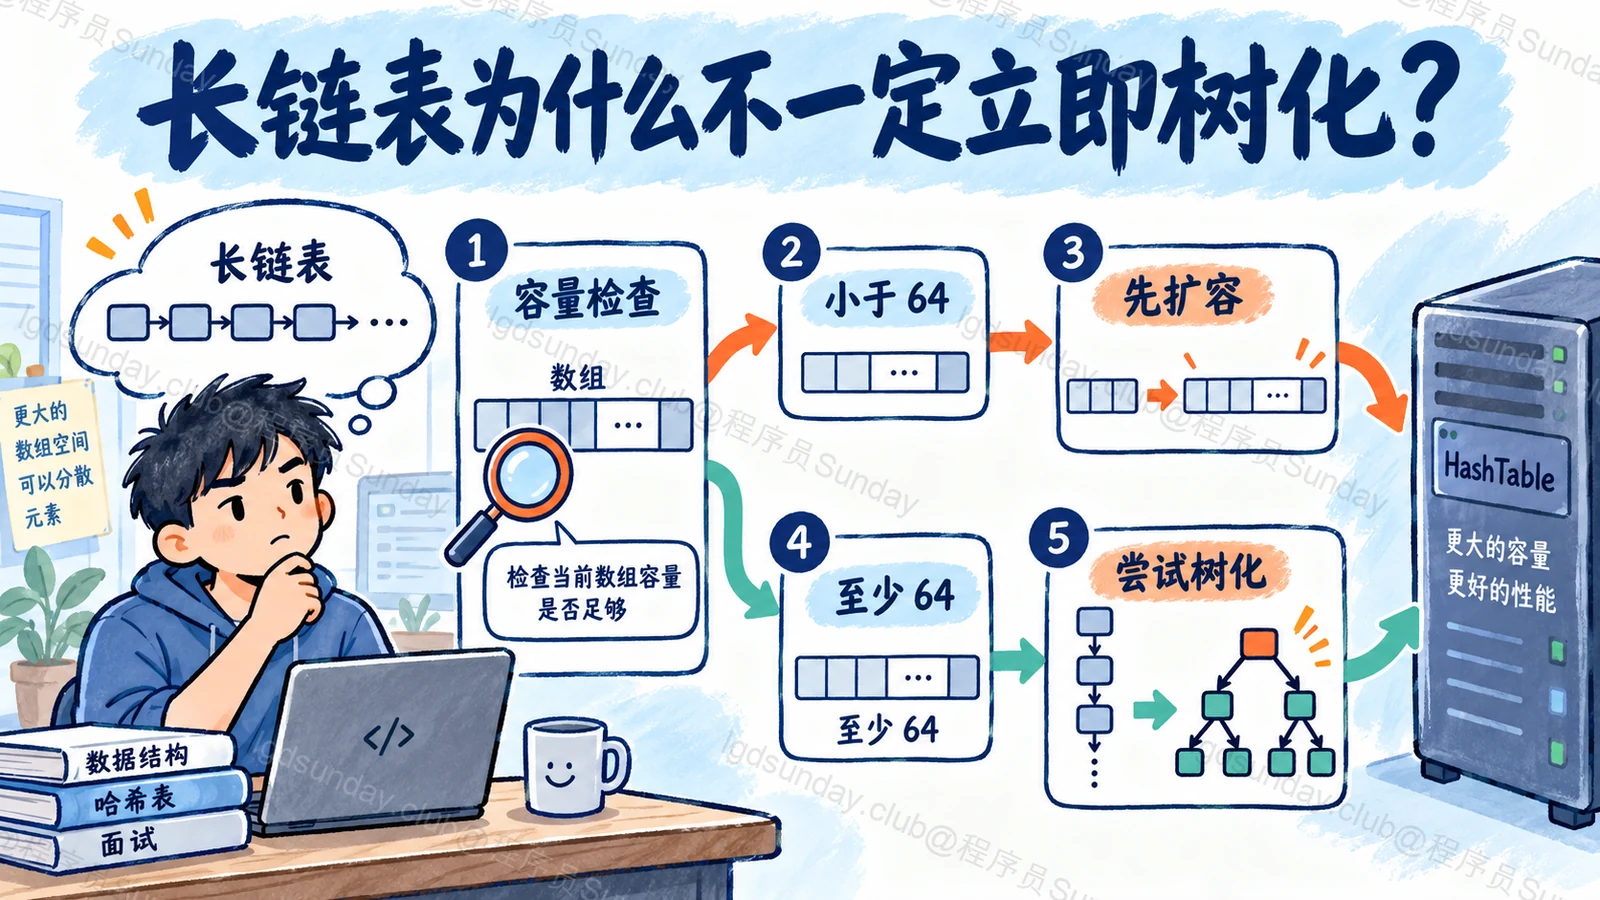
插入后,节点总数超过容量对应的扩容阈值,会触发扩容。另外,链表过长时会尝试树化,但数组容量小于 64 时,会先扩容,不能只背“长度到 8 就变红黑树”。
扩容通常把数组容量翻倍。因为容量保持为 2 的幂,旧桶里的节点只需要检查哈希值中的一个新增位,就能决定留在原位置,还是移动到“原位置+旧容量”。
知识点详解:沿着一次 put 看 HashMap 的内部变化
先有桶的位置,才有桶里的查找
假设我们有一张容量为 16 的桶数组,现在要放入一条用户记录。
HashMap 不会从第一个桶开始找空位。它会根据 key 计算哈希值,再算出这条记录应该落到哪个桶。JDK 21 的桶下标计算可以写成 hash & (n - 1),这里的 n 就是数组容量。
为什么容量要保持为 2 的幂?拿 16 来说,n - 1 的低四位都是 1,与运算正好保留哈希值的低四位。容量变成 32 时,就会再多使用一位。扩容时只需要检查这一位,原因也在这里。
源码还会把原始哈希值的高位混入低位。这样做是为了减少“高位不同、低位相同”的 key 挤到同一桶里的情况,不代表哈希冲突从此消失。实现细节见 OpenJDK 21u HashMap 源码。
同一个桶,不代表同一个 key
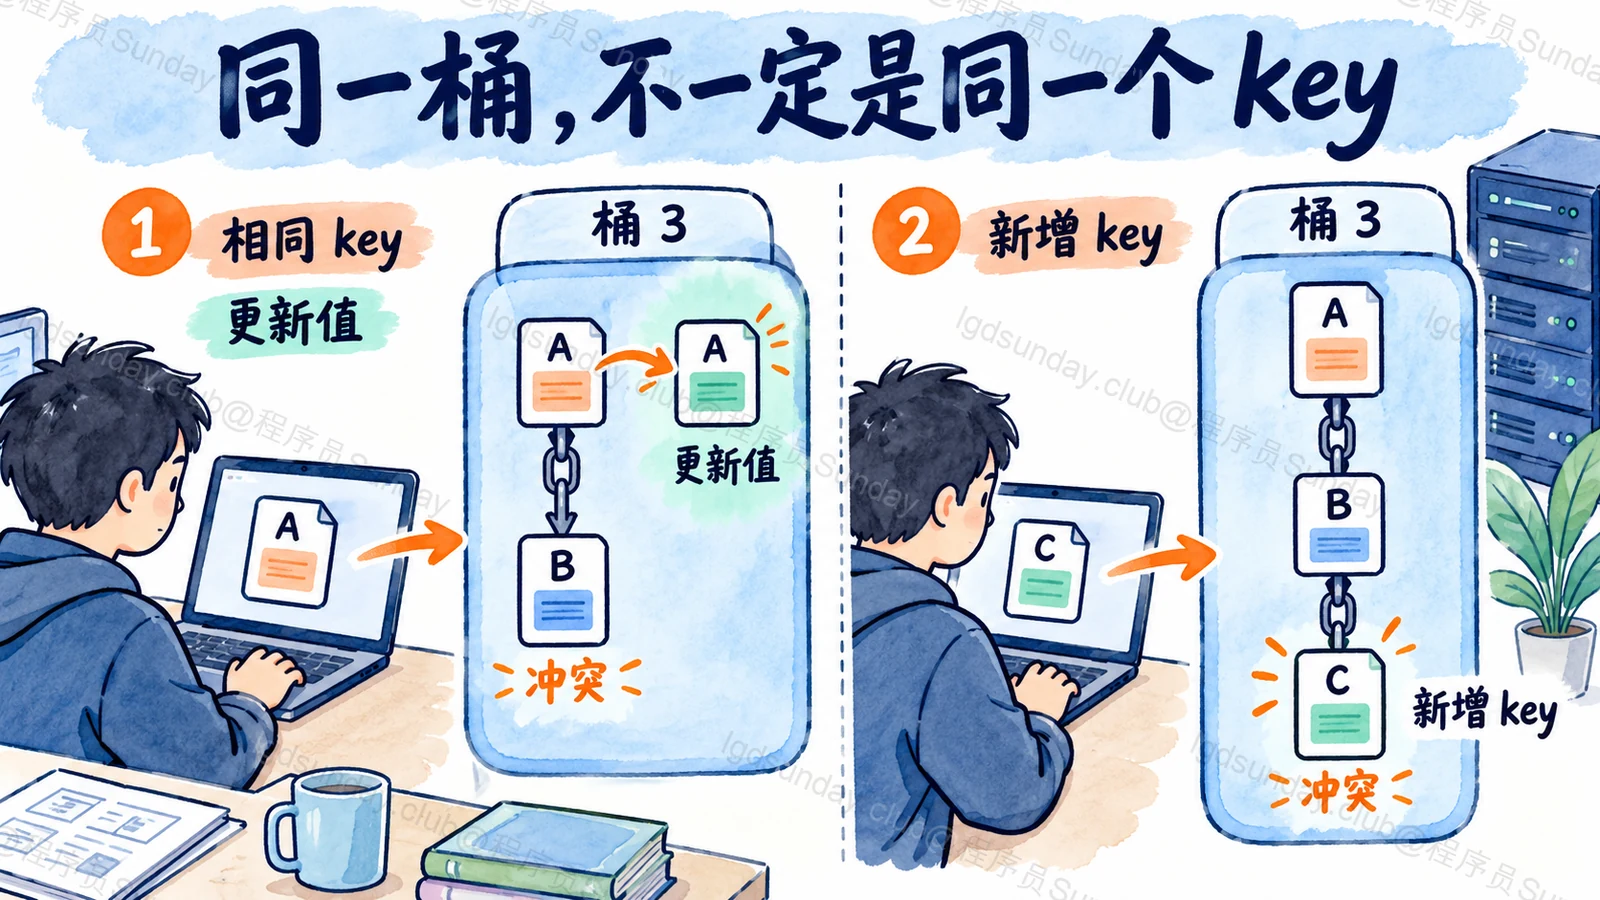
找到桶以后,我们还要回答一个问题:里面是否已经有这条 key?
如果有,就更新这个节点的 value。如果没有,才增加一个节点。这里会用哈希值配合 key 的身份或 equals 判断,不能看到桶位置相同就覆盖。
所以要区分两个数量:桶数组的容量,以及 整个 Map 的元素数 size。覆盖已有 key 不会让 size 增加;一个桶里放了多个节点,也不会凭空增加数组长度。
这也解释了为什么 key 放进去以后,不应该再修改参与 equals、hashCode 的字段。下一次拿这个对象查找时,可能算出了另一个桶的位置,原来的记录却还躺在旧桶里。
树化和扩容,在解决不同的问题
数组容量不足,处理的是整体装载问题;某个桶里的链表过长,处理的是局部查找问题。
默认负载因子是 0.75。比如桶数组容量为 16,通常对应阈值 12,新增后 size 超过这个阈值,就需要扩容。但这不等于“第 13 次调用 put 必定扩容”,前面如果有重复 key,就没有增加那么多元素。
树化也要带上条件。源码里有树化阈值 8,但具体触发还取决于插入路径和已有节点的计数。对于普通 put 的链表尾插路径,不能把它简化成“刚出现第 8 个节点就一定树化”。而且在真正转换之前,还会检查桶数组是否至少有 64 个位置。
如果数组还很小,先扩容可能已经能把这些节点分散开,就没必要马上维护一棵树。这里要理解动机,不要把几个数字背成没有条件的口令。
扩容不是把所有 key 再调用一遍 hashCode
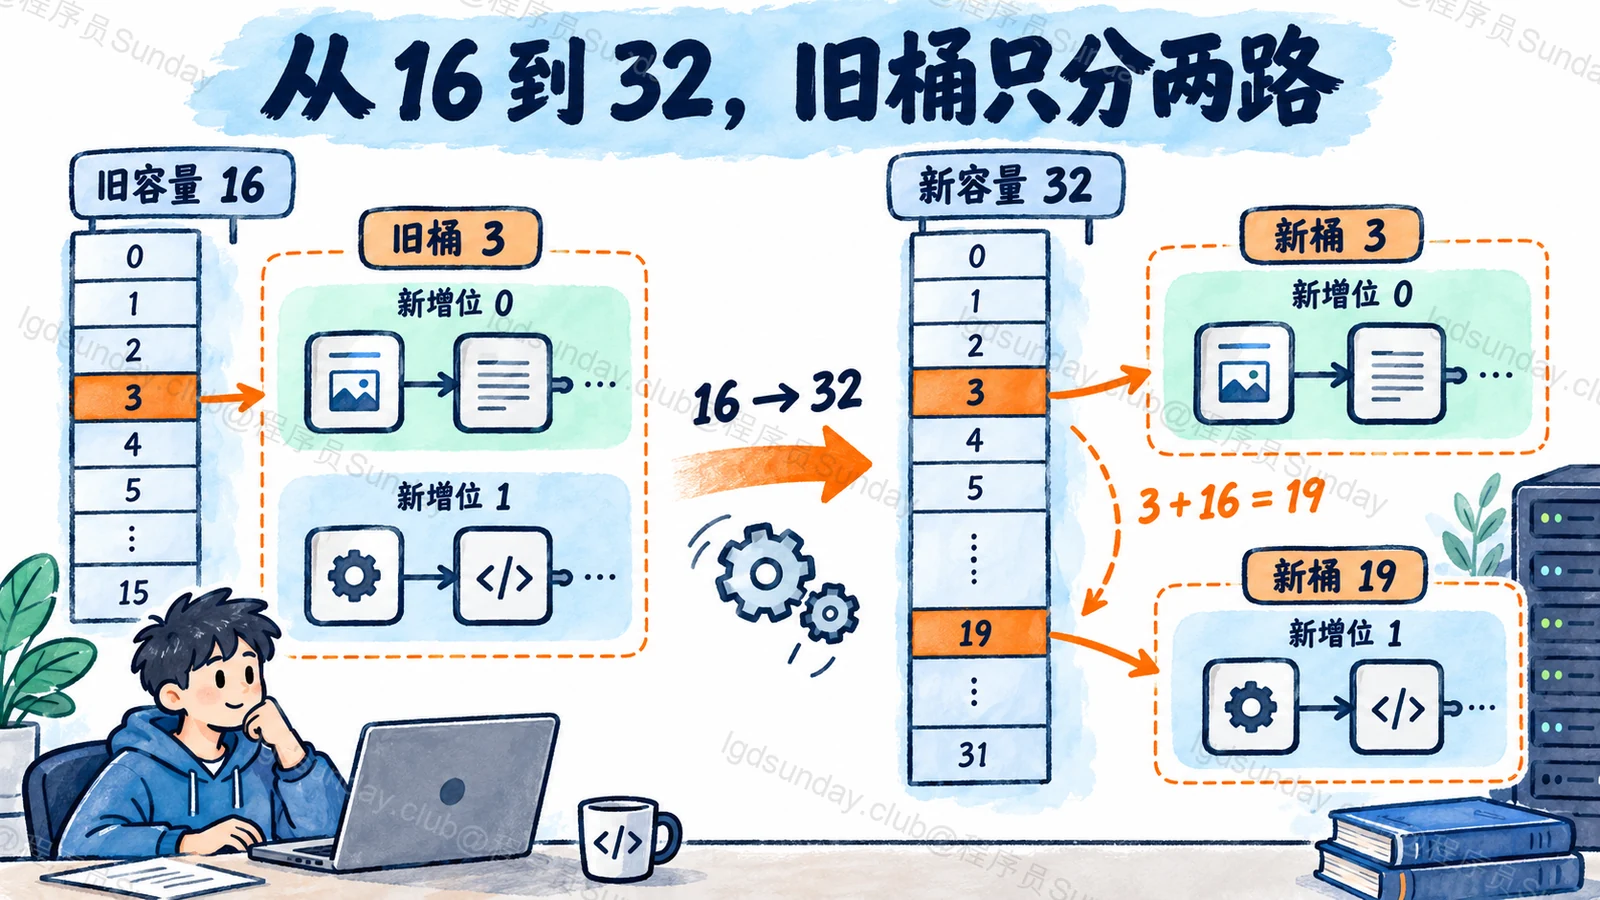
假设旧容量为 16,某个桶的下标为 3。扩容到 32 后,这个桶里的节点只可能去下标 3 或 19。
为什么?旧下标使用的是哈希值低四位,新下标多使用第 5 位。新增的那一位为 0,就留在 3;为 1,就移动到 3 + 16。
源码利用节点里已经保存的哈希值完成拆分,不需要重新调用每个 key 的 hashCode。链表节点还能按这两组分别串起来。理解这一步,比只记住“扩容很耗性能”更能说明你确实看懂了迁移过程。
面试官继续追问
红黑树出现以后,任何恶意 key 都能保证 O(log n) 吗?
不要把实现策略说成没有前提的复杂度保证。树节点的定位还涉及哈希值、可比较性以及同哈希对象的查找方式。通常的树查找分析有适用条件,不能对所有自定义坏 key 一概承诺。HashMap API 对性能和键比较的说明也值得一起看。
怎么验证自己讲的扩容路径?
固定 JDK 版本,准备哈希值可控的自定义 key,再观察 putVal、resize、treeifyBin 三处逻辑。至少分别检查覆盖已有 key、总量超阈值和单桶冲突三种情况。不要拿另一版 JDK 的运行结果给当前版本作证明。
面试速记卡
- 定位桶:扰动后的哈希值与容量一起决定下标。
- 桶内查找:哈希冲突不等于 key 相同,相同 key 更新值。
- 扩容:总量阈值和小容量下的长链表都可能触发。
- 树化:看链表情况,也看桶数组容量,不能只背一个 8。
- 迁移:容量翻倍后,节点留在旧位置,或去旧位置加旧容量。
公司面试真题
真题根据求职者公开面经整理,题意经过概括,非逐字原话或公司官方题库;本文为 Sunday 的独立解析。
美团 · 开发(含 AI 项目追问) · 原帖未明确批次
介绍一下 Java 的 HashMap。(题意整理)
美团面经 ↗
原帖发布于 2025-09-09字节跳动 · 后端(番茄小说) · 实习
HashMap 怎样实现,何时扩容,扩容的时间复杂度是多少?(题意整理)
【字节跳动】番茄小说部门 后端实习 ↗
面试记录为 2021 年 1 月;原帖发布于 2022-04-29京东 · Java后台 · 校招
HashMap 的实现原理是什么?(题意整理)
京东 Java 后台三面凉经 ↗
原帖编辑于 2019-08-23(历史校招面经)阿里巴巴 · Java后端 · 社招
HashMap 的 put、get、扩容与链表转红黑树怎样实现?(题意整理)
社招一年半面经分享 · 阿里部分 ↗
历史面经,面试年份未明确;页面编辑于 2024-07-19百度 · Java后端 · 2022届校招提前批(原帖标题)
HashMap 的底层结构是什么,何时扩容,链表何时转红黑树?(题意整理)
2022百度校招提前批java后端一面面经 ↗
原帖发布于 2021-07-13;标题的 2022 为校招届次字节跳动 · 后端 · 原帖未明确批次
是否了解 HashMap 的底层实现?(题意整理)
字节后端一面凉经 ↗
页面显示 03-13 发布,未明确年份野村证券 · 开发(原帖未明确细分岗位) · 实习
介绍 HashMap 的底层实现。(题意整理)
野村证券实习面经(Offer) ↗
正文记录 4 月 29 日二面;原帖编辑于 2022-05-11