
Node.js 的 Buffer 是什么?它和字符串有什么区别,为什么会出现中文乱码?
下面是模拟面试对话,用来讲解本题,不是真实面经。
🧑💻 面试官:Buffer 和字符串有什么区别?
🙋♂️ 我:Buffer 是二进制数据,可以用 toString 转成字符串。
🧑💻 面试官:收到两块数据,每块都 toString,再拼起来,结果一定正确吗?
🙋♂️ 我:如果编码都用 UTF-8,应该可以。
🧑💻 面试官:一个汉字的字节恰好被拆到两块里呢?还有,修改一段 subarray,会不会影响原 Buffer?
先分清字节和字符,再看两个边界:解码边界,以及内存是否共享。
面试速答(60 秒版)
Buffer 保存的是一串字节。字符串保存的是文本;把两者互相转换时,我们需要指定字符编码。
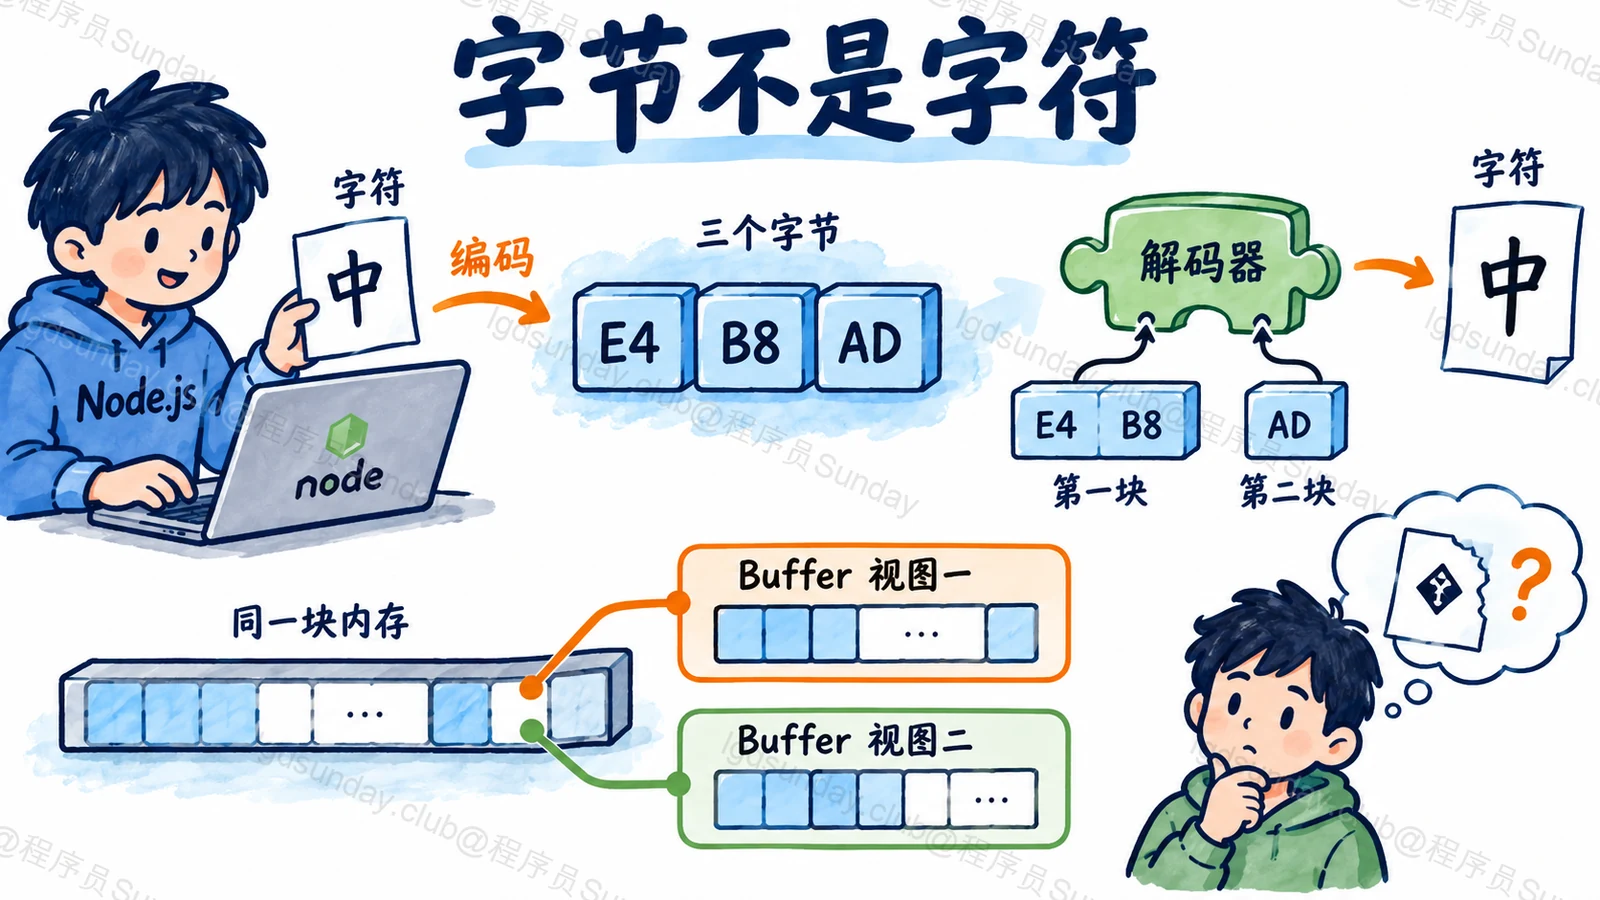
因此,字符串长度不一定等于 Buffer 长度。比如“中”用 UTF-8 编码占 3 个字节,但不能由此说所有中文相关字符都占 3 个字节。
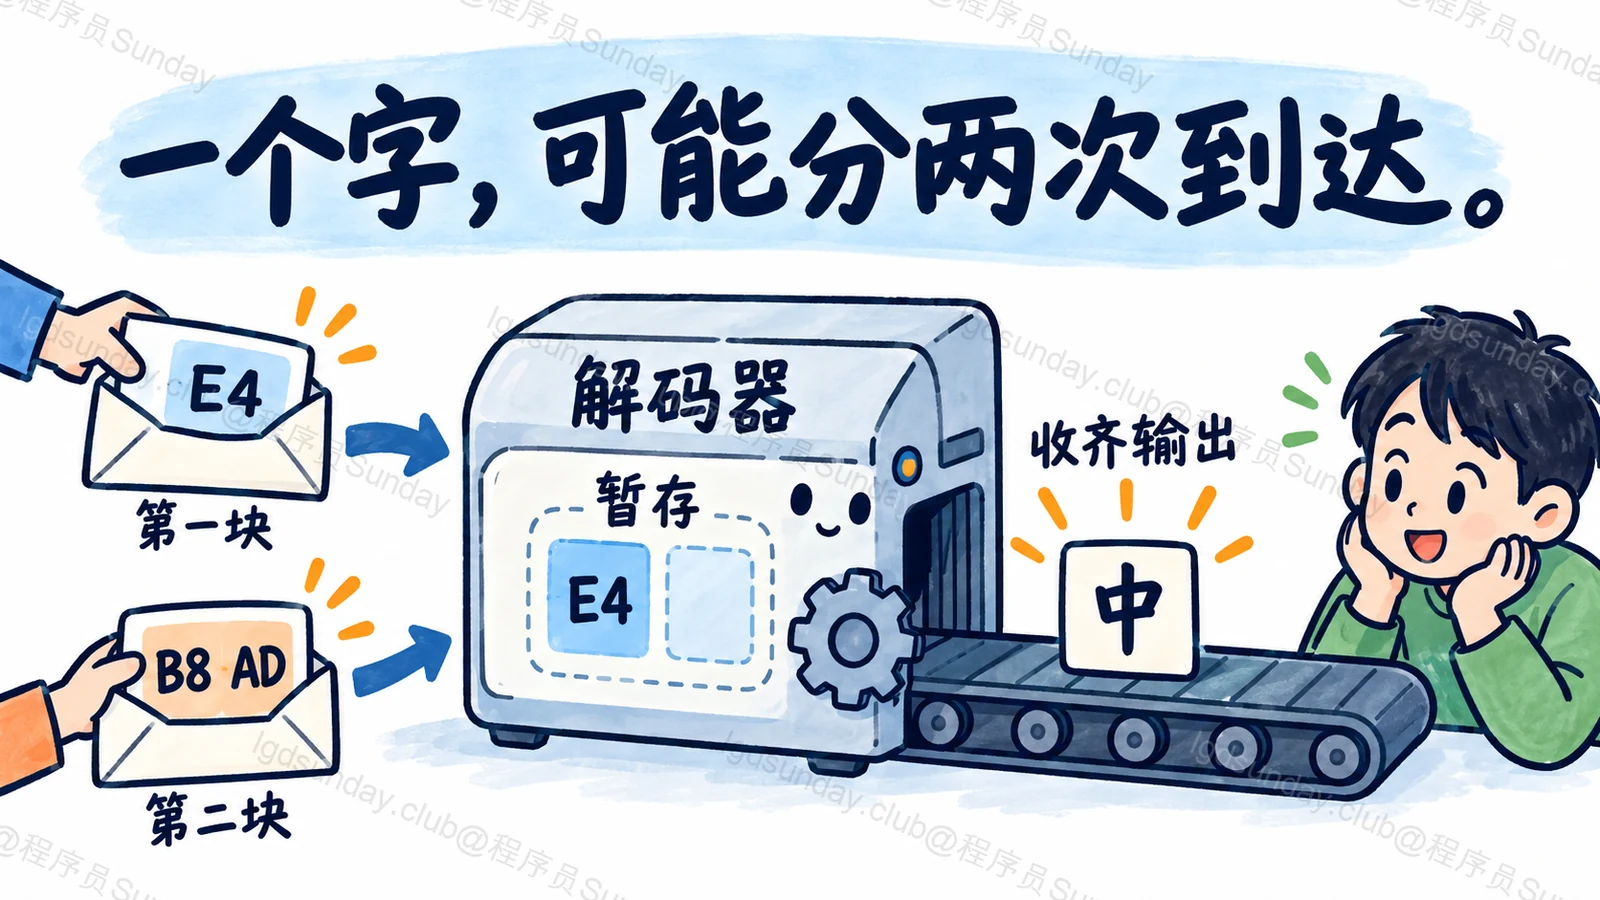
如果数据分多次到达,一个字符可能被拆开。每块单独 toString() 会丢失这种跨块关系,可以用 StringDecoder 暂存未完成的字节,再接着解码。
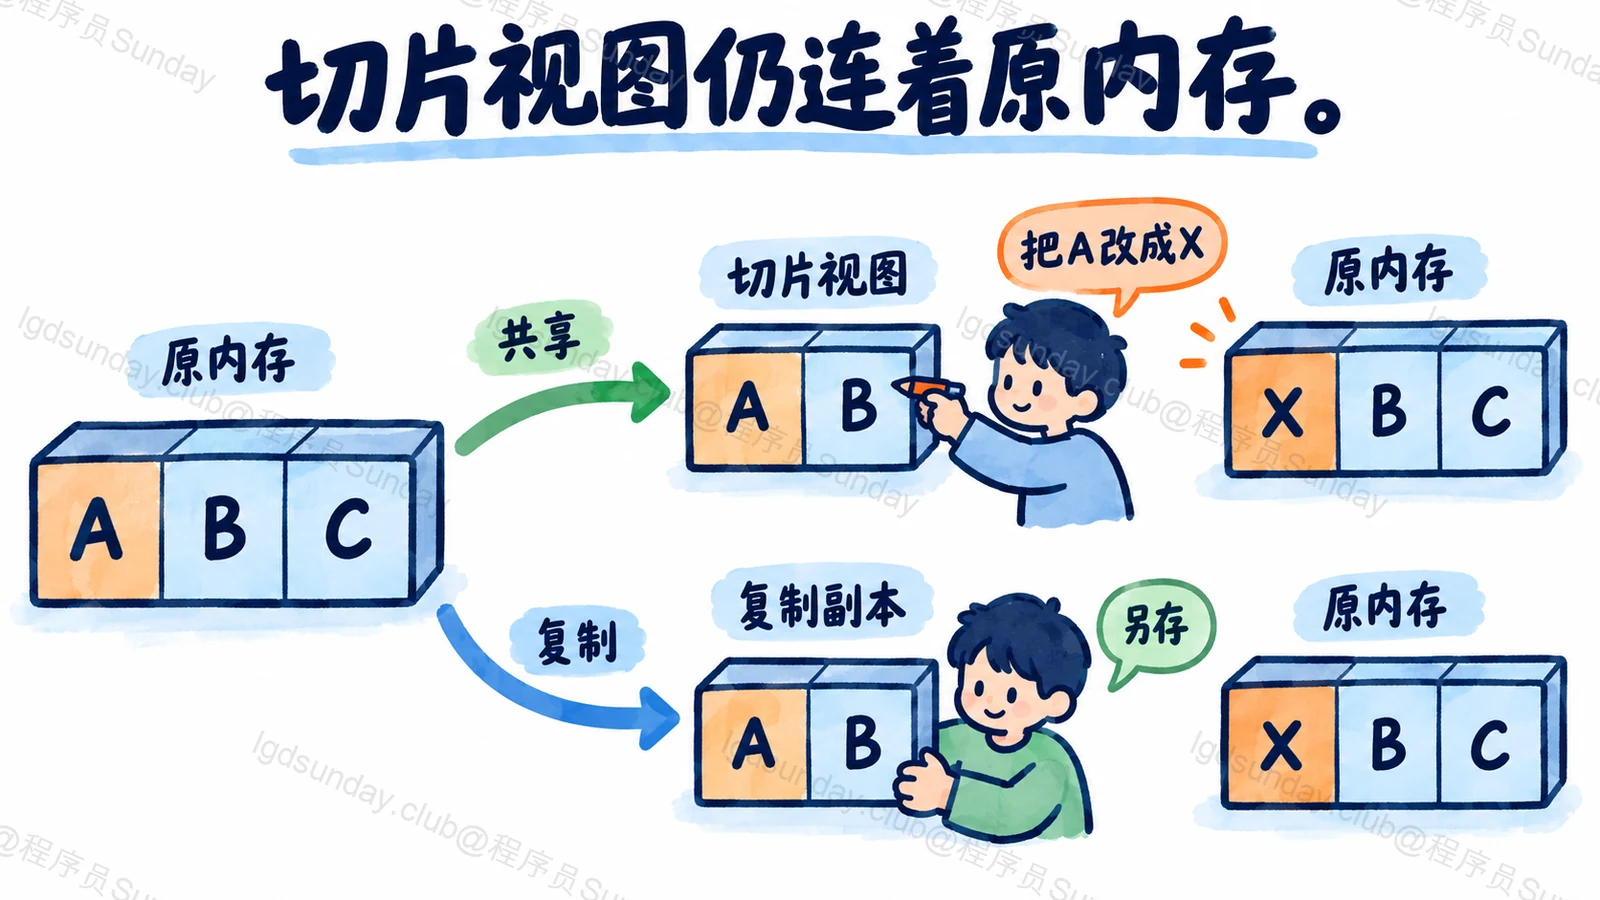
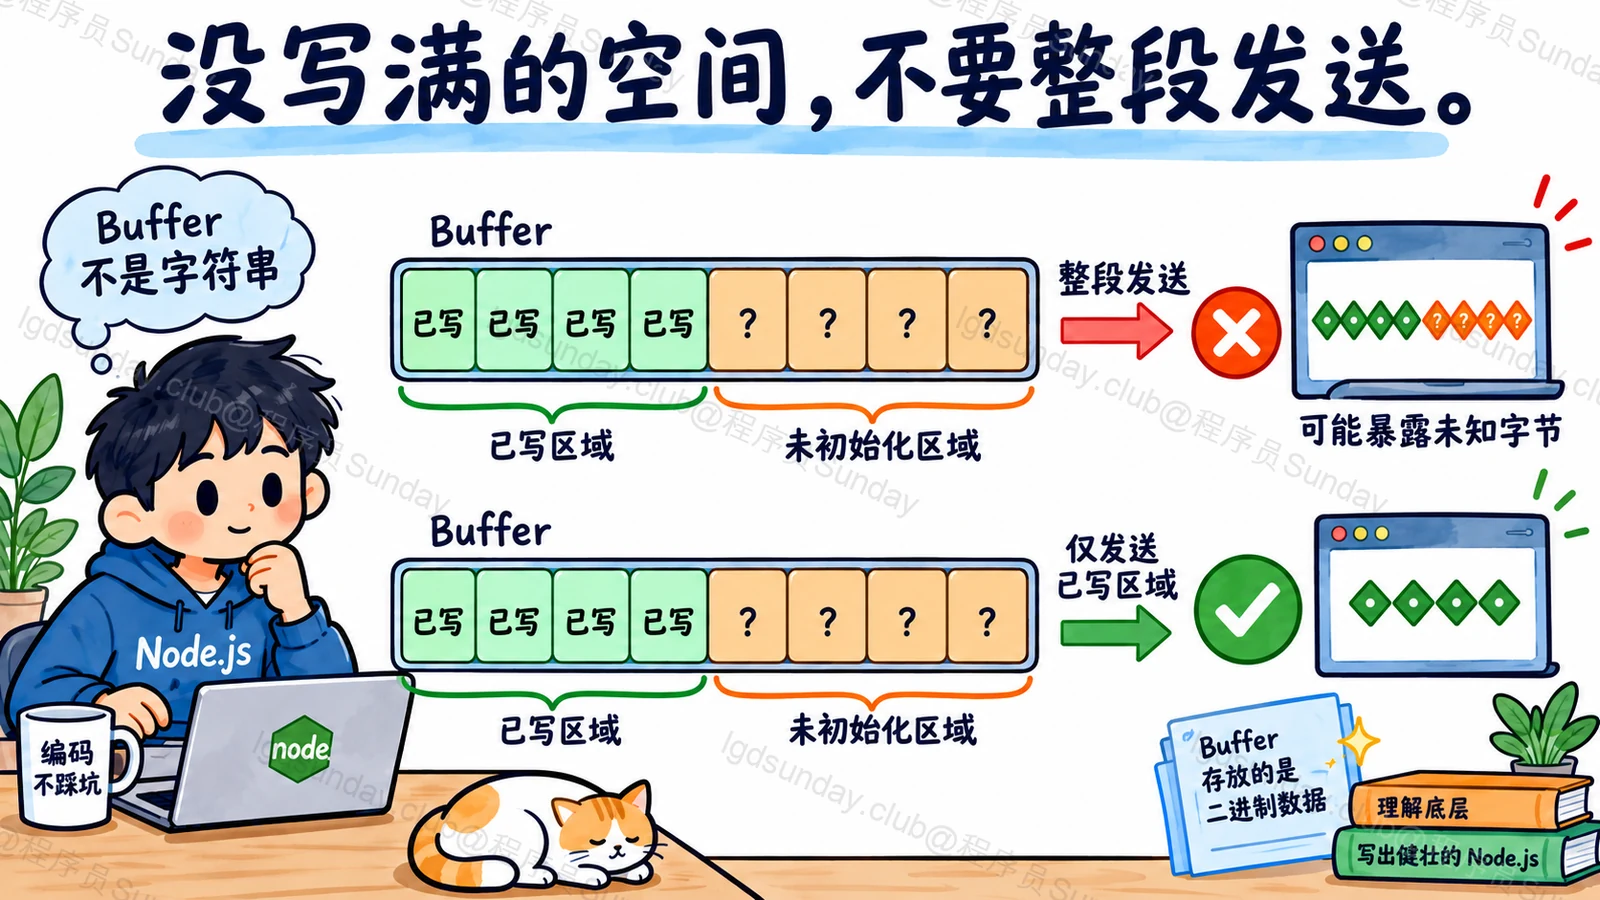
内存也需要留意。subarray() 得到的是共享内存的视图,修改它可能影响原 Buffer;需要独立副本时,可以对这段 Buffer 使用 Buffer.from()。新建空间通常优先用 alloc(),不能把 allocUnsafe() 未填满的内容直接发出去。
知识点详解:先看字节,再看它们如何变成文字
同一段文字,有两种不同的长度
假设日志里只有一个“中”字。JavaScript 的 "中".length 是 1,而 Buffer.from("中", "utf8").length 是 3。前者数 UTF-16 代码单元,后者数编码后的字节。
再换成一个 emoji,JavaScript 的 length 也可能超过 1。所以统计网络包大小,要按实际编码后的字节数算;按字符串 length 限制上传大小,可能得到错误结果。
编码可以理解成文字与字节之间的约定。发送方按 UTF-8 写,接收方按另一套约定读,即使传输没丢字节,也可能乱码。Buffer 本身不会替我们证明这串数据一定是合法 UTF-8。
分块到达,不能逐块当成完整文本
“中”的 UTF-8 字节是 E4 B8 AD。假设第一块只有 E4,第二块才有 B8 AD。第一块还不足以组成这个字,单独解码时可能出现替换字符。随后把两段字符串拼起来,原字节关系已经丢了。
下面演示跨块解码。TS 使用 Node 的 StringDecoder;Python 使用标准库增量解码器,遇到非法或结束时残缺的数据会按这里指定的 strict 策略报错。两者默认错误策略并不相同。
TypeScript(Node.js)
import { Buffer } from 'node:buffer';
import { StringDecoder } from 'node:string_decoder';

const bytes = Buffer.from('中文🙂', 'utf8');
const decoder = new StringDecoder('utf8');
const text = decoder.write(bytes.subarray(0, 1))
  + decoder.write(bytes.subarray(1, 5))
  + decoder.end(bytes.subarray(5));
console.log(text); // 中文🙂
Python
import codecs

raw = '中文🙂'.encode('utf-8')
decoder = codecs.getincrementaldecoder('utf-8')(errors='strict')
text = decoder.decode(raw[:1]) + decoder.decode(raw[1:5])
text += decoder.decode(raw[5:], final=True)
print(text)  # 中文🙂
这只解决字符被拆开的情况。如果应用消息也被拆开,还需要自己的消息边界处理,不能把一次收到的数据直接当成一条完整业务消息。
切出来的 Buffer,可能仍用原来的内存
假设原 Buffer 是一条待发送记录。截取头部后改了第一个字节,如果截取方式是 subarray,原记录也会变。这是共享视图的结果。
Buffer.from(existingBuffer) 会复制这个 Buffer 的内容,适合需要独立保存或修改的情况。但 Buffer.from(arrayBuffer, ...) 有不同的共享语义,不能只记“from 一定复制”。
Python 也有相似区别。memoryview(bytearray) 可以共享底层数据,bytes(...) 则生成不可变字节内容。这里只比较内存关系,不把 Python 的切片规则冒充成 Node 的规则。
分配空间快,不代表内容可以直接发送
Buffer.alloc(size) 会初始化内容。allocUnsafe(size) 则不保证得到的是全零空间,如果只写了前半段就发送整个 Buffer,后半段可能包含不该暴露的数据。
排查乱码时,我会先保留原始字节,确认发送和接收编码,再检查分块边界。排查内容被改动时,则追共享视图。两个问题不能只靠多调用一次 toString 来解决。
技术依据:Node.js Buffer、Node.js StringDecoder。工程场景与解法按本文说明的条件展开。
面试官继续追问
Buffer.slice 和普通数组 slice 一样吗?
不一样。Buffer.slice历史上共享内存,当前文档已弃用并建议subarray。普通数组slice浅复制数组容器;不要凭同名推断行为。
增量解码器能修复丢掉的字节吗?
不能。它能等待后续块,不能恢复传输中已经丢失或被替换的内容。结束时残缺还需要明确错误策略。
面试速记卡
- 存储:Buffer按字节保存数据,文字需要编码约定。
- 长度:字节数、UTF-16代码单元数、用户看到的字符数可能不同。
- 乱码:跨块字符要用增量解码,不能逐块转字符串再拼。
- 内存:subarray共享,Buffer.from(Buffer)复制。
- 安全:allocUnsafe未写满的数据不能直接发送。
公司面试真题
真题根据求职者公开面经整理,题意经过概括,非逐字原话或公司官方题库;本文为 Sunday 的独立解析。
颂拓运动 · Web前端 · 原帖未明确批次
Node.js 的 Buffer 和普通 Array 有什么区别?(题意整理)
颂拓运动前端面试(web)面经 ↗
页面显示 08-31 编辑,未明确年份