
Java 服务 CPU 飙高怎么排查?如何定位到具体线程和代码?
下面是一段教学用的模拟面试。
🧑💻 面试官:Java 服务 CPU 突然很高,你怎么查?
🙋♂️ 我:先 top 找进程,再 top -H 找线程,把线程编号转成十六进制,从线程栈里找代码。
🧑💻 面试官:你只抓了一次栈,看到一个方法,就能证明它一直消耗 CPU 吗?100% 又是占满一核,还是占满整个机器?
🙋♂️ 我:要确认指标口径,并把一段时间的线程 CPU 和调用栈对应起来。
🧑💻 面试官:那高的是 GC 线程呢?如果业务用了虚拟线程,操作系统线程编号还能直接对应每个业务任务吗?
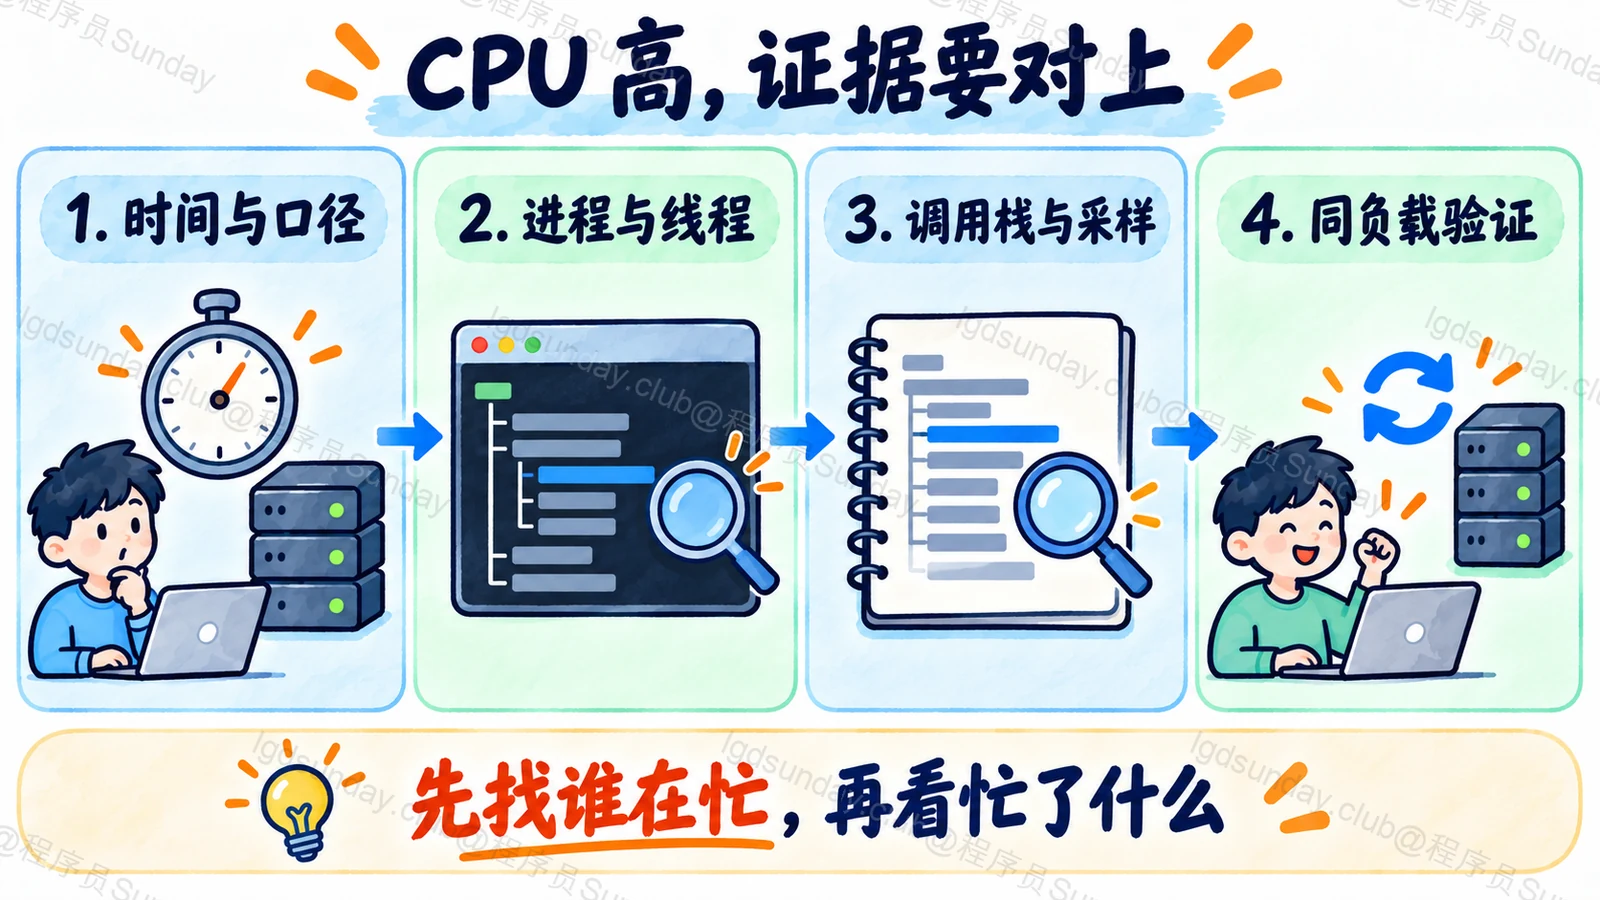
排障要把三份证据对上:「哪段时间 CPU 高、谁在用 CPU、它反复在做什么」。
面试速答(60 秒版)
我会先确认影响范围和 CPU 指标口径:是整个节点、某个进程,还是容器配额被打满,同时看请求量、延迟、错误和最近发布。
对于 Linux 上使用平台线程的 Java 进程,可以用 top -H 等工具定位持续消耗 CPU 的线程,再把线程 ID 转成十六进制,与线程转储中的 nid 对应。需要多次观察或进一步采样,不能拿一次栈截图就认定热点。
之后区分业务计算、无效循环、GC、锁竞争或系统调用等分支。虚拟线程不能直接按一条操作系统线程对应一个任务来查,要结合支持它的转储与分析工具。最后用修复前后的相同指标验证效果,而不是只看 CPU 暂时下降。
知识点详解:从一个告警,走到可以修改的代码
先弄清楚“高”指的是什么
假设一个订单服务触发 CPU 告警,但页面还能打开,只是响应变慢了。
第一步不要马上改线程数。先看指标属于节点、进程还是容器,以及百分比的分母是什么。在某些工具口径下,一个线程吃满一核就能接近 100%,多核进程还可能超过 100%;监控平台也可能把整个配额归一化为 100%。
容器还有 CPU 限额与节流情况。节点仍有空闲,不代表这个容器可以无限使用。需要同时查看 quota、throttling 和实际使用率,避免把配额限制误判成整机资源耗尽。
再对齐告警时间的请求量、延迟、错误、发布与任务启动记录。请求量翻倍带来的计算增多,和请求量不变却出现死循环,后续方向并不一样。
先找进程,再找持续热点线程
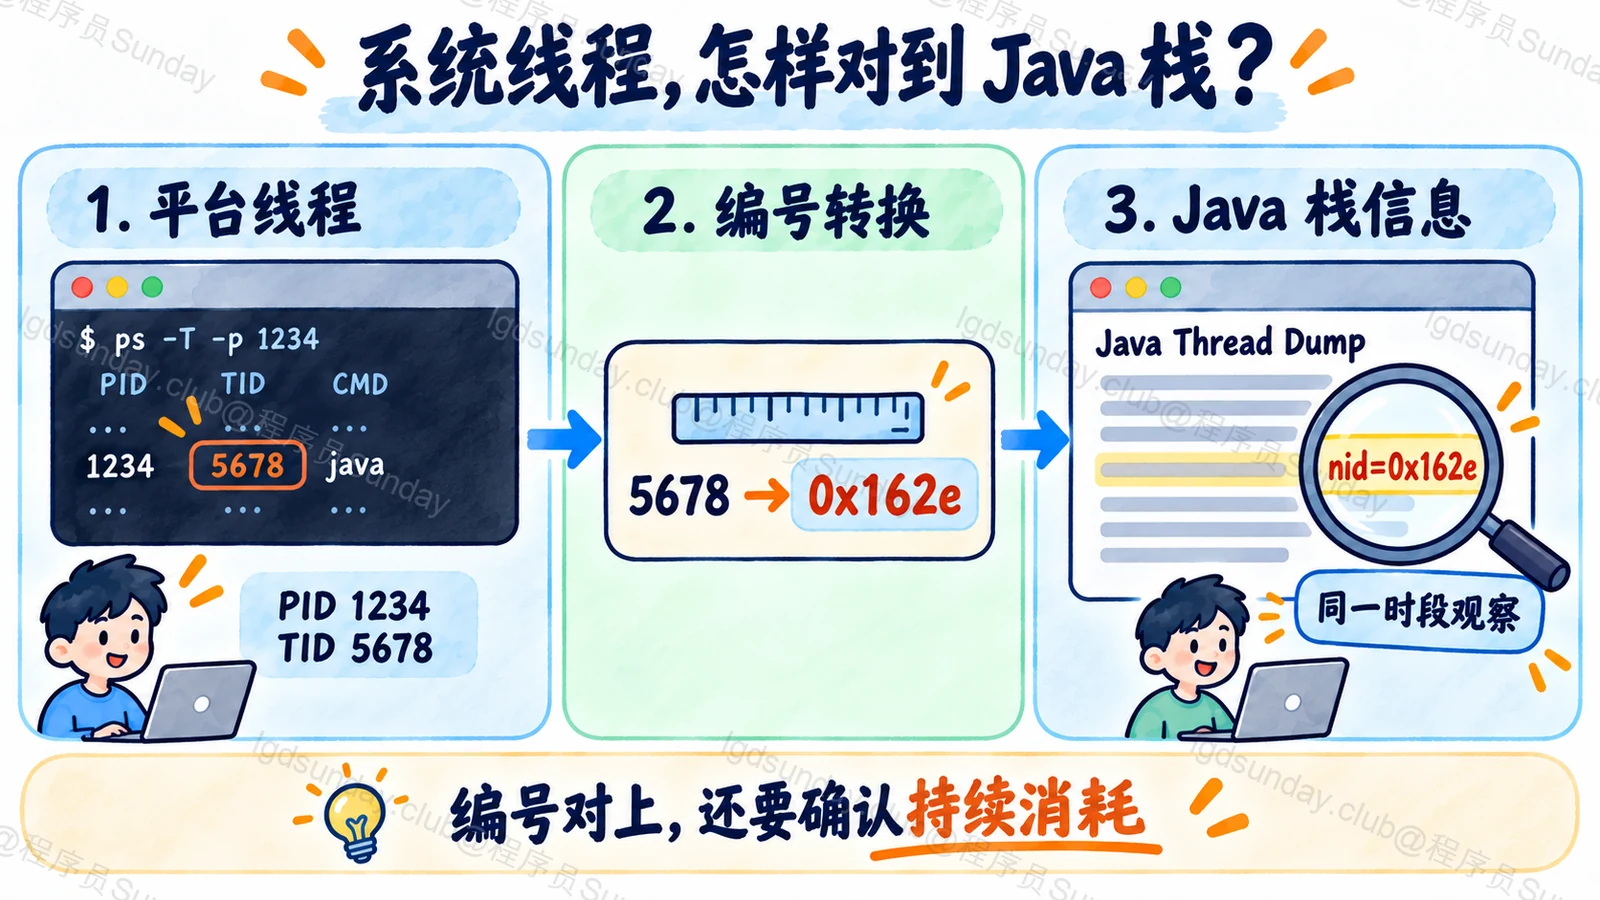
下面讨论 Linux 上的普通平台线程。假设已确认目标 Java 进程 PID 是 1234,某个高 CPU 线程的系统 TID 是 5678。
top -H -p 1234
printf '%x\n' 5678
jcmd 1234 Thread.print -l
5678 对应十六进制 162e,可以在相应线程转储里查找 nid=0x162e。示例编号是假设值,实际操作必须用当时的进程和线程编号。
top 的线程视图帮助找到谁在消耗 CPU;线程栈帮助看到它在采集瞬间执行什么。这是把两个观察对齐,不是把某个线程名字当成永久身份。top 手册和 jcmd 文档分别说明了这些诊断入口。
还要注意容器内外的 PID 命名空间、工具权限和 JDK 环境。jcmd 应针对正确进程执行,不能把宿主机的编号随手套进容器里。
一次栈,只是一张照片
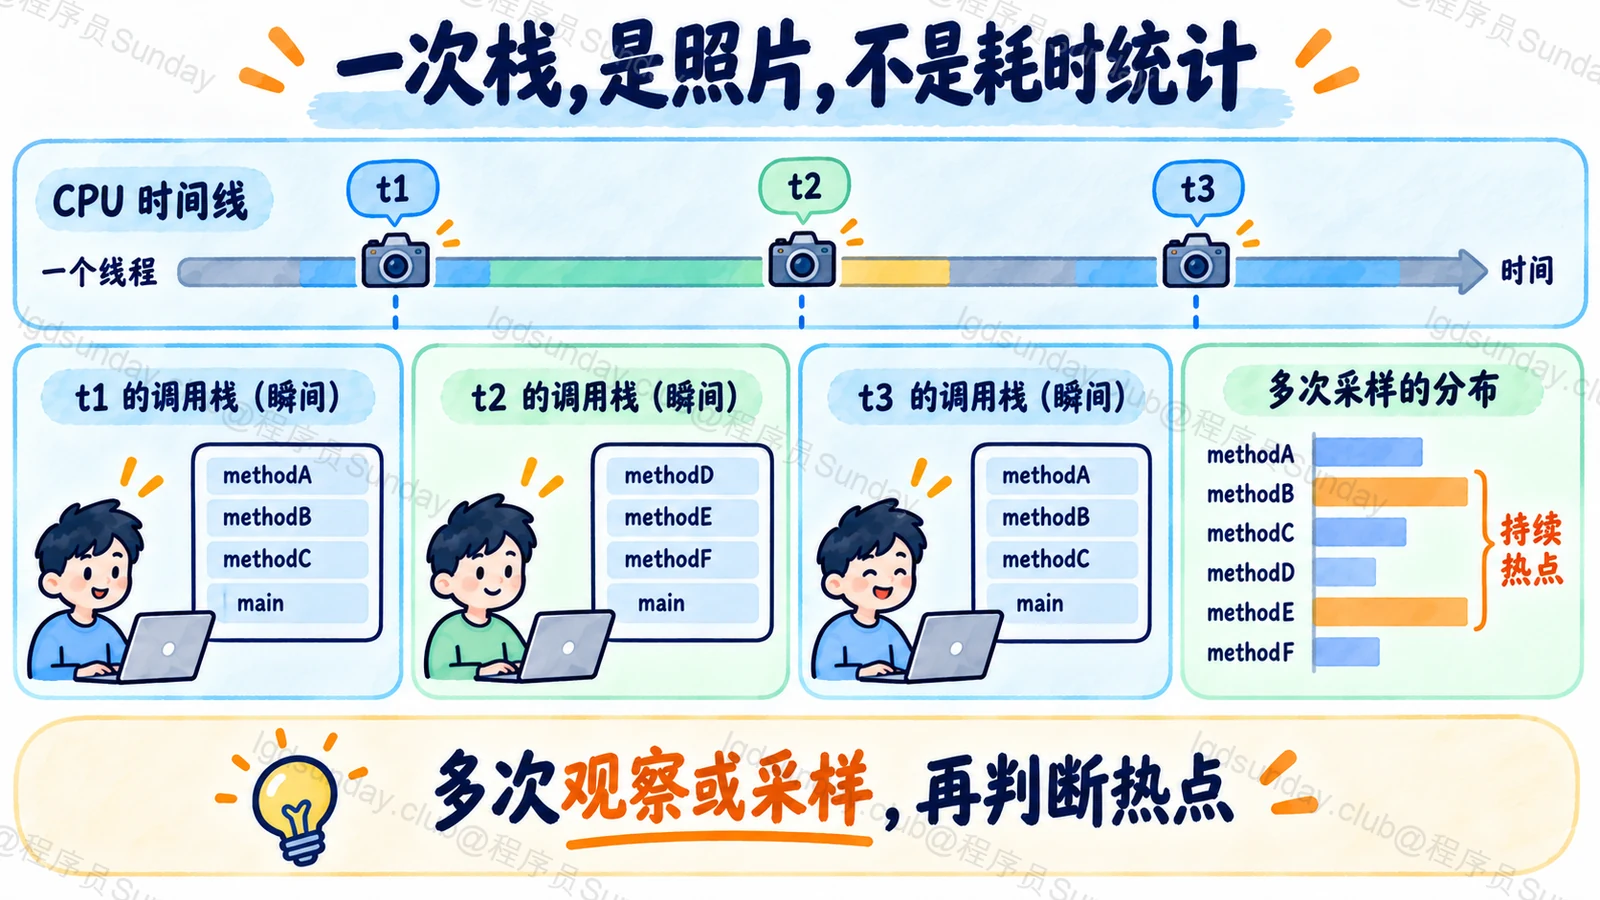
假设第一次抓栈看到 JSON 序列化方法,不能立刻断言它是根因。线程可能恰好刚经过这里,也可能绝大部分时间都在别的地方。
可以隔开短时间取几次转储,同时持续观察线程 CPU。如果同一个高 CPU 线程反复出现在同一段循环里,证据才更具体。要分析时间分布,可以继续使用 JFR 或合适的 CPU 采样分析器。
采样里的一个方法占比高,也要继续看调用路径和输入。它可能在处理异常大的响应,也可能因为上层重试被调用了太多次。找到热点不等于已经找到应该修改的原因。
诊断本身也有开销。不要为了查 CPU,未经判断就执行完整堆转储、强制 GC 等高影响命令;先选择和问题直接相关、影响可控的证据。
看见线程以后,方向可能分开
如果是业务线程持续执行同一循环,检查循环退出条件、重试间隔和输入规模。例如一个失败重试没有退避,可能在短时间内不停计算和请求。
如果主要是 GC 相关线程,要结合 GC 日志、分配速率、堆使用和暂停观察。CPU 高可能来自频繁回收,但不能只看到 GC 名字,就直接加大堆。
如果系统态 CPU 高,继续看系统调用、网络与内核侧工作;如果线程很多、竞争严重,则结合调度和锁的证据判断。等待锁的线程本身不一定在持续消耗 CPU,但自旋与争用可能带来额外成本。
这些分支需要不同证据。把所有情况都归为“线程池配置不好”,很难得到可靠修复。
虚拟线程为什么不能照抄编号法?
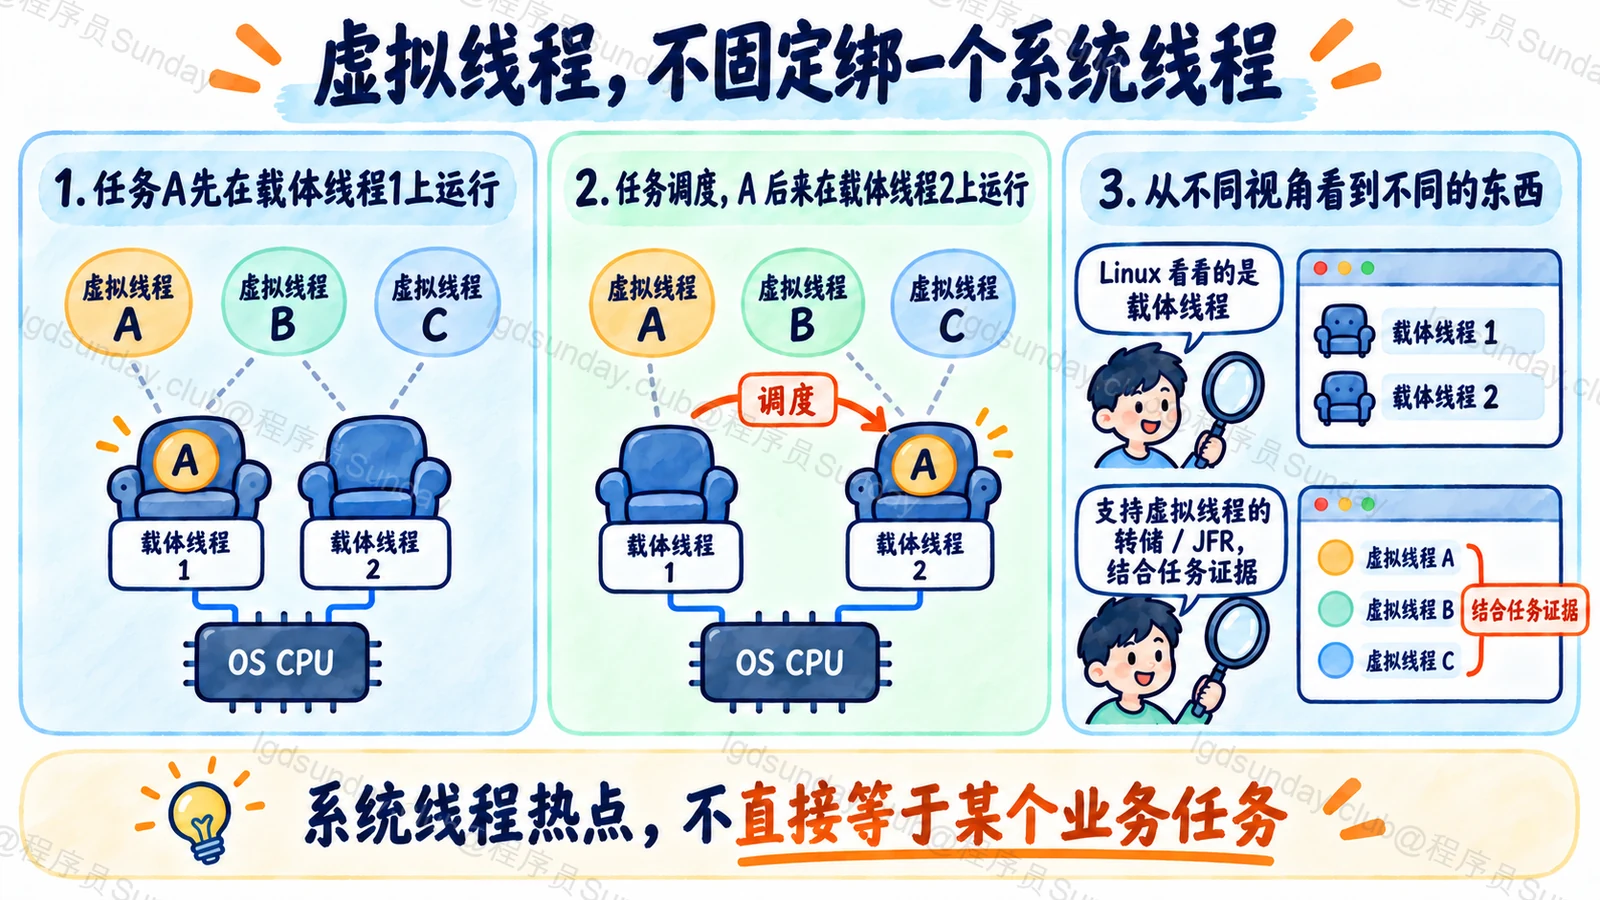
虚拟线程由 JVM 调度到载体线程上执行,不是每个虚拟线程都永久对应一个操作系统线程。
因此,top -H 看到的载体线程热点,不能直接等同于某个固定业务虚拟线程。传统线程转储也不能被当成已经列出全部虚拟线程的任务清单。
使用虚拟线程时,要选择目标 JDK 支持的转储方式,例如 Thread.dump_to_file,并结合 JFR 等证据关联任务。JEP 444说明了虚拟线程与诊断方式的差别。具体命令与分析器支持,还要按实际 JDK 版本检查。
修复以后,要证明什么?
假设找到了无上限重试,增加退出条件和退避后,CPU 降了。这还不够。
需要在可比较的负载下,检查 CPU、请求延迟、错误率、吞吐和任务完成情况。如果 CPU 下降只是因为请求都失败了,或者队列堵住不再处理,也不能称作优化成功。
线上应先按既有流程控制影响、保存证据,再做可回滚的调整。重启可能暂时恢复服务,但不能替代对根因与复发条件的记录。
面试官继续追问
CPU 不高,接口很慢,还用同一条排查路线吗?
部分证据可以复用,但方向要转向等待时间,例如数据库、网络、锁和排队。低 CPU 不代表服务没有瓶颈。
RUNNABLE 状态,就一定正在吃 CPU 吗?
不能只凭状态下结论。线程状态与某段时间的 CPU 使用并不是同一个指标,需要结合实际采样和线程统计。
能不能先重启,再抓证据?
要看故障影响和应急约定。必须尽快恢复时可以止损,但条件允许时应先保留关键证据;重启以后,导致热点的现场可能已经消失。
面试速记卡
- 口径:节点、进程、容器配额与单核百分比先分清。
- 关联:进程 → 持续热点线程 → 同时段调用栈或采样。
- 证据:一次栈不是耗时分布,热点方法也未必是根因。
- 边界:GC、系统态与虚拟线程需要调整诊断方法。
- 验证:相同负载看 CPU、延迟、错误与完成情况,不以重启当根治。
公司面试真题
这道题暂未收录可核验的公司真题来源。你可以先阅读本文解析,或浏览已收录的公司面试真题。
浏览公司面试真题 →