
RabbitMQ 死信队列是什么?失败消息应该重试还是进入死信队列?
下面是一段教学用的模拟面试。
🧑💻 面试官:消息处理失败,你会怎么办?
🙋♂️ 我:重新入队,多试几次。
🧑💻 面试官:如果字段格式永远不合法呢?每次马上重新投递,会不会一直消耗消费者?
🙋♂️ 我:这种消息应该进死信队列。
🧑💻 面试官:死信是直接扔进另一个队列吗?目标队列不可用会怎样?修复以后重新投递,业务会不会执行两次?
重试是在等问题恢复,死信是在隔离当前无法正常处理的消息。隔离以后,还需要可追踪的修复和重放过程。
面试速答(60 秒版)
RabbitMQ 的死信机制,会把满足条件的消息重新发布到配置的死信交换机,再由交换机路由到相应队列。死信交换机和死信队列不是同一个对象。
常见触发包括拒绝且不重新入队、消息 TTL 到期、队列长度限制,以及 quorum queue 的投递次数限制等。
短暂网络故障可以有限重试并退避;格式错误、无法满足的业务条件等永久失败,更适合隔离,不能无限立即重新入队。
死信路由也不自动保证消息不丢或业务恰好执行一次。需要核对队列类型和转发保证,监控死信积压,并让恢复重放继续遵守幂等和业务状态约束。
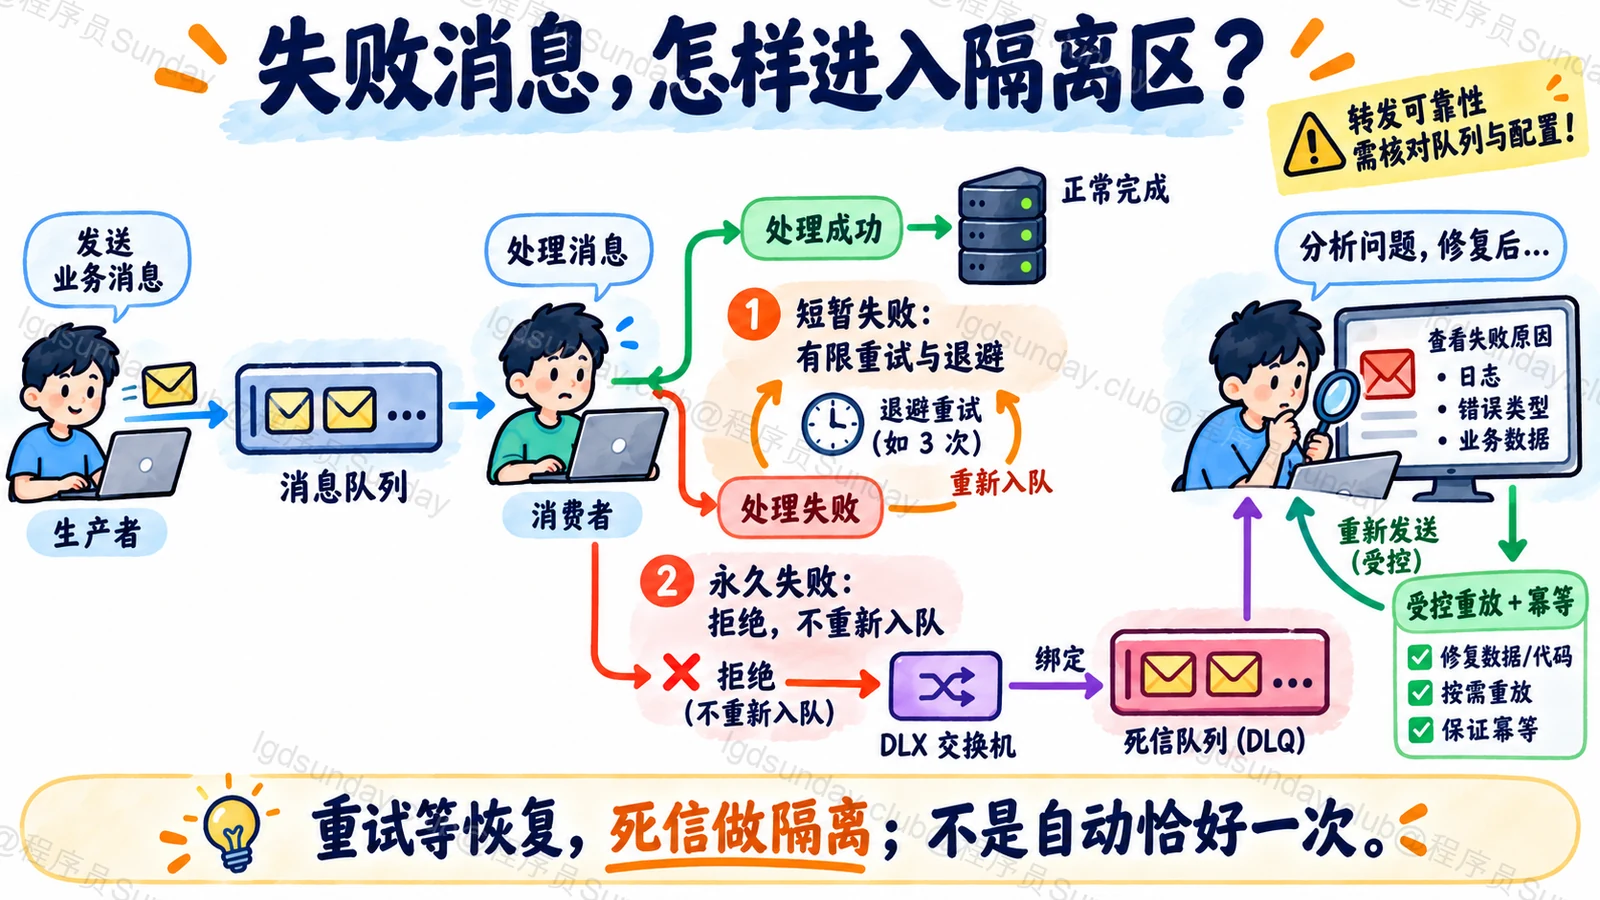
知识点详解:从失败到隔离,中间还有一次消息路由
消费失败不一定马上成为死信
消费者使用 reject 或 nack 时,如果选择重新入队,消息可能再次进入原来的消费流程,并不等于进入死信交换机。
拒绝且不重新入队,才是常见的死信触发之一。能否进入目标队列,还要看原队列是否配置了 DLX、交换机和绑定是否存在,以及路由键怎样设置。
过期、长度限制等也可能触发死信,但整个队列过期删除,并不意味着其中的消息都会被转成死信。具体规则应按 RabbitMQ DLX 文档核对。
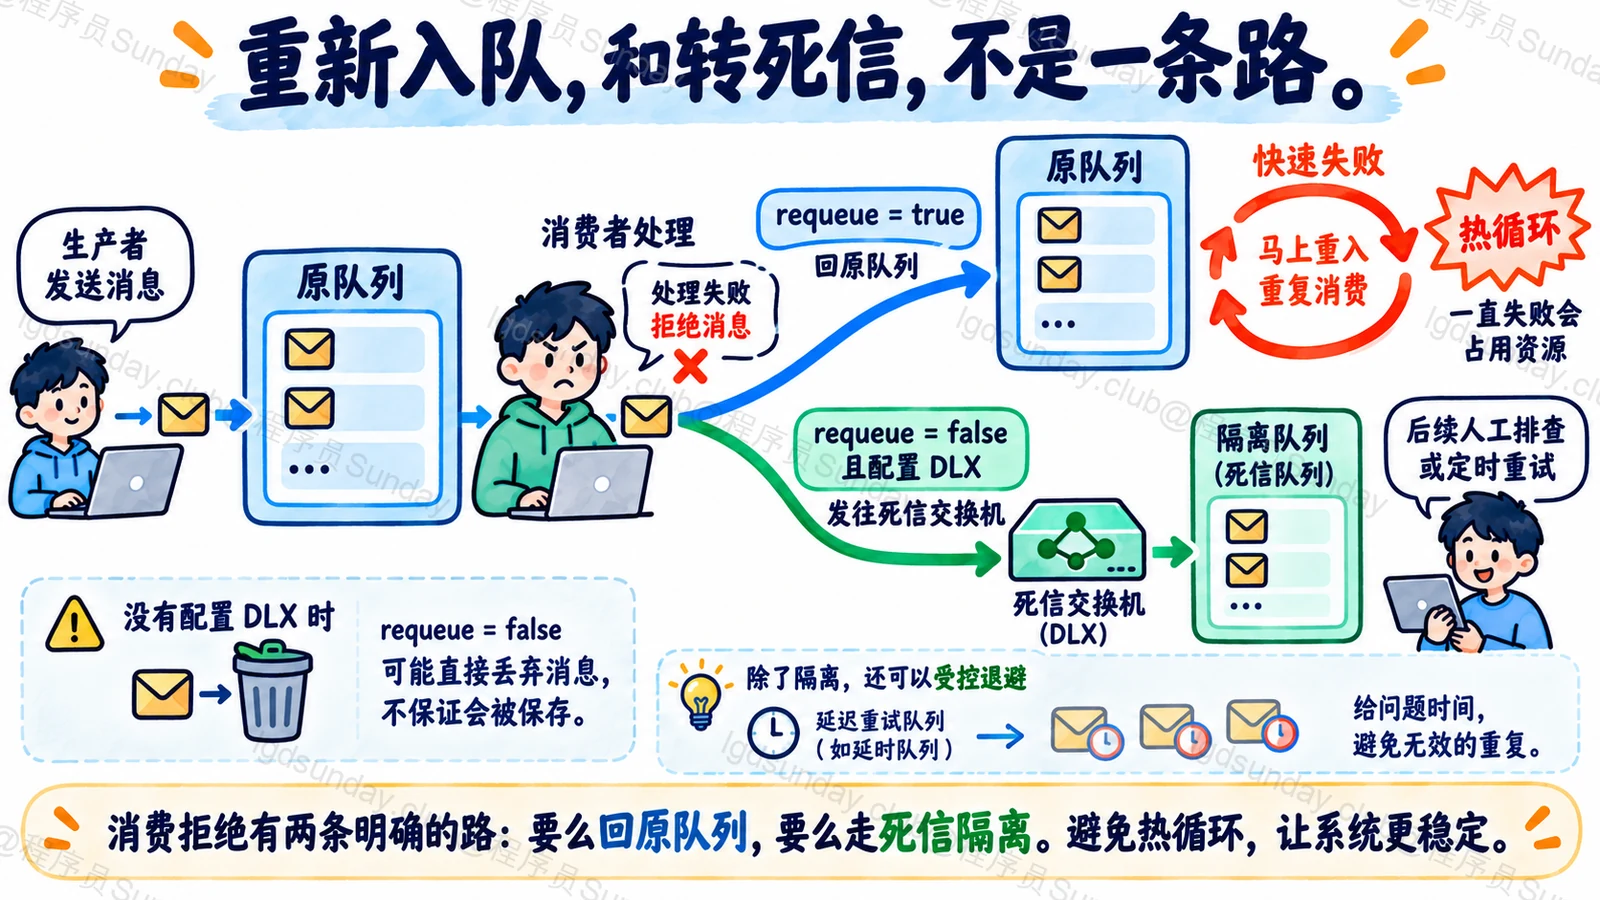
为什么要区分临时失败和永久失败?
假设消费任务需要访问另一个服务。对方短暂超时,退避一会儿可能恢复;但消息缺少必填字段,再试一百次也不会自己补齐。
无限立即重新入队,会让同一批坏消息反复抢占消费能力。其他正常消息也可能被拖慢,日志和请求量却看起来很忙。
因此重试要有上限和间隔,还要记录失败原因。超过预算后进入隔离流程,业务无法继续的消息也应明确标记,而不是默认丢掉。
TTL 和死信交换机可以参与某些延迟重试拓扑,但 DLX 本身不是自动重试调度器。不同方案的到期、路由和可靠性条件需要分别检查。
死信队列为什么不是保险箱?
死信转发相当于一次重新发布。RabbitMQ 的默认死信转发并非在所有集群故障下都保证安全,目标不可接收时可能丢失消息。
Quorum queue 提供有相应配置条件的至少一次死信转发能力,也需要核对队列、策略和目标条件。不能只看“配置了 DLX”,就承诺所有消息都会可靠地到达隔离队列。
至少一次同样意味着可能重复,不等于业务恰好执行一次。消费者的提交、确认和幂等仍然重要。RabbitMQ 可靠性说明
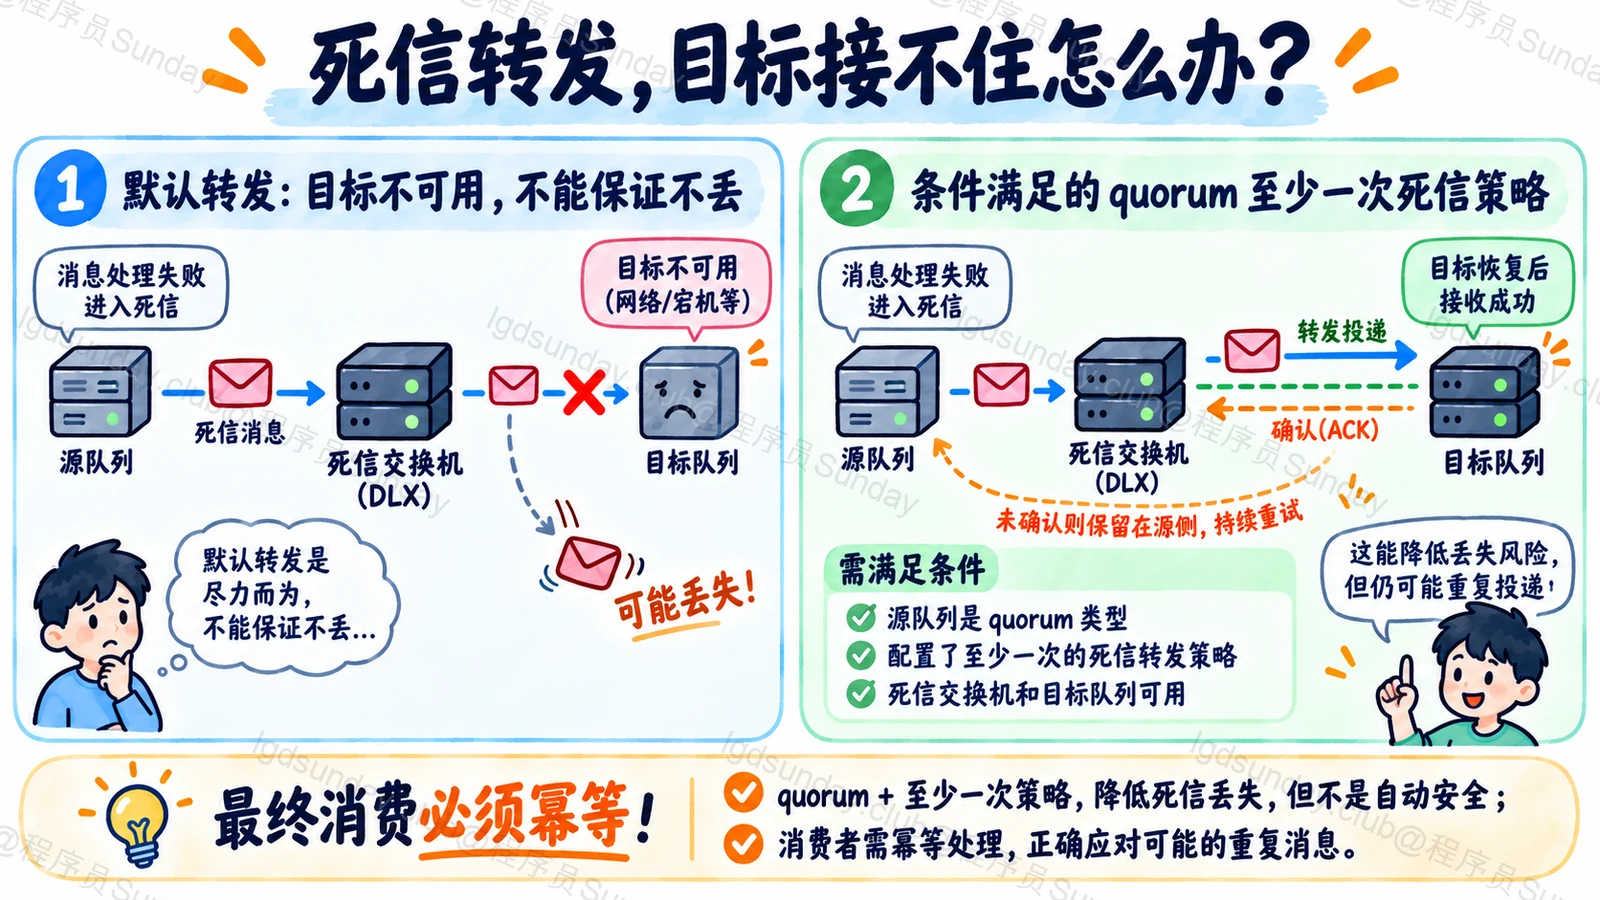
图中的确认指重发布目标的接收确认,不是消费者业务处理成功的 ACK。启用条件不止图中这些提示,需要按所用 RabbitMQ 版本核对完整配置。
修复以后,不能直接一键全部重放
假设失败原因是服务配置错误,修复后可以按批次恢复。但如果消息太旧,相关业务对象已经取消,原动作未必还应该执行。
重放前应检查失败原因、原始消息身份、当前业务状态和幂等记录。重放过程还要受限速、权限和审计控制,避免把积压瞬间压回生产消费者。
x-death 等头可以帮助了解死信经过,但它们不是“业务总共尝试了几次”的万能计数器。不同路由、拒绝和应用重试会影响记录含义。
怎么判断隔离方案真正有效?
检查坏消息是否停止占用正常消费、死信是否能被发现、失败原因是否可读,以及修复后能否安全恢复。
还要测试目标队列不可用、消费者提交后未确认、重放再次失败等情况。正常路径能进死信队列,只证明路由配置在那次测试中工作,不证明整个故障恢复链路可靠。
面试官继续追问
死信队列是不是垃圾桶?
不是。它保存需要进一步判断和恢复的失败消息,也可能有保留期限和容量限制,必须有人或流程负责处理。
消息进了死信队列,生产者就知道业务失败吗?
未必。生产者发送确认和消费者业务处理结果是不同阶段,业务回执需要额外设计。
自动重试和人工重放能共用消费者吗?
可以,但要保留消息身份、失败上下文和当前业务约束,不能因为是人工操作就绕过幂等。
面试速记卡
- 死信流程:原队列触发条件 → DLX → 绑定的目标队列。
- 临时失败:有限重试与退避。
- 永久失败:隔离、记录原因、修复后再判断重放。
- 可靠性:DLX 配置不等于任何故障下都不丢。
- 恢复要求:幂等、状态校验、限速与可追踪记录。
公司面试真题
这道题暂未收录可核验的公司真题来源。你可以先阅读本文解析,或浏览已收录的公司面试真题。
浏览公司面试真题 →