
消息队列积压怎么排查?加消费者为什么不一定有用?
🧑💻 面试官:消息积压了,你会怎么处理?
🙋♂️ 我:先增加消费者,尽快把积压清掉。
🧑💻 面试官:队列只分了四个分区,你启动二十个消费者会快多少?
🙋♂️ 我:那就再增加分区。
🧑💻 面试官:如果慢的是数据库,而且已经被打满,扩容消费者会不会让它更慢?
清积压要看「净消化能力」:完成速度不仅要追上新增速度,还要有余量偿还过去的欠账。
面试速答(60 秒版)
先确认积压发生在哪个消费组、分区或队列,看消息数量、最旧消息年龄以及增长趋势。再区分是生产突然增加、消费者变慢、失败重试,还是某个热点通道拖住。
扩容前要找瓶颈。分区并行度不够、同组顺序限制或下游已满时,单纯增加消费者没有用,甚至会制造更多重试。
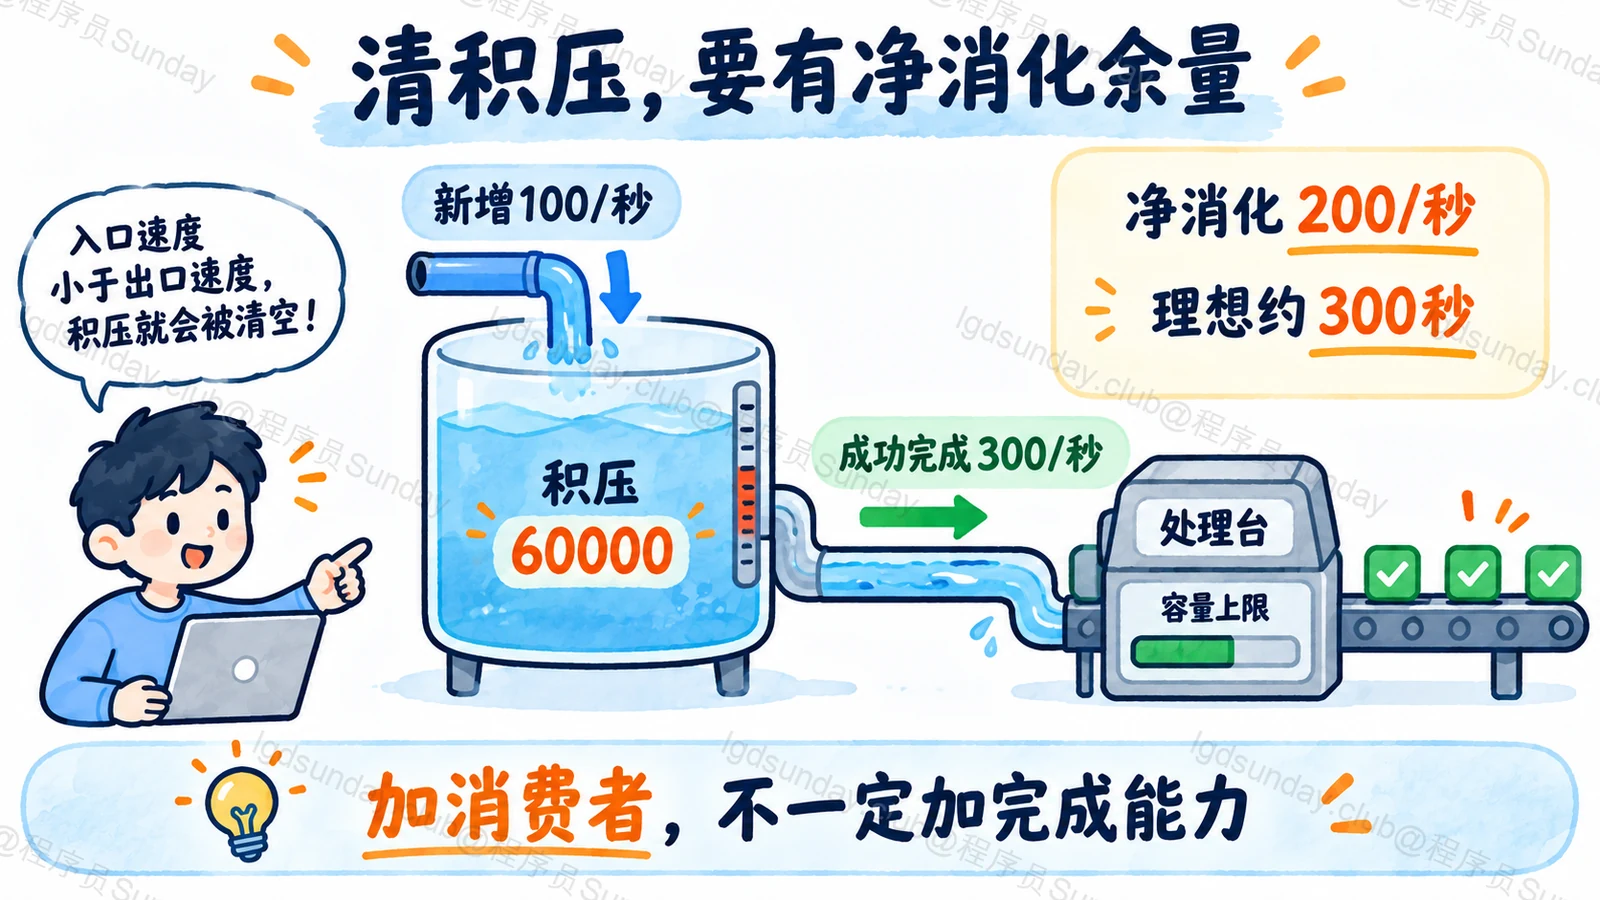
恢复时,成功处理速率要高于持续生产速率。假设积压 6 万条,每秒新增 100、成功完成 300,理想净消化是每秒 200,约需 300 秒;如果只能完成 100,就永远清不完。
实际还要保住顺序、幂等与保留期限,限住下游压力,并验证积压确实转成正确的业务结果,而不是靠跳过消息让数字好看。
知识点详解:先定位慢在哪,再安排可持续的追赶
数量和时间要一起看
假设积压有一万条。如果每条只是轻量通知,可能很快清掉;如果每条要生成大报表,含义就完全不同。数量不说明剩余工作量。
再看最旧消息年龄与分区分布:所有通道一起增长,更像整体能力不足;只有一条不断变旧,可能是热点、毒消息或顺序阻塞。
Kafka 的 lag 与提交位置有关,不一定直接等于已经完成的业务工作;RabbitMQ 中 ready 与 unacked 也要分开看。消息被拿走但长期没完成,不能当作积压已经消失。
顺着一次消费拆开耗时
把拉取、反序列化、业务计算、数据库、外部请求和确认的时间拆开。再看 CPU、连接池等待、错误与重试,判断慢在哪一段。
如果下游响应变慢,更多消费者可能增加连接竞争。如果某条消息每次失败立即重试,可能把资源耗在同一个坏输入上。若一个顺序组被卡住,其他组即使扩容也替不了它。
这里不要先调一堆并发参数。先拿到耗时和失败证据,才知道是优化处理、限制重试、隔离热点,还是增加资源。
算追赶时间,也算下游能不能承受
积压变化约等于新增速度减去成功完成速度。只有后者更大,才会下降。估算追赶时间时,使用净消化速率,不是直接拿积压除以总消费速率。
前面的 6 万条、100 新增、300 完成,是假设稳定速率下的示意。真实任务长短不同、重试和资源变化都会影响结果,不能把这个估算当作承诺。
扩容后还要逐步观察下游延迟和错误。如果清积压把数据库打垮,新增任务也会失败,最终净能力可能反而下降。
恢复不是清空数字,而是完成任务
先确认数据保留期限与最旧任务期限,避免消息追赶前已经被清理。过期任务是否继续做、是否允许跳过,要有业务规则和可追溯记录。
不要直接重置进度到最新位置来「解决积压」。这会跳过待处理工作,除非业务明确接受且安排补偿。修复后还要核对输出数量、重复副作用与失败隔离。
最终把告警放到最旧年龄、增长趋势与预计恢复时间上,比只盯一个消息条数更接近用户真正感受到的延迟。
本题机制参考:Kafka Monitoring、RabbitMQ Confirms、RocketMQ Ordered Message。
面试官继续追问
增加消费者为什么可能没有提升?
可能没有更多可分配通道,任务要求串行,或者瓶颈在下游。要看实际并行工作与成功完成量。
lag 降到零就验收通过了吗?
不一定。进度可能提前提交,任务可能被跳过。还要核对正确输出与失败残留。
什么时候暂停生产?
当输入超过恢复能力且不能允许继续恶化时,可以按业务策略限流或暂缓。但必须明确调用方响应、持久化和恢复方式。
面试速记卡
- 看数量、最旧年龄、趋势和通道分布。
- 区分生产增加、处理变慢、重试与热点。
- 净消化 = 成功完成速率 − 新增速率。
- 扩容先查分区、顺序和下游瓶颈。
- 恢复验收看正确业务结果,不只看进度。
公司面试真题
这道题暂未收录可核验的公司真题来源。你可以先阅读本文解析,或浏览已收录的公司面试真题。
浏览公司面试真题 →