
延迟队列怎么实现?定时扫描、时间轮和延迟消息怎么选?
🧑💻 面试官:延迟队列是不是设个定时器,到点执行就行?
🙋♂️ 我:任务少的时候可以,大一点就用时间轮或延迟消息。
🧑💻 面试官:进程重启以后,定时器里的任务还在吗?
🙋♂️ 我:那需要把任务保存下来。
🧑💻 面试官:到期事件发出时,用户刚好已经完成操作,你还会直接执行取消吗?
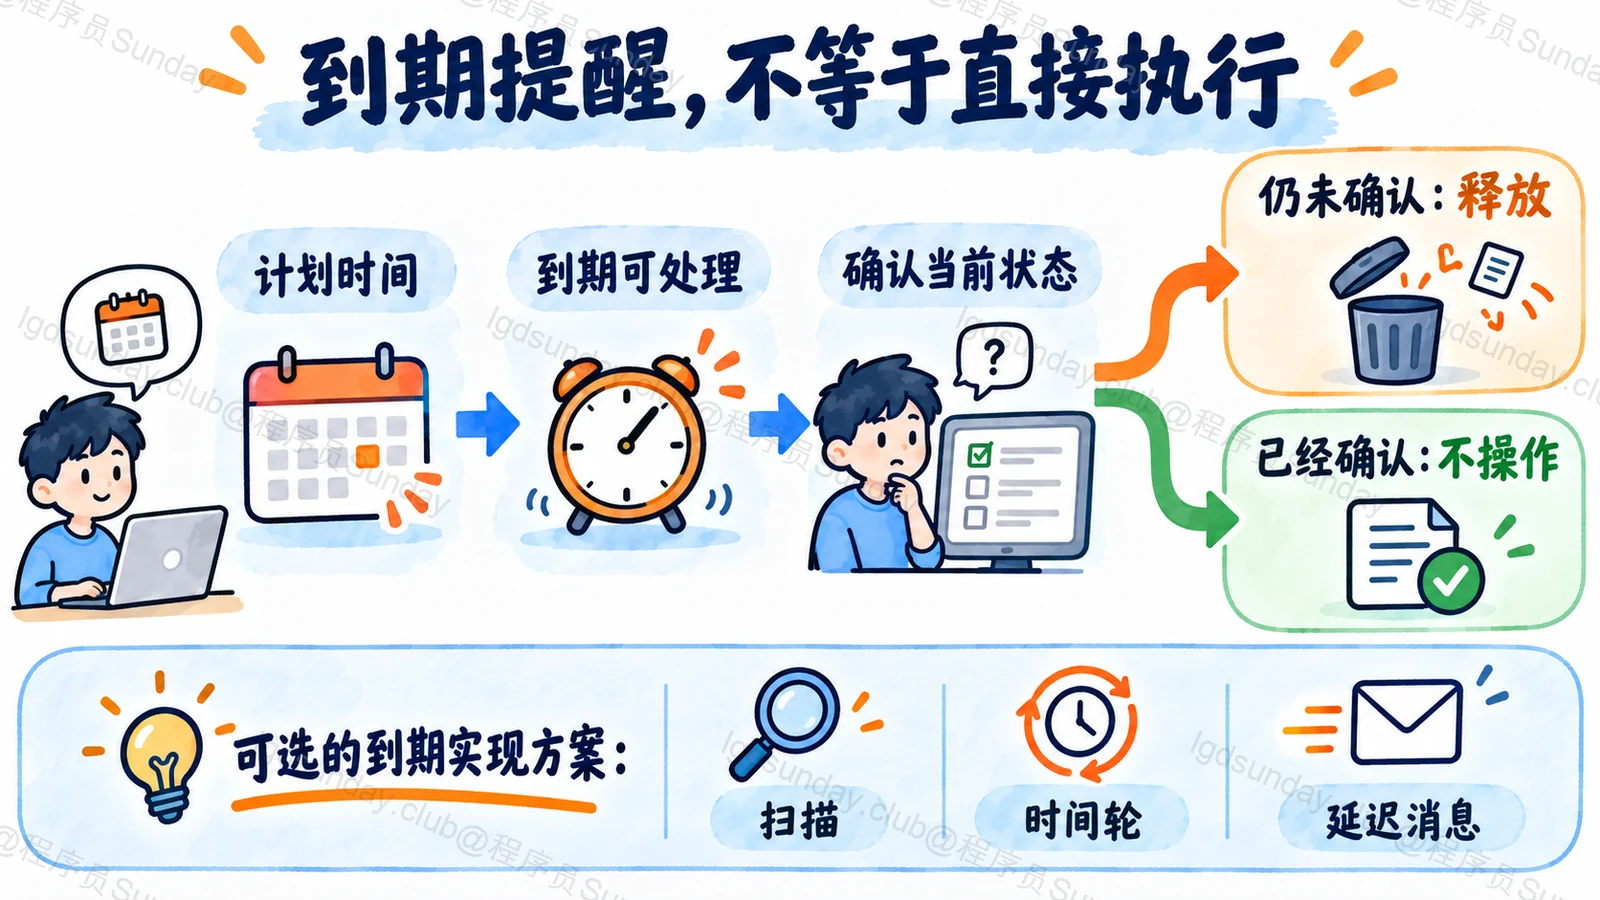
延迟队列负责「到期提醒」,业务负责「此刻还能不能做」。持久化与执行条件不能省略。
面试速答(60 秒版)
延迟队列让任务在指定时间以后变成可处理,常见方案有数据库定时扫描、内存时间轮和中间件延迟消息。
扫描易于结合持久化与查询,代价是周期和扫描负载;时间轮按时间槽组织大量定时任务,适合近似调度,但内存定时器本身不解决重启恢复;延迟消息把等待交给中间件,但要核对版本、精度、最长延迟和故障语义。
到期不等于业务一定马上完成,也不等于一定只执行一次。消费者还要检查当前状态,以幂等或条件更新处理重复与竞争,并监控到期后的实际等待时间。任务取消、改期和大量任务同时到期,也要提前设计。
知识点详解:到期、可消费和业务完成不是同一时刻
先把时间触发与业务决定拆开
假设一个预约需要在 15 分钟未确认后释放名额。延迟任务可以携带预约 ID,在到期后提醒处理程序检查。
但用户可能在第 14 分 59 秒完成确认;处理程序也可能因为积压到第 16 分钟才运行。因此不能收到事件就无条件释放。应读取当前状态,通过受保护的条件修改决定是否仍需处理。
重复事件也应得到同样的安全结果。延迟队列提供时机,不负责证明这个时刻的业务条件。
扫描、时间轮和延迟消息怎么选
数据库扫描可以用到期时间和状态建立合适索引,按批获取已到期任务。多实例需要明确认领或锁定,失败后能恢复,不能每个实例都对整表重复执行。
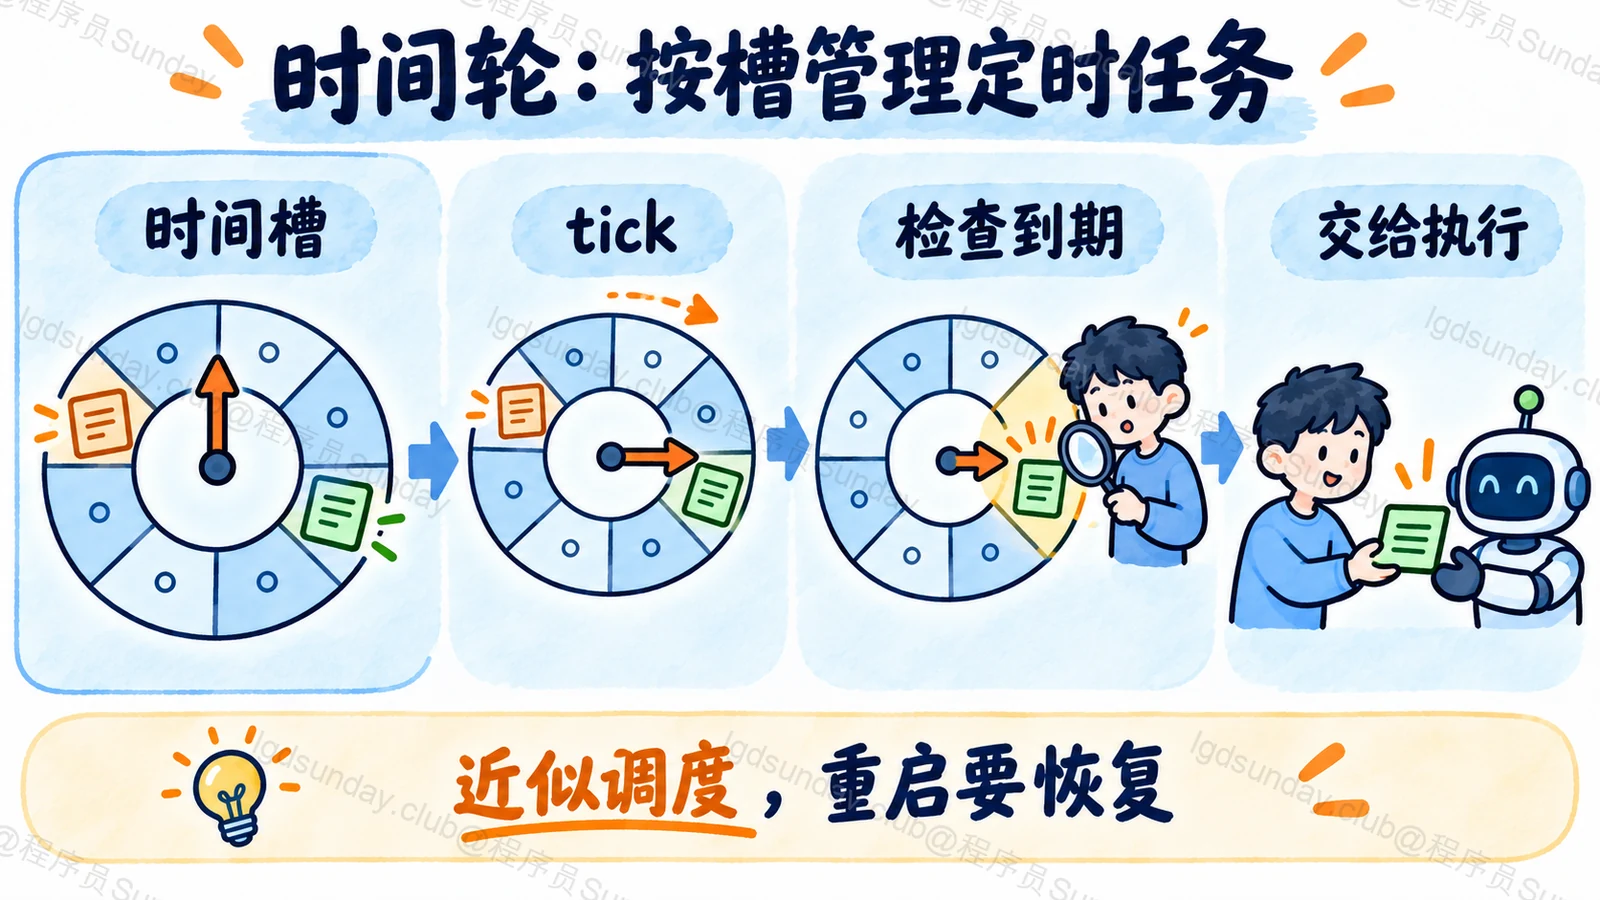
时间轮把任务按时间槽分组,指针随 tick 移动,到槽后检查。它用精度与组织方式换取大量定时任务的管理效率,但执行可能晚于计划时间,长耗时处理也不应堵住调度线程。
中间件延迟消息由 Broker 管等待,应用在可见后消费。它的时间范围、配置与消息类型依赖产品版本。不能把某个版本的固定延迟等级推广到所有 RocketMQ 版本。
TTL 加死信,不是万能精确定时
RabbitMQ 可以通过消息 TTL 和死信路由组合出延迟处理模式,但逐消息 TTL 会受到队头处理等边界影响。短 TTL 消息放在未到期长消息后面,不一定按它自己的到期时间立即进入死信路径。
因此混合延迟时,要检查所选队列类型与过期行为,而不是把 expiration 当作通用定时调度器。死信转发的可靠性也应按实际配置验证。
对精度较宽松、时间桶固定的任务,可以评估相应设计;需要更精细调度时,选择契合的方案,不靠缩短一个数字宣称解决。
重启、改期和集中到期怎样收场
任务要有稳定 ID、计划时间、当前版本和处理状态。改期后,旧事件仍可能到达,可以根据版本或状态识别并忽略,而不必假设旧消息已经物理撤回。
内存时间轮需要持久化来源与重建策略。多节点负责调度时,要设计认领、租约或分片,避免全部节点重复恢复相同任务。
最后监控从计划时间到可见、到开始、到完成的延迟。假设十万任务都定在整点,Broker 和业务端也需要逐个处理;调度不是一条绝对准时的魔法承诺。
本题机制参考:Netty HashedWheelTimer、RocketMQ Delay Message、RabbitMQ TTL、RabbitMQ Dead Letter Exchanges。
面试官继续追问
延迟消息能保证毫秒级业务完成吗?
不能。可见时间、网络、消费积压与处理耗时都会影响结果,精度必须按实际产品与负载验证。
取消任务必须删除延迟消息吗?
不一定。可将业务状态或任务版本标记为已取消,消费时验证后无操作;是否提供消息撤回能力则按实际版本核对。
时间轮任务不会丢吗?
内存结构本身不提供持久性。需保存任务并安排重启重建与重复处理防护。
面试速记卡
- 到期提醒,不等于当前业务条件成立。
- 扫描重持久化认领;时间轮重近似调度;延迟消息看产品限制。
- TTL+死信需检查队头与转发行为。
- 重复、取消、改期用状态或版本保护。
- 分别测可见、开始与完成时间。
公司面试真题
这道题暂未收录可核验的公司真题来源。你可以先阅读本文解析,或浏览已收录的公司面试真题。
浏览公司面试真题 →