
前端异常监控怎么做?运行时错误、资源加载失败和 Promise 异常怎样捕获?
以下对话为教学模拟,不是真实面经。
🧑💻 面试官:前端异常监控,监听 window.onerror 就够了吗?
🙋♂️ 我:它能捕获页面错误,应该可以收集大部分问题。
🧑💻 面试官:图片加载失败呢?没有处理的 Promise 拒绝呢?订单接口返回业务失败算不算 JavaScript 异常?
先把失败类型分开,再为每一种选择合适的收集入口。
面试速答(60 秒版)
前端异常不能只依赖一个监听器。脚本运行时错误可以通过 error 事件收集;资源加载失败也会产生相关事件,但需要注意捕获阶段和事件对象差异;未处理的 Promise 拒绝要监听 unhandledrejection。
接口失败和业务失败又是另一类,应在请求层或业务层按协议记录,不一定表现为 JavaScript 异常。
收集后还要保留版本、页面、时间和必要的上下文,使用对应 Source Map 还原堆栈,并做去重、限流和敏感信息过滤。
监控的目标不是收集越多越好,而是知道哪个版本、哪种用户操作出了什么问题,同时避免上报逻辑自己影响页面。
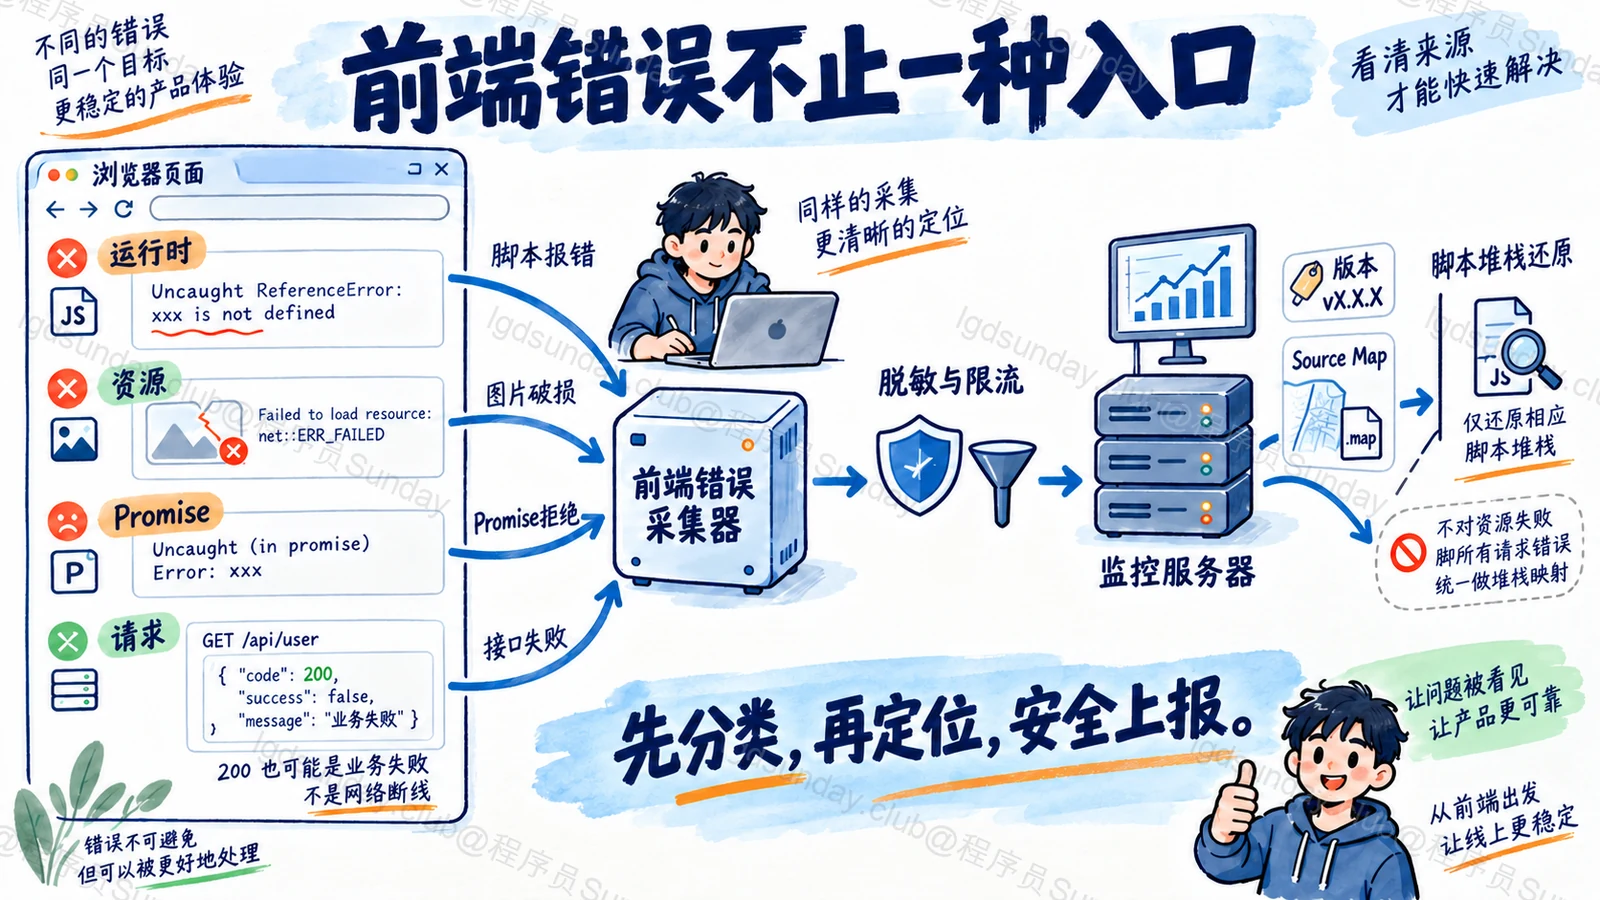
知识点详解:从异常发生,到能够定位原因
error 事件里,可能是两种不同对象
脚本抛出未处理错误时,Window 的 error 事件通常能够带回错误信息和位置。MDN 的 error 说明介绍了监听方式和对象字段。
资源加载失败也会触发相关 error 事件,但这类事件不会像普通脚本错误一样提供完整堆栈,事件目标可能是图片、脚本等资源元素,而且需要考虑捕获阶段。
因此,不能给所有 error 事件都直接读取相同字段。可以先检查事件类型和 target,再分类记录。
TypeScript:浏览器入口的最小示意
window.addEventListener("error", event => {
  if (event instanceof ErrorEvent) {
    console.log("runtime", event.message, event.error?.stack);
  } else {
    console.log("resource", (event.target as Element)?.tagName);
  }
}, true);

window.addEventListener("unhandledrejection", event => {
  console.log("promise", String(event.reason));
});
这是分类示意,不是完整监控 SDK。真实项目应处理序列化、隐私和跨域限制,也不能假设所有浏览器环境都返回同样完整的错误字段。
Promise 拒绝,不等于同步抛错
异步任务失败以后,如果没有相应处理,可能触发 unhandledrejection。reason 也不一定是 Error 对象,可能是字符串或其他值。MDN 的相关文档说明了事件语义和安全限制。
但是,已经被业务代码处理的拒绝,不会自动代表一个未处理异常。接口返回“库存不足”,页面已经展示提示,是否上报应依据监控目标,而不是每次都当作程序崩溃。
Python 没有浏览器的 window 事件。下面只展示监控服务接收端的输入校验,不能冒充上述监听器的 Python 版本。
Python:接收字段的最小校验
def validate_event(payload):
    allowed = {"runtime", "resource", "promise", "request"}
    if payload.get("kind") not in allowed:
        raise ValueError("unknown error kind")
    message = str(payload.get("message", ""))[:1000]
    return {"kind": payload["kind"], "message": message}
接收端仍需要鉴权、大小限制和字段白名单。这里的字符串截断不是完整的敏感信息过滤方案。
只有错误文字,通常还不够定位
咱们假设线上日志只写着“读取 undefined 失败”。没有版本、堆栈和触发页面,很难知道是哪次发布引入的。
构建压缩以后,堆栈中的位置还需要对应版本的 Source Map 才能还原。不能拿最新构建的映射去解释旧版本错误;同一文件名也可能包含不同内容。
可以记录应用版本、资源标识、错误类型、时间以及少量必要操作线索。操作线索应是安全摘要,不是完整输入框内容、Token 或订单详情。日志越丰富,越需要明确数据边界和访问权限。
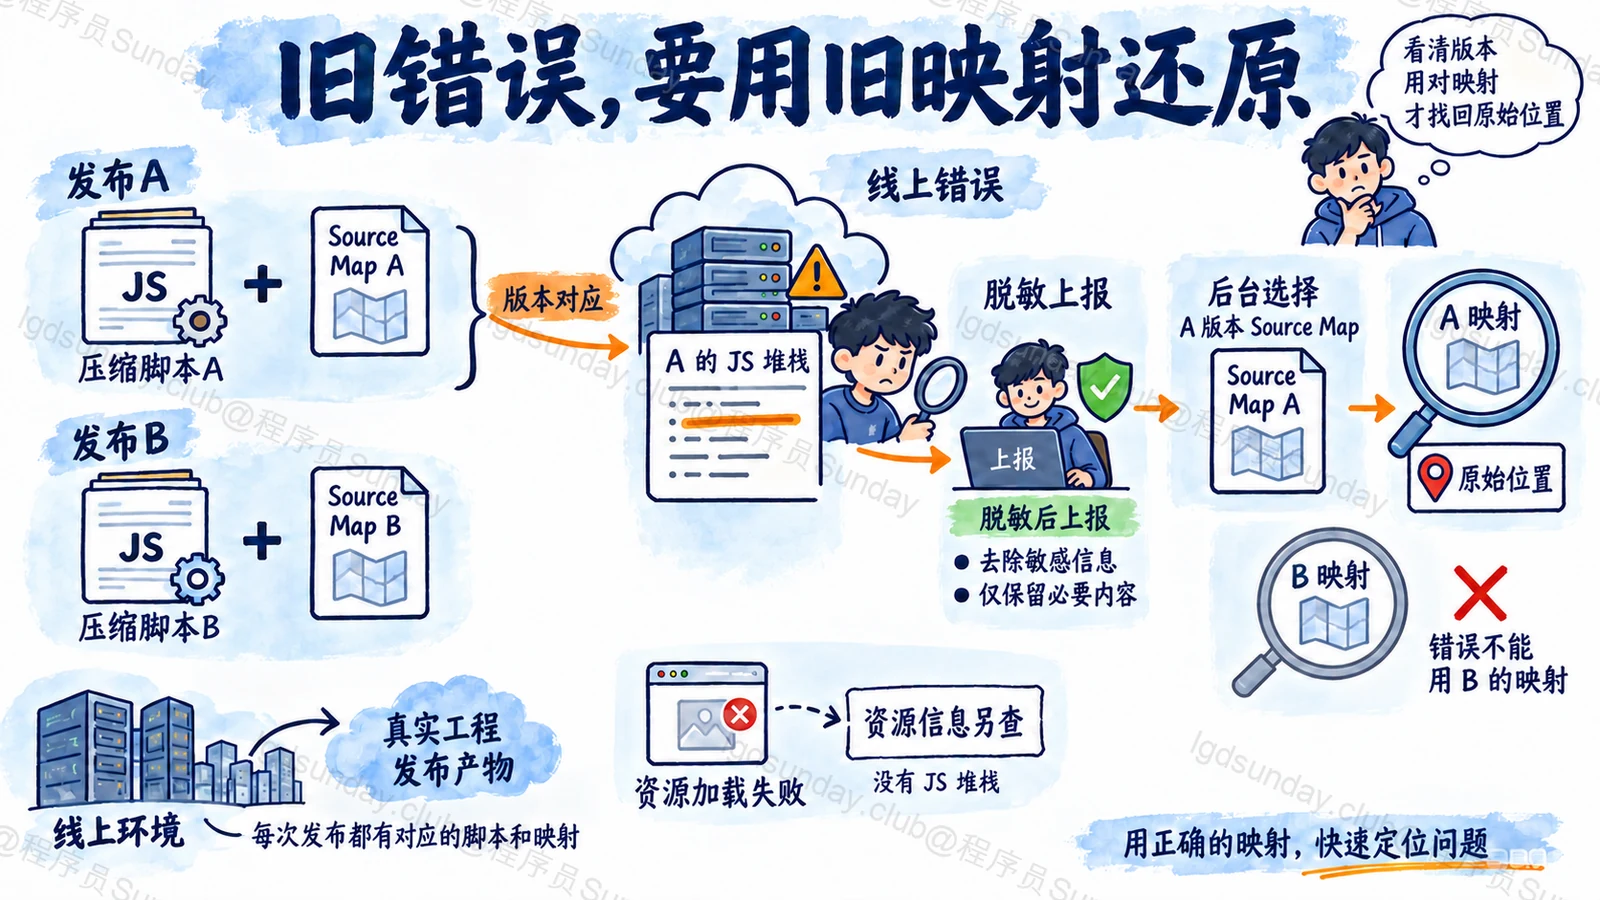
上报链路也会失败,要避免扩大故障
如果网络已经不稳定,监控上报可能同样失败。无限重试会增加请求和内存,错误处理中再抛错还可能造成递归上报。
因此,需要限制队列大小、采样、去重和重试次数,并对监控自身的错误做好隔离。同一异常在短时间重复出现,可以聚合次数,而不是每次发送完整堆栈。
最后用受控故障验证覆盖:同步抛错、资源失败、未处理拒绝、接口状态异常,以及已经被业务正确处理的失败。检查分类、版本关联、隐私处理和上报失败时的行为。只确认控制台出现消息,还不能算监控方案验收。
面试官继续追问
跨域脚本一定能得到完整堆栈吗?
不一定。脚本加载配置、响应头和浏览器安全限制都会影响信息,需要按部署方式配置并验证。
应不应该在事件里阻止默认行为?
不能为了减少控制台信息就默认阻止。是否阻止应结合具体事件语义与产品要求;监控最好不要无意改变应用错误处理。
每个业务失败都上报报警吗?
不应如此。预期内的校验失败、用户取消,与系统故障的优先级不同。应该分类统计,避免正常行为淹没真正的问题。
面试速记卡
- 收集入口:运行时、资源、Promise 和请求分别考虑。
- 对象差异:资源 error 不等于带堆栈的 ErrorEvent。
- 定位信息:版本、位置与匹配的 Source Map。
- 数据边界:过滤敏感字段,不上传完整用户内容。
- 稳定性:上报要去重、限流,并隔离自身故障。
公司面试真题
这道题暂未收录可核验的公司真题来源。你可以先阅读本文解析,或浏览已收录的公司面试真题。
浏览公司面试真题 →