
前端代码分割和懒加载怎么做?拆包越细越好吗?
🧑💻 面试官:代码分割和懒加载有什么区别?
🙋♂️ 我:都是把页面代码拆开,首页就更快。
🧑💻 面试官:拆成十个文件后,首页马上请求这十个文件,算懒加载吗?
🙋♂️ 我:那还要等需要时才加载。
🧑💻 面试官:如果点击后才一层层发现依赖,用户等待时间是不是可能更长?
分割决定代码装在哪个包里,懒加载决定什么时候拿这个包;拆小了,不代表等待就一定减少。
面试速答(60 秒版)
代码分割把代码组织成多个 chunk;懒加载则把部分资源的加载推迟到需要时。代码拆开后,也可能立刻全部加载,所以两者不是同一个概念。
常见方式是在路由或较重功能处使用动态 import。它能减少首次需要的代码,但也会给后续操作增加网络和执行等待。
选分割边界时,我会看用户路径、共享依赖、资源缓存和请求瀑布。使用频繁或马上要展示的内容,不一定适合再延迟一层。
还要准备加载状态、失败恢复和发布兼容。旧页面引用的 chunk 被新发布删除时,动态加载可能失败,不能把错误一律当成网络不稳定。
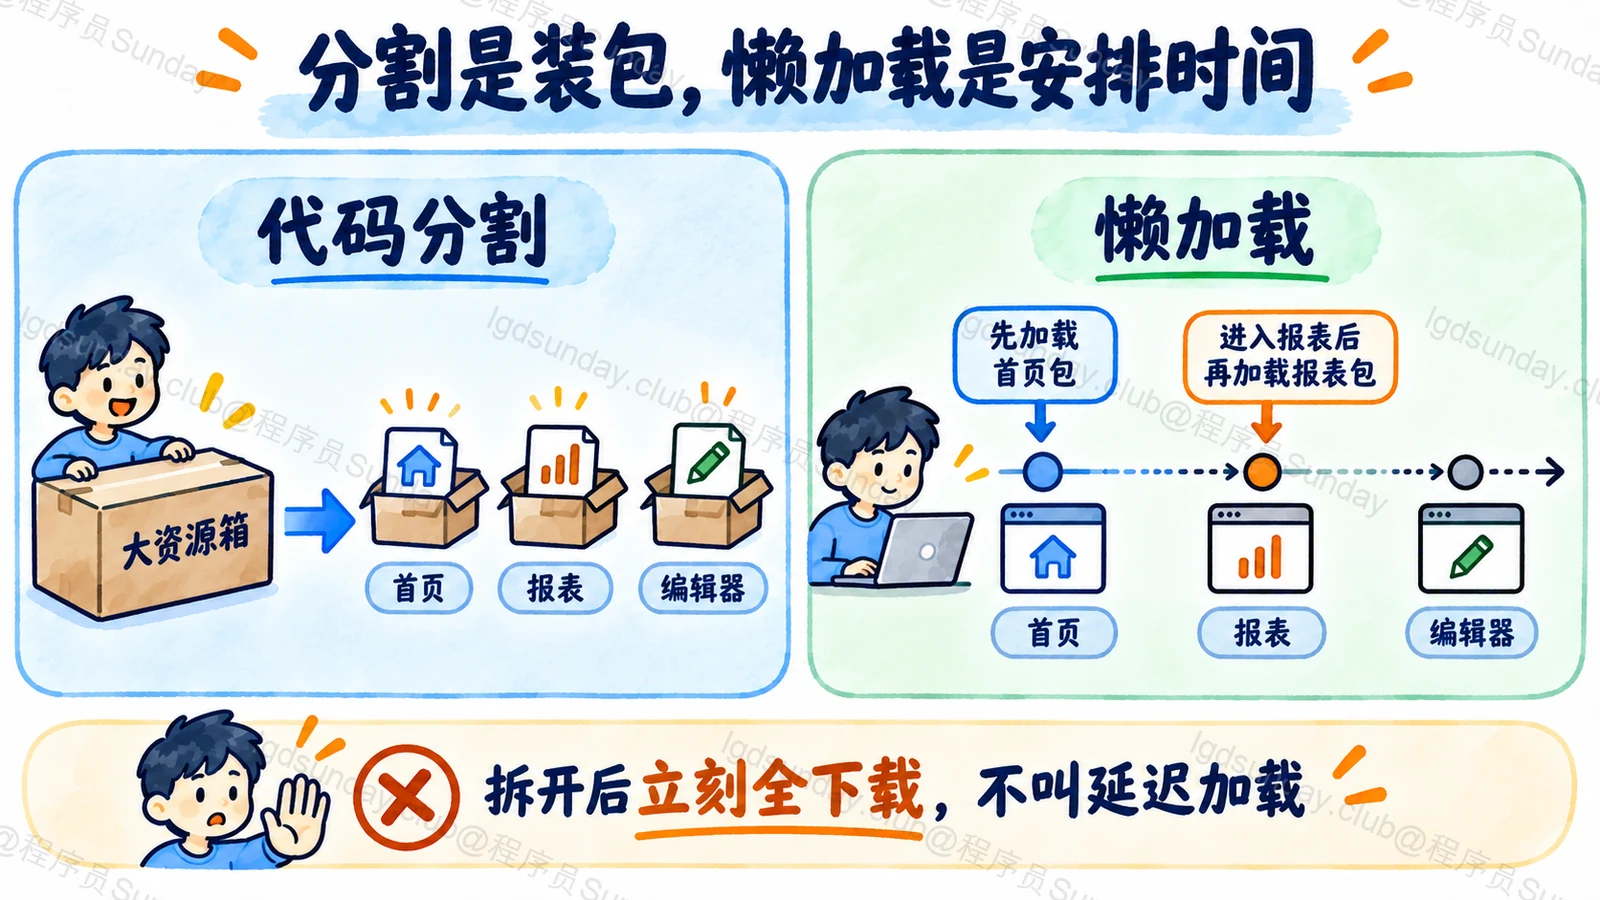
知识点详解:把代码拆开之后,等待去了哪里
拆包和推迟下载,先分成两个动作
假设后台首页有列表,另有一个很重的报表编辑器。用户不打开报表时,没有必要先下载它的全部代码。
你可以把编辑器拆成独立 chunk,再在进入报表时加载。代码分割解决输出组织,懒加载解决时间安排。
如果首页刚启动就请求这个 chunk,它仍然是分割结果,但没有把这部分下载从首屏路径里拿走。反过来,推迟下载图片也是懒加载,却不一定涉及 JavaScript 代码分割。
边界要贴近功能,不是每个文件都单独下载
路由通常是一个容易理解的边界:用户进入哪个页面,才需要那个页面的较重代码。独立编辑器、图表和导出功能也可以成为边界。
但每个小组件都单独分块,可能带来更多请求、重复管理和串行发现依赖的等待。共享依赖也要合理处理,避免各个功能包重复带同一大库。
动态 import 让工具看见一个异步加载点,但具体输出和预加载行为由构建工具、配置及框架决定。本题讨论 JavaScript 构建与浏览器下载,Python 的动态导入并不是对等的网络分块方案。
先看瀑布,再决定预取哪些资源
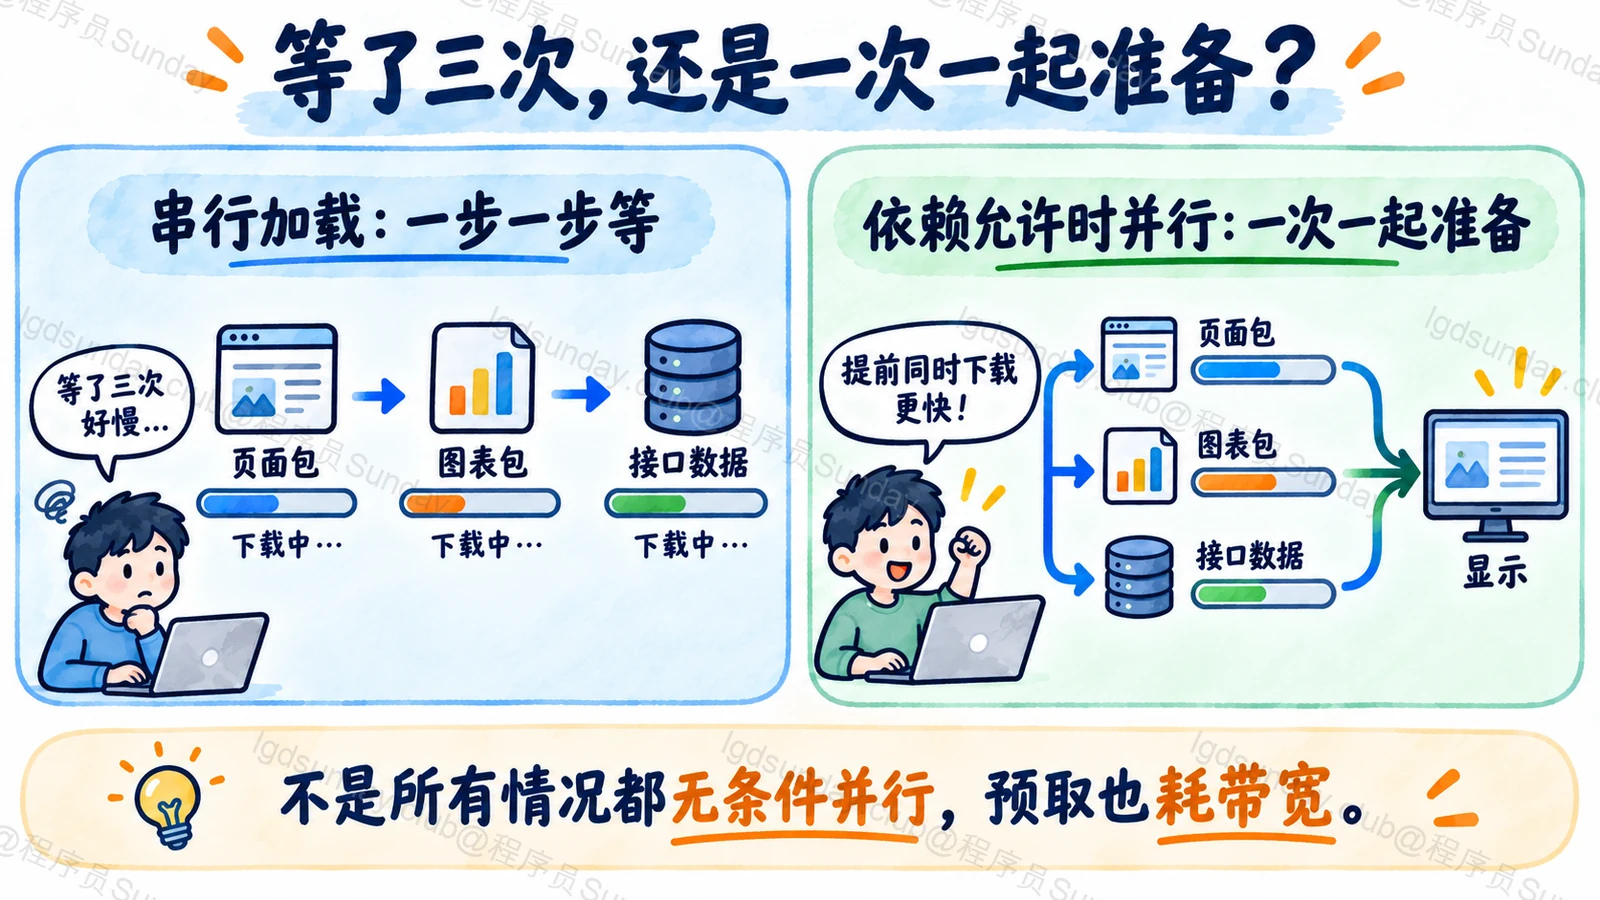
最差的一种路径是:点击后先拿页面包,执行页面包才发现图表包,图表包到达后再请求数据。每一步都等上一步,延迟就累积起来。
在知道接下来需要什么时,可以并行准备资源和数据,或根据用户即将进入的页面做预取。但预取也会消耗带宽,不能把所有懒加载内容又提前全拿回来。
页面应该给出明确的加载状态,并能处理失败。不要让用户面对一个长时间没有反馈的空白区域,以为点击没有成功。
发布后突然加载失败,可能是版本错位
用户一直开着旧页面。新版本上线后,服务器删除了旧 chunk,旧页面稍后才尝试加载它,就会找不到文件。
HTML 缓存策略、版本化资源和旧资源保留期要一起设计。Vite 也提供动态导入失败的相关事件,应用可以接入恢复,但自动刷新前要考虑用户尚未保存的数据。
验收时至少覆盖首次加载、后续切页、弱网、加载失败,以及发布前打开的旧页面。代码分割优化的是具体访问路径,不是把体积数字拆开就算完成。
本题机制参考:Webpack:Code Splitting、Vite:Building for Production。
面试官继续追问
动态 import 一定生成一个独立文件吗?
通常会形成异步加载边界,但是否独立、如何合并依赖由工具和配置决定,不能仅凭语法保证最终文件数。
预取越多越好吗?
要看命中概率、用户网络和资源优先级。无用预取可能与当前关键资源争带宽。
加载失败后直接刷新可以吗?
可以是恢复选项,但要限制循环刷新,并保护草稿等未保存状态,先区分资源版本失配和其他错误。
面试速记卡
- 分割:决定代码组织成哪些 chunk。
- 懒加载:决定什么时候加载资源。
- 边界:路由和较重独立功能,比机械按文件拆更实用。
- 性能:首屏收益与后续请求瀑布一起看。
- 发布:旧页面与新资源版本要兼容。
公司面试真题
这道题暂未收录可核验的公司真题来源。你可以先阅读本文解析,或浏览已收录的公司面试真题。
浏览公司面试真题 →