
Redis HyperLogLog 怎么统计 UV?为什么不能查询成员,也不能直接删除用户?
下面是一段教学用的模拟面试。
🧑💻 面试官:每天有很多访客,你会用 Redis 怎样统计 UV?
🙋♂️ 我:把用户放进 HyperLogLog,空间小,也能去重。
🧑💻 面试官:那能从里面查出今天有哪些用户吗?一个用户要求撤回记录,能只删他吗?
🙋♂️ 我:不能把它当成保存完整成员的 Set。
🧑💻 面试官:把每天 UV 相加,就是一周 UV 吗?所谓 0.81% 误差,是不是保证每次都不超过这个值?
HyperLogLog 保存的是「估算人数的摘要」,不是一份可以逐个查看、逐个删除的访客名单。
面试速答(60 秒版)
HyperLogLog 是近似基数统计结构,适合估算有多少不同元素。例如把统一身份口径的访客标识加入同一天的结构,再取得近似 UV。
Redis 中可以用 PFADD 加入元素、PFCOUNT 取得估计数量、PFMERGE 合并多个结构,估算它们的并集。合并周 UV 时不能直接相加每日结果,因为同一用户可能多天出现。
它利用哈希统计摘要节省空间,不保存可供列举的完整成员,所以不能据此判断某个具体用户是否访问,也不能直接逐个删除成员。
Redis 文档给出的 0.81% 是标准误差,不是每次估计绝对误差的硬上限。需要准确名单、精确结算或成员删除时,应该选择具有相应语义的存储,而不是因为节省内存就强用 HLL。
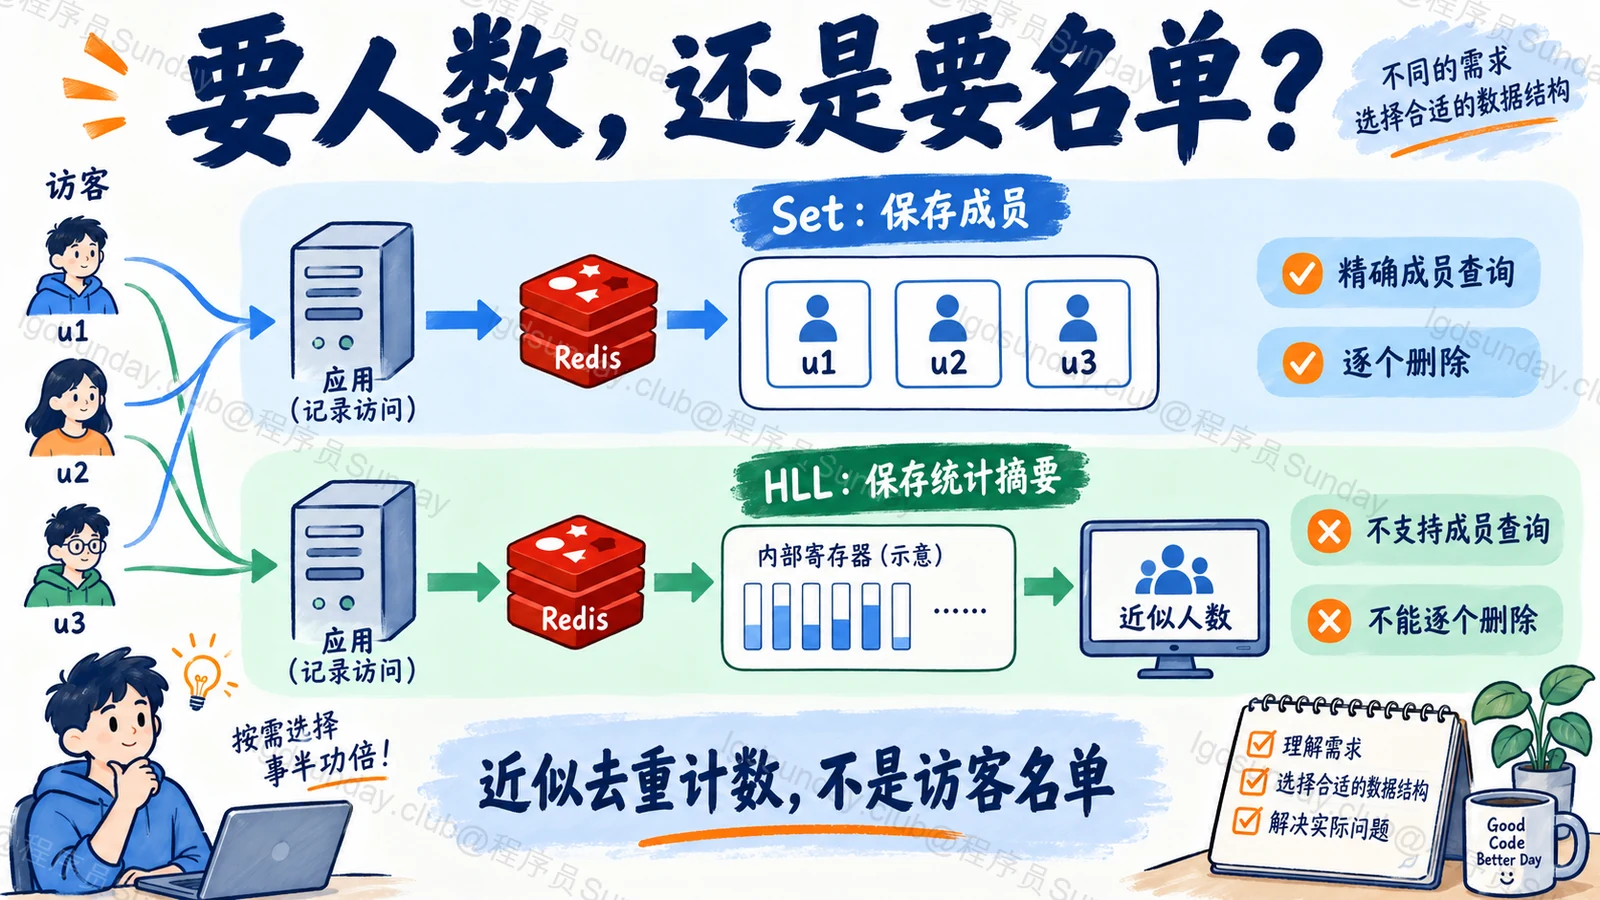
知识点详解:从访客名单,换成一份计数摘要
UV 的“不同”,先由身份口径决定
假设用户 u1 访问三次,u2 访问一次。如果按登录用户 ID 去重,这两人产生两份独立身份,而不是四个 UV。
但同一个人未登录时使用多个设备标识,可能被统计成多个身份;多人共享一个标识,也可能被合并。HyperLogLog 不会替我们识别人类的真实身份。
因此,先定义按用户、设备还是匿名标识去重,确定站点、页面和时间范围,再把一致标识加入结构。输入口径错了,换一种更精确的数据结构也救不了指标。
Set 留名字,HyperLogLog 留统计特征
使用 Set,可以保存 u1、u2,支持精确成员判断和枚举;随着不同成员增多,需要保存的成员信息也增加。
HyperLogLog 先把输入哈希化,再将哈希的一部分用于选择统计位置,另一部分用于记录相应的特征,例如特定位模式出现的程度。整体特征用于估算基数。
同一输入通常贡献同样的特征,所以重复加入不相当于增加一位新访客;不同输入也不保证每次都改变摘要,因为它们可能没有提高相关统计位置已有的记录。
Redis HLL 文档介绍了空间与准确率的取舍。重点不是把所有哈希公式背出来,而是理解:我们用摘要换掉了完整名单。
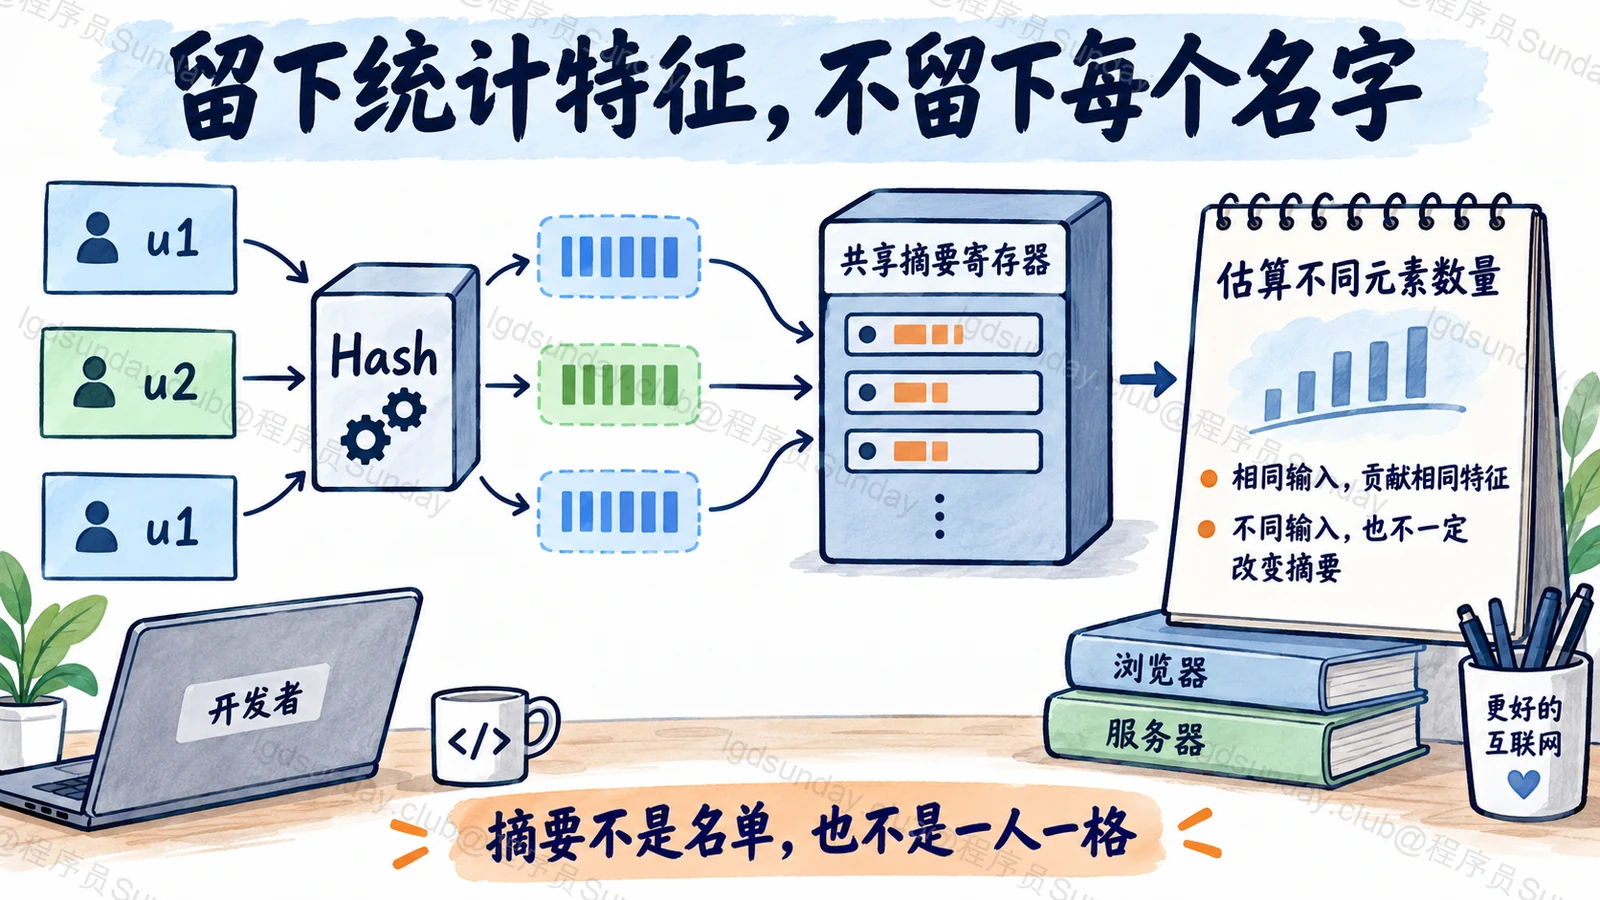
三条命令,分别负责什么?
下面是 Redis 命令示例,应在独立测试实例和专用测试键执行:
PFADD uv:demo:day1 u1 u2 u1
PFCOUNT uv:demo:day1

PFADD uv:demo:day2 u2 u3
PFMERGE uv:demo:two-days uv:demo:day1 uv:demo:day2
PFCOUNT uv:demo:two-days
第一天观察到的是 u1、u2,第二天是 u2、u3。两天并集的实际不同输入有三个,而不是每日数量相加得到的四个。
HLL 返回的是估计值,小规模示例可能得到精确结果,但不能由此推导大规模统计必然精确。
PFADD的返回值表示内部结构是否变化,不是“这次增加了几名 UV”。PFCOUNT 才用于取得基数估计。
周 UV 为什么应该合并结构,而不是合计数字?
每天的结果只保留一个估计数量。周统计需要知道跨天重复关系,但单独的数字没有这份信息。
PFMERGE 按摘要规则形成并集的统计结构,然后再取估计值。PFMERGE 文档说明了并集含义,而不是算术相加。
还有一个实际边界:如果目标键已经存在,它的原内容也会参与合并。想得到指定日期范围的快照时,应使用明确的新目标或符合更新语义的目标,不要把历史超范围摘要误混进来。
HLL 支持这种并集,并不意味着可以从两份计数中直接恢复交集名单,或者精确做减法。
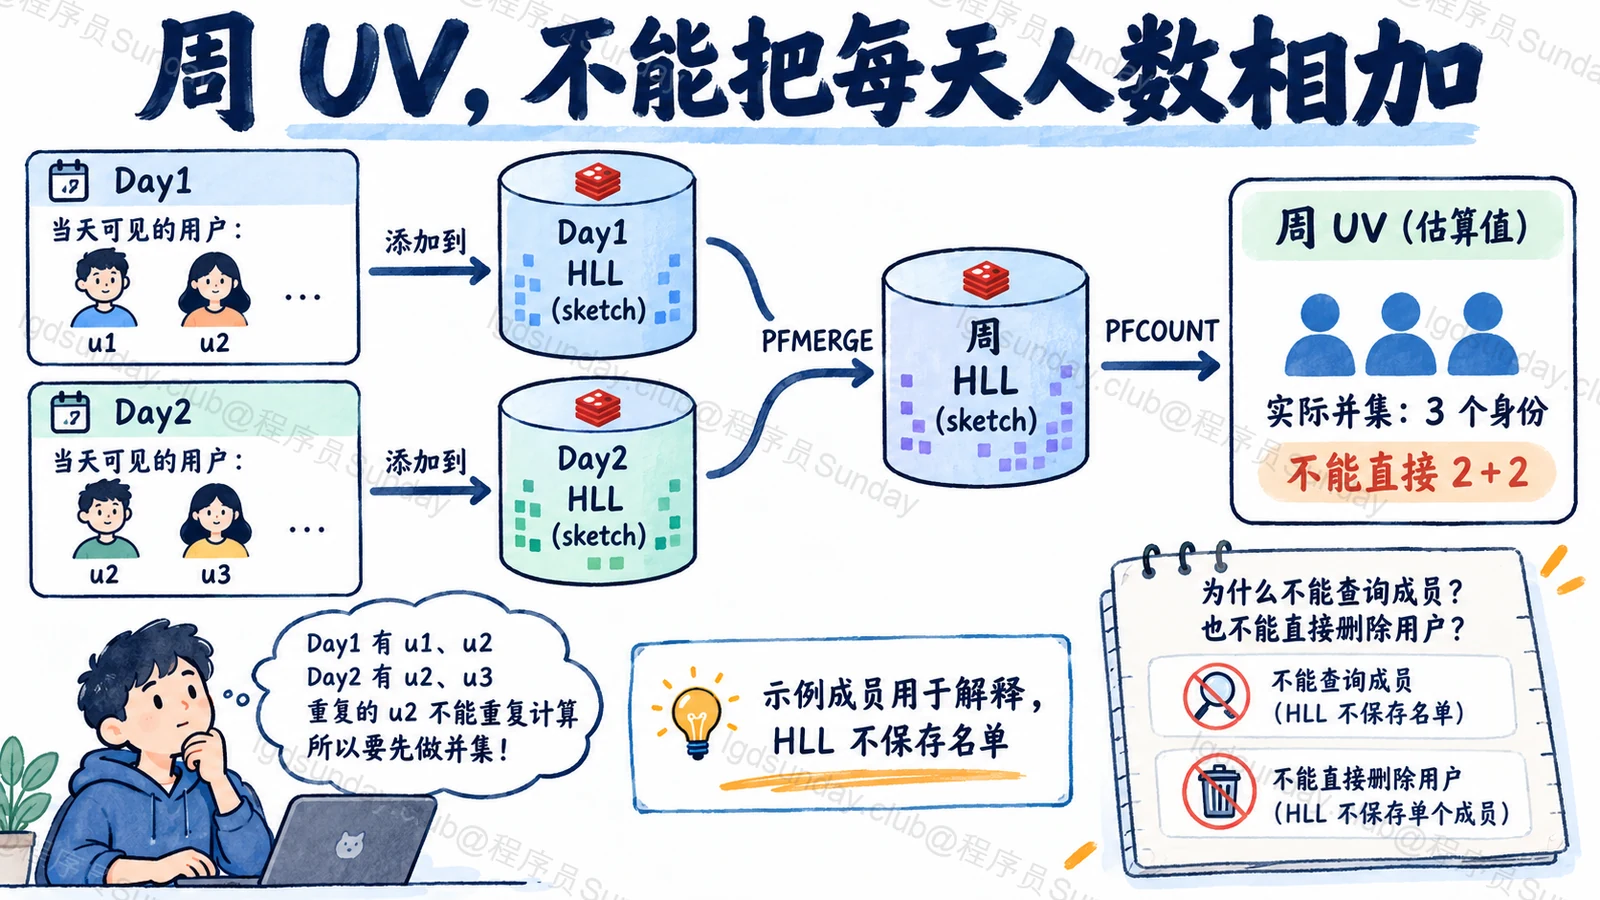
0.81% 和 12 KB,怎样说才准确?
Redis 文档给出的约 0.81% 是标准误差,用于描述估计精度,不是“无论怎样输入,每一次都保证误差不超过 0.81%”。
类似地,常见“最多约 12 KB”主要说 HLL 摘要空间这一层,不包含整个 Redis 中键名、元数据、复制及大量键的总开销。
如果按每个页面、每个小时都建一个结构,总键数仍然可能很大。不能用“一个 HLL 小”推导整个统计系统不需要容量规划。
删除某个用户,为什么不能靠减一?
结构里没有完整名单,也没有每个用户独立的一格贡献。
一个用户多次出现、多个用户共享统计特征,都会使“撤掉这个用户的贡献”无法简单反推。把估计数量减一,既没有修改原摘要,也不能让后续重新统计得到可靠结果。
有删除需求时,可以保留符合隐私策略和保留期限的权威数据,在需要时重新构建;如果业务本来就要求精确成员操作,则应选合适的集合或数据库方案。
滚动窗口也不能简单让一个周 HLL 每天“减掉昨天”。可以按固定时间桶保存,再合并当前需要的桶;粒度、误差和过期时间仍要明确。
面试官继续追问
HLL 能判断这个用户来过吗?
不能提供成员查询语义。布隆过滤器是另一类结构,也有误判边界;不能用 HLL 代替它。
计费人数可以直接用 HLL 吗?
如果结算要求精确且可审计,不能只靠近似摘要。近似流量看板和权威结算是不同任务。
身份是数字,用 Bitmap 就一定更省吗?
要看编号范围和稀疏程度。很大的稀疏编号可能浪费空间,且 Bitmap 保存具体位的语义与 HLL 估算也不同。
面试速记卡
- 用途:估算不同元素数量,先确定身份与时间口径。
- 数据:哈希统计摘要,不是完整访客名单。
- 命令:PFADD 更新,PFCOUNT 估计,PFMERGE 合并并集。
- 精度:0.81% 是标准误差,不是单次误差硬上限。
- 边界:不做成员查询、逐个删除或精确结算;跨天不能直接加数量。
公司面试真题
这道题暂未收录可核验的公司真题来源。你可以先阅读本文解析,或浏览已收录的公司面试真题。
浏览公司面试真题 →