
SQL 的 WHERE 和 HAVING 有什么区别?GROUP BY 之后怎么筛选?
下面是一段教学用的模拟面试。
🧑💻 面试官:WHERE 和 HAVING 有什么区别?
🙋♂️ 我:WHERE 在分组前,HAVING 在分组后。
🧑💻 面试官:我要找已支付金额总计超过 1000 的用户。把每笔 amount > 1000 放进 WHERE,可以吗?
🙋♂️ 我:不可以,那筛的是单笔金额,不是用户合计金额。
🧑💻 面试官:那某个用户两笔都是 600,应该留下吗?已经有 HAVING,为什么还要先用 WHERE 筛已支付记录?
用一句话记:「哪些明细参加统计」归 WHERE,「哪些统计结果留下」归 HAVING。
面试速答(60 秒版)
WHERE 主要筛选参与后续查询的明细行,GROUP BY 把这些明细按指定键分组,聚合函数再计算每组的合计、数量等结果,HAVING 筛选分组后的结果。
因此,查询“已支付金额合计超过 1000 的用户”,应先用 WHERE 限定已支付记录,再按用户分组,最后用 HAVING 判断 SUM(amount) 是否超过 1000。
不能把 SUM(amount) > 1000 改成 amount > 1000,因为前者筛用户合计,后者筛单笔记录,参与统计的数据已经不同。
这是一条理解查询语义的主线,不是说数据库必须按这几步逐行机械执行。实际优化器可能调整物理执行计划,但不能因此改变查询应表达的结果。
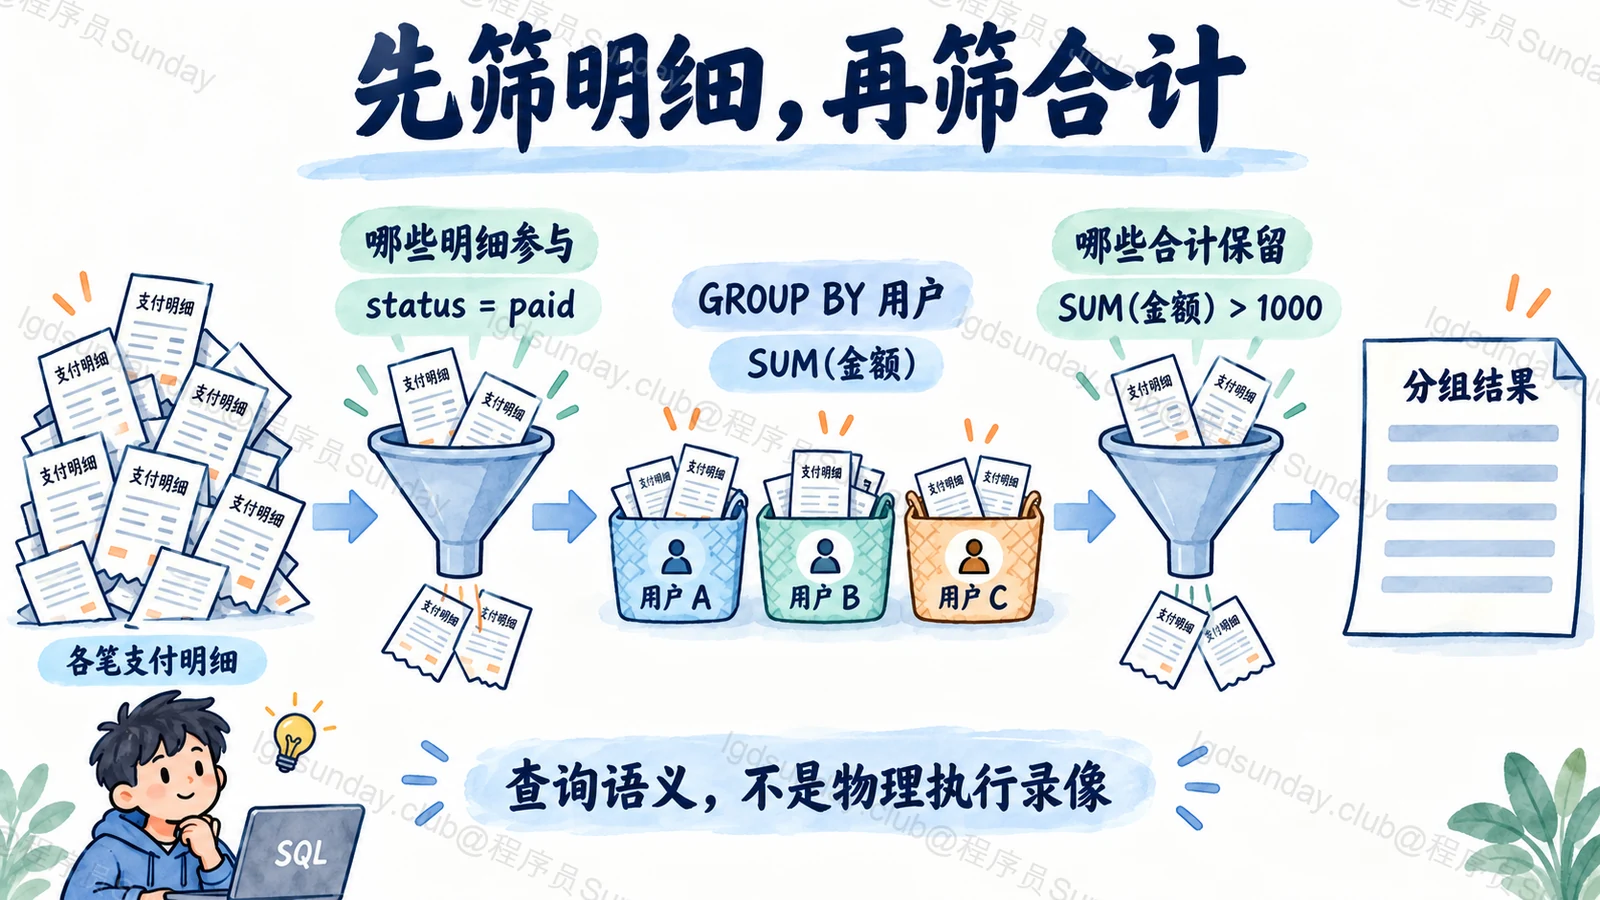
HAVING 筛的是分组后的合计记录,后段的单据图标不代表再筛一次原始支付明细。
知识点详解:用五条明细,一步一步算出结果
先确定,题目问的是每一行还是每一组
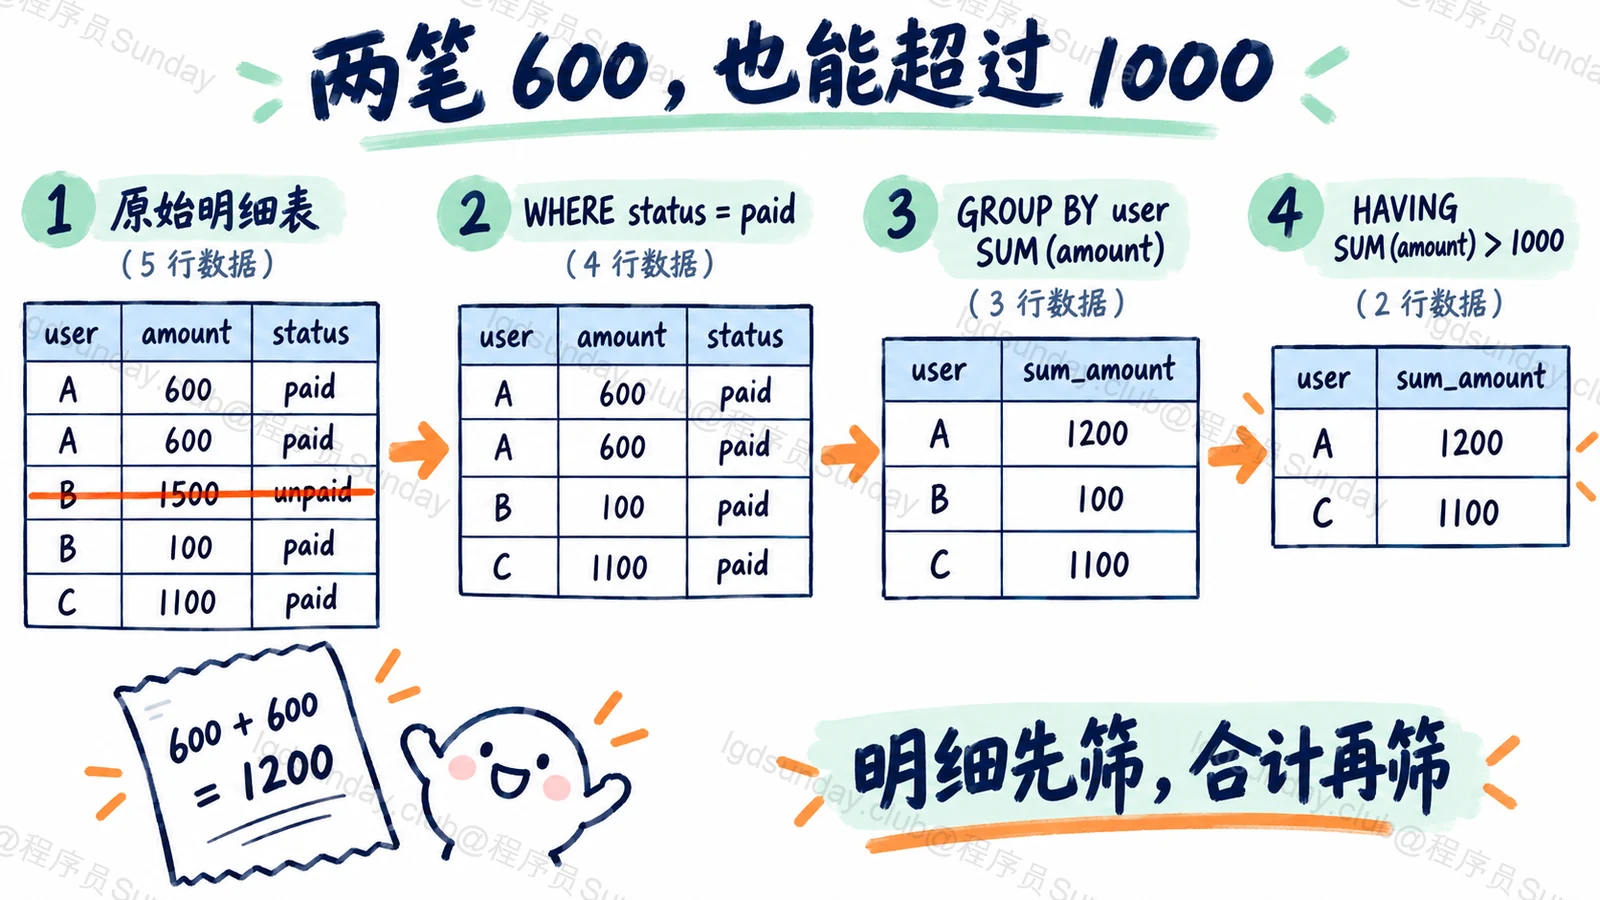
假设测试表有以下数据,金额都使用同一货币单位:
| 用户 | 金额 | 状态 |
|---|---|---|
| A | 600 | paid |
| A | 600 | paid |
| B | 1500 | unpaid |
| B | 100 | paid |
| C | 1100 | paid |
目标是找出“已支付金额合计超过 1000 的用户”。
A 虽然没有任何一笔超过 1000,但合计达到 1200,应该保留。B 有一笔 1500,却没有支付,不能算入这次合计。C 的一笔已支付金额是 1100,也应该保留。
先把期望结果说出来,后面的 SQL 才有东西可以验证,而不是靠关键字顺序猜。
WHERE:把不该参加统计的明细拿走
先筛 status = ‘paid’,B 的 1500 未支付记录不参加后续统计。
此时剩下 A 的两笔 600、B 的一笔 100、C 的一笔 1100。WHERE 没有在这个例子中把任何一位用户作为整体判定合格,它处理的仍是明细输入。
如果错误地再加入 amount > 1000,A 的两笔都会被拿走。后面再怎么 SUM,也无法得到已经被排除的 1200。
所以,WHERE 条件不是“早筛一点总是更好”。早筛的前提是条件符合目标语义,不能为了少处理数据就改变统计口径。
GROUP BY 和聚合:把明细变成用户统计
按 user_id 分组,得到三个组:
A 组的两笔金额相加是 1200,B 组是 100,C 组是 1100。
GROUP BY 指定的是分组依据,SUM 负责把组中的数值汇总。只写 GROUP BY 不代表数据库会替你决定所有列要怎样显示。
然后 HAVING 保留总额超过 1000 的组,结果就是 A、C。MySQL SELECT 文档说明了 WHERE、GROUP BY、HAVING 的不同用途。
对应 SQL,该怎样写?
SELECT user_id, SUM(amount) AS total_amount
FROM payment_demo
WHERE status = 'paid'
GROUP BY user_id
HAVING SUM(amount) > 1000
ORDER BY user_id;
这是 SQL 查询,不需要为了双语言形式再复制成 TS 和 Python。调用数据库时可以使用不同驱动,但不会改变本题中的分组语义。
在上述数据中,输出 A / 1200 和 C / 1100。这个结果也能帮助我们检查配图:不能误把 B 的未支付 1500 加进去,不能把 A 画成因单笔不足 1000 而被排除。
MySQL 允许在 HAVING 中使用这里的列别名 total_amount,但写聚合表达式更容易让读者看到含义。别名在 WHERE 中的可用规则不同,也不要把 MySQL 的扩展一概推广给所有数据库。
为什么不能随手把 name 也写进 SELECT?
假设只有 user_id 是分组列,SELECT 里却又加入一个没有聚合、也没有明确依赖关系的 name。
同一个组中如果出现多个名字,到底该选哪个?这是结果定义问题,不是“数据库随便拿一个也差不多”。
MySQL GROUP BY 处理文档说明,默认启用的 ONLY_FULL_GROUP_BY 会检查相应列是否属于分组、存在可识别的函数依赖,或者满足其他明确条件。
所以,也不能背成“所有 SELECT 列都必须写进 GROUP BY”。函数依赖等情况需要区分。但如果一个组里确实有多个可能值,就应明确选择规则、使用合适的聚合,或改写查询,而不是关闭检查掩盖歧义。
逻辑顺序,不是数据库执行现场的录像
我们按明细筛选、分组计算、组结果筛选来解释,是为了让查询结果可理解。
实际执行可能利用索引,也可能把安全的条件下推,或者采用不同聚合方式。不能从讲解顺序推导出“WHERE 一定扫描完全部行后,才允许进行任何别的工作”。
面试要把两个层次分开:语义决定结果,执行计划决定怎样计算。优化要保持前者不变,再改善后者。
面试官继续追问
HAVING 没有 GROUP BY,也能出现吗?
可以存在把输入作为一个整体进行聚合和过滤的查询。不要把 HAVING 定义成“语法上必须跟在 GROUP BY 后面的装饰”。
所有 HAVING 条件都能挪到 WHERE 吗?
不能。聚合条件不能直接这样移动。即使是不涉及聚合的条件,也要确认分组和空值等语义;理解等价关系后再谈下推。
COUNT(*) 和 COUNT(amount) 一样吗?
amount 可能为 null 时不同。COUNT(*) 计行,COUNT(amount) 只计该表达式非空的行。先确认统计的是记录数量还是有值数量。
面试速记卡
- WHERE:决定哪些明细参加统计。
- GROUP BY:决定按什么键形成组。
- 聚合函数:把组内明细算成合计、数量等结果。
- HAVING:决定哪些组结果留下。
- 优化边界:逻辑顺序解释语义,物理计划可以改变计算方式。
公司面试真题
这道题暂未收录可核验的公司真题来源。你可以先阅读本文解析,或浏览已收录的公司面试真题。
浏览公司面试真题 →