
🧑💻 面试官:MySQL 索引为什么常用 B+ 树,不用二叉搜索树?
🙋♂️ 我:B+ 树一个节点可以有很多分支,树更矮,读取的页通常更少。
🧑💻 面试官:哈希平均查找很快,为什么不全部换成哈希?
🙋♂️ 我:哈希适合等值查找,但不擅长有序范围查询。
🧑💻 面试官:那按订单号查到二级索引以后,就一定拿到了完整订单吗?你刚才说的“少读页”,少的是哪些页?
索引不只是内存中的查找题,还要解释「按页读取、范围连续、记录放在哪里」。
面试速答(60 秒版)
这里通常讨论的是 InnoDB 的常见索引,不能把所有 MySQL 索引都说成同一种结构。
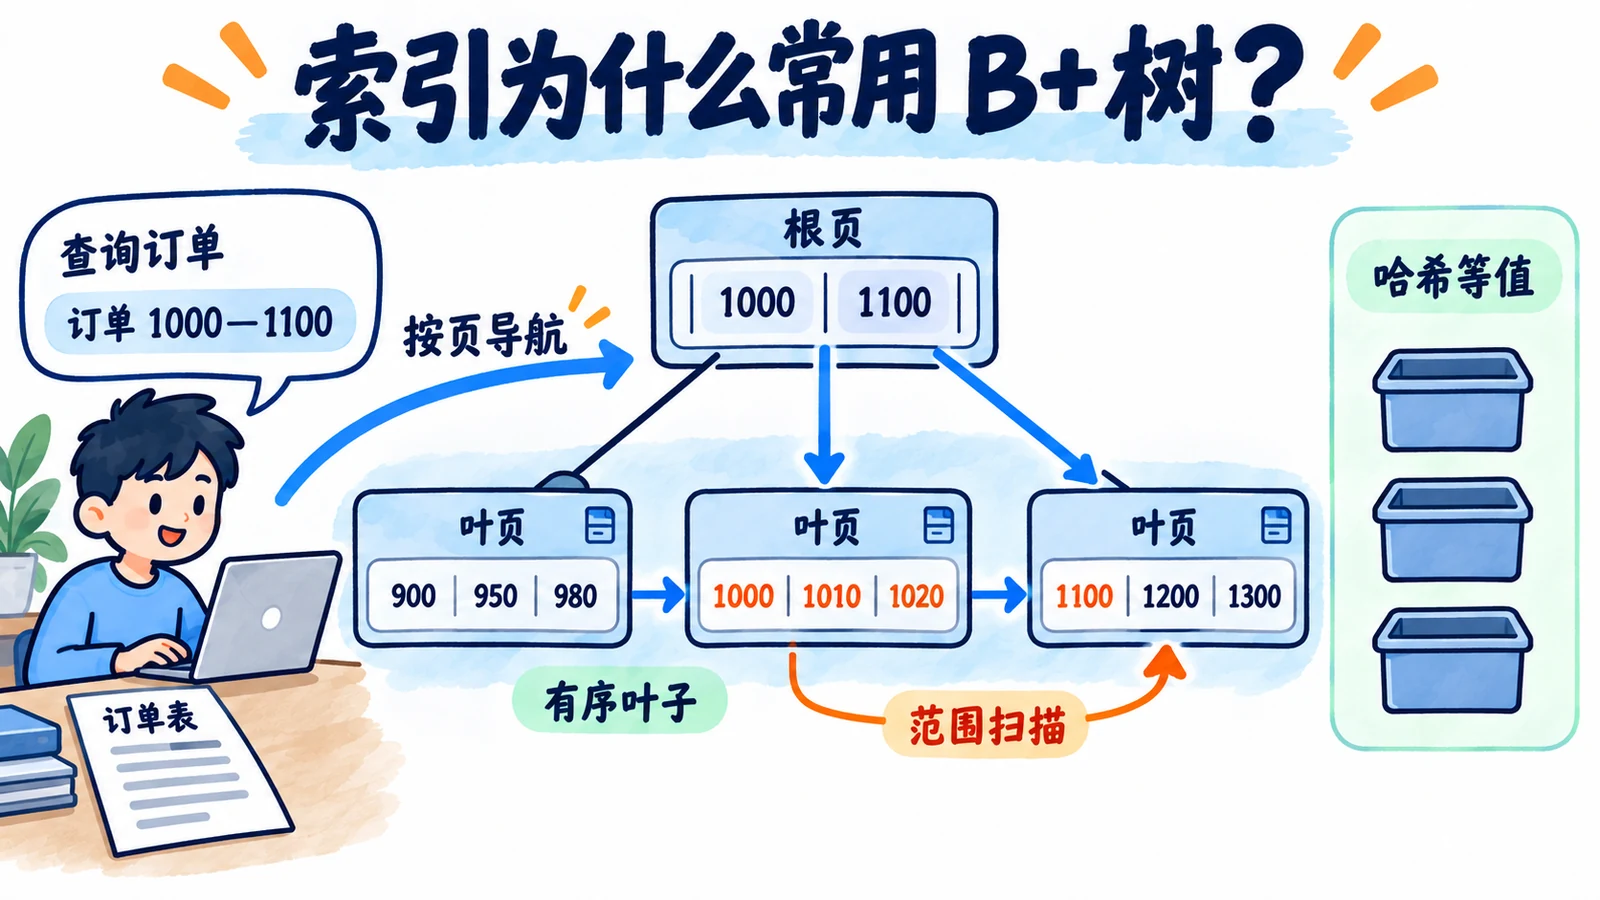
B+ 树内部节点主要保存键和指向下一层的指针,一个页能容纳较多分支,因此树通常较矮。记录按键有序组织在叶子层,范围查询定位起点以后,可以沿叶子层继续扫描。
相比之下,普通 B 树内部节点也保存记录;哈希索引适合等值定位,但不提供同样的有序范围访问能力。
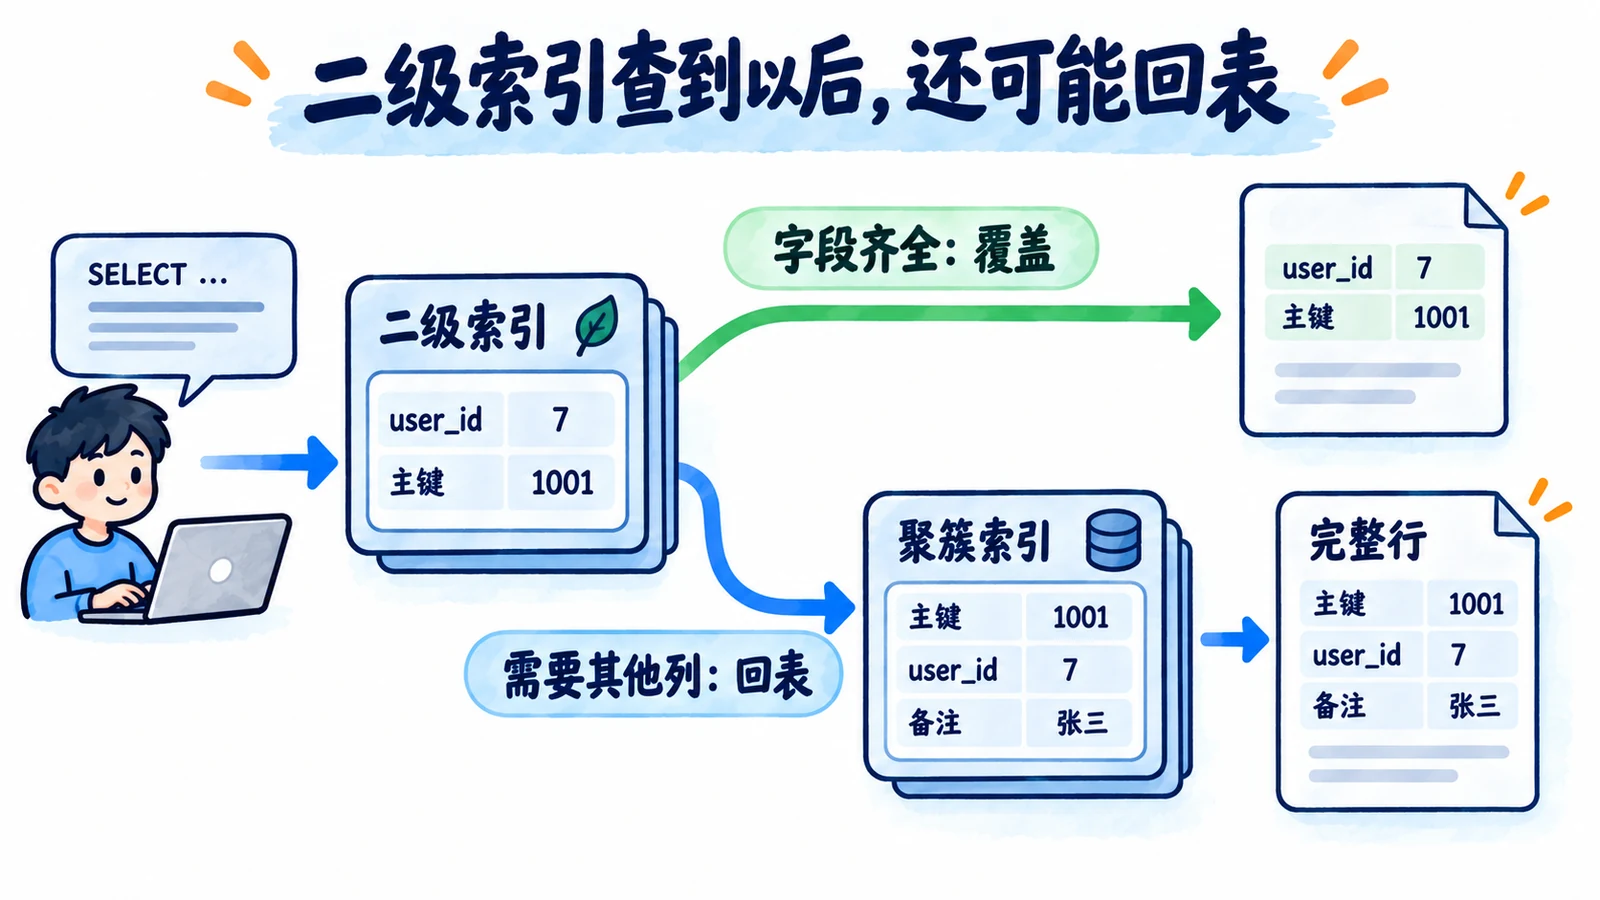
同时,InnoDB 聚簇索引叶子保存完整行,二级索引叶子包含索引列和主键。查询需要其他列时,可能还要通过主键查聚簇索引。因此,判断查询成本要看访问哪些页、扫描多少记录,以及是否需要回表。
知识点详解:数据库读一条记录,为什么要讨论“页”?
索引不是一次搬进内存的数组
假设订单表有很多行,数据分散保存在页中。数据库会把需要的页读入缓冲池;页已在内存里时,也仍然需要在页内寻找记录。
因此,查找成本不能只看比较了多少次,还要看访问了多少页,以及是否需要从存储设备读入。
二叉树一个节点只有少量分支,规模大以后高度可能较高。B+ 树的节点可以容纳许多键和指针,一次进入一个内部页,就能选择较大范围中的下一页。树更矮,通常意味着从根到叶需要经过更少的层。
这不是说每次查询都一定产生同样次数的磁盘 I/O。上层索引页可能已经缓存在内存,真实成本还受缓存命中和存储影响。
内部节点和叶子节点,放的内容不同
在常见 B+ 树中,内部节点负责导航,记录集中在叶子层。内部页不放完整行,就有机会容纳更多索引键,增加分支数量。
普通 B 树的记录可以出现在内部节点和叶子节点。两者都可以保持平衡,不能把 B 树说成天然失衡或一定很慢。
B+ 树把记录组织在有序的叶子层,范围读取比较顺畅。对于数据库常见的范围、排序和批量访问,这种安排比较合适。MySQL 的索引结构说明介绍了 InnoDB 聚簇与二级索引的具体存储。
查一段订单号,为什么不必从根开始查每一条?
假设要查询编号从 1000 到 1100 的订单。B+ 树先定位范围起点,再沿叶子层读取后续键,直到越过上界。
这些键有序排列,因此范围边界可以指导扫描。但“逻辑上相邻”不代表磁盘上每个页都物理连续,也不能保证所有页都已在缓冲池里。
哈希索引则按哈希值定位桶。编号 1000 和 1001 不一定落到相邻位置,所以它不具备同样的范围顺序。MySQL 某些引擎支持哈希索引,InnoDB 也有自适应哈希等机制,但不能因此把常见用户索引理解成全部采用哈希。B-Tree 与 Hash 比较说明了访问能力的差异。
查二级索引,为什么还可能“回表”?
假设订单表主键是 id,另建了用户编号索引。二级索引叶子里可以找到用户编号和相应主键,但完整订单信息放在聚簇索引叶子中。
如果查询还要订单备注,就可能通过主键再查聚簇索引。这一步通常称为回表。
如果需要的字段都能从二级索引获取,就有机会使用覆盖索引,减少这次额外访问。但覆盖索引并不是越宽越好:列更多,索引页更大,写入和维护成本也更高。
因此,解释“索引为什么快”时,要顺着实际查询走完,不能在二级索引找到键以后就停下。
面试官继续追问
主键越长,会有什么影响?
二级索引需要保存主键,所以较长主键会让多个二级索引一起变大。
同一个页能放的记录可能减少,缓存效率和维护成本也会受到影响。是否选择某种主键,还要结合生成方式、写入分布和业务约束,不是单凭长度决定。
用了索引,就一定比全表扫描快吗?
不一定。如果要取出大部分行,沿二级索引读取再大量回表,可能比扫描聚簇索引更贵。
优化器会估算代价。应结合执行计划与实际数据分布检查,不能看见全表扫描就直接认定数据库做错了。
如何验证某个索引值得保留?
检查它支持哪些高频查询,减少了多少扫描和回表,同时比较写入开销与存储占用。
只在空表上跑一次查询,看不出真实代价。需要有代表性的行数和分布,还要观察索引有没有重复建设。
面试速记卡
- B+ 树:多路、平衡,内部导航,叶子层有序存储记录。
- 页访问:树高提供线索,实际 I/O 还受缓冲池影响。
- 范围查询:定位起点后沿叶子层继续扫描。
- 哈希区别:擅长等值定位,不提供同样的有序范围能力。
- InnoDB:聚簇叶子是行,二级叶子包含主键,必要时回表。
