
🧑💻 面试官:SQL 明明有索引,为什么还是慢?
🙋♂️ 我:可能条件无法有效使用索引,也可能优化器认为别的访问方式更便宜。
🧑💻 面试官:EXPLAIN 的 key 有值,是不是就说明优化成功?
🙋♂️ 我:还得看扫描范围和回表,可能只是扫描了整个索引。
🧑💻 面试官:type 是 ALL,但只查一张很小的表。你会马上强制它走索引吗?
不要把「用了索引」当成目标,要看索引有没有减少真正昂贵的扫描与读取。
面试速答(60 秒版)
所谓索引失效,实际要分清两种情况:查询条件无法利用索引有效定位,以及索引可用,但优化器没有选择它。
例如,对索引列做函数处理、发生某些隐式转换,或者字符串查询以通配符开头,可能无法按原索引缩小范围。联合索引还要结合列顺序和具体条件判断,不能只背“有某个操作就一定失效”。
查看 EXPLAIN 时,要一起看实际选择的 key、访问类型、预计扫描行数和附加操作。key 不为空,也可能只是完整索引扫描;需要很多回表时,未必比全表扫描便宜。
最后再用真实数据和合适的执行分析确认。EXPLAIN ANALYZE 会真正执行查询,因此不能对高成本或有风险的语句随意运行。
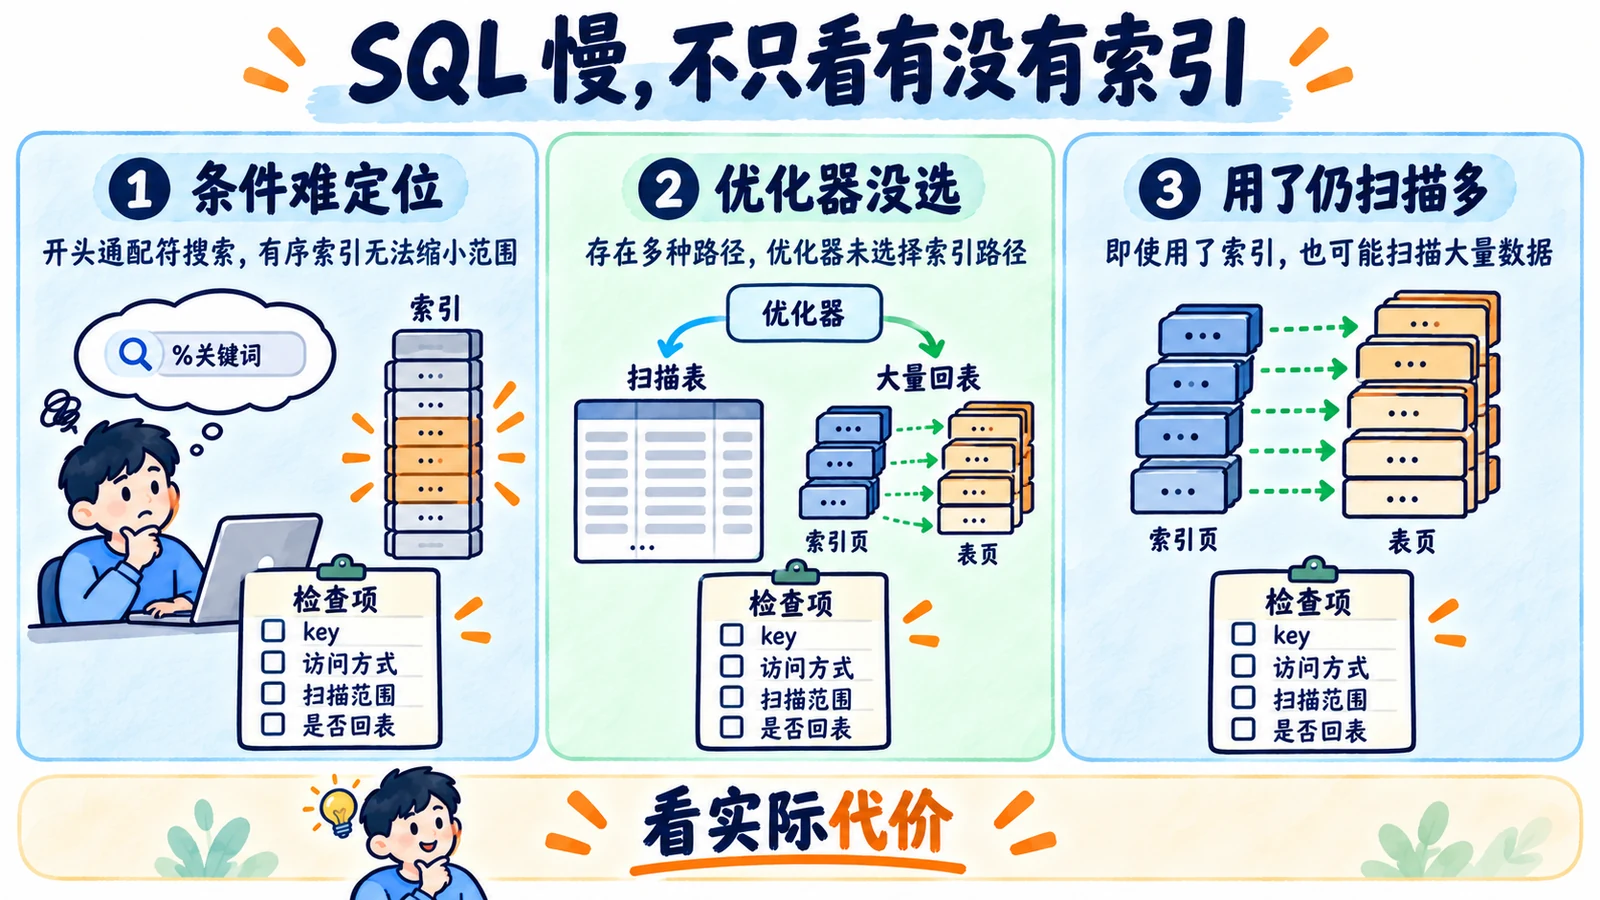
知识点详解:先区分“不能定位”和“不想选”
一个日期函数,为什么改变了查找方式?
假设订单表在 created_at 上有普通索引。我们想查询某一天的订单,写成:
SELECT id, created_at
FROM orders
WHERE DATE(created_at) = '2026-10-01';
普通索引按原来的时间值排序,而条件要求先把每行时间变成日期再比较。数据库不一定能直接利用这个索引形成高效范围。
可以把条件改成同一时区、同一日期含义下的范围:
SELECT id, created_at
FROM orders
WHERE created_at >= '2026-10-01 00:00:00'
  AND created_at <  '2026-10-02 00:00:00';
这样更容易利用有序范围定位。不过,函数索引、生成列索引及优化器能力可能改变结果,所以不能说“出现函数就永远没有索引”。日期列类型和时区语义也要保持一致,不能为了性能改错查询含义。
联合索引为什么要看排列顺序?
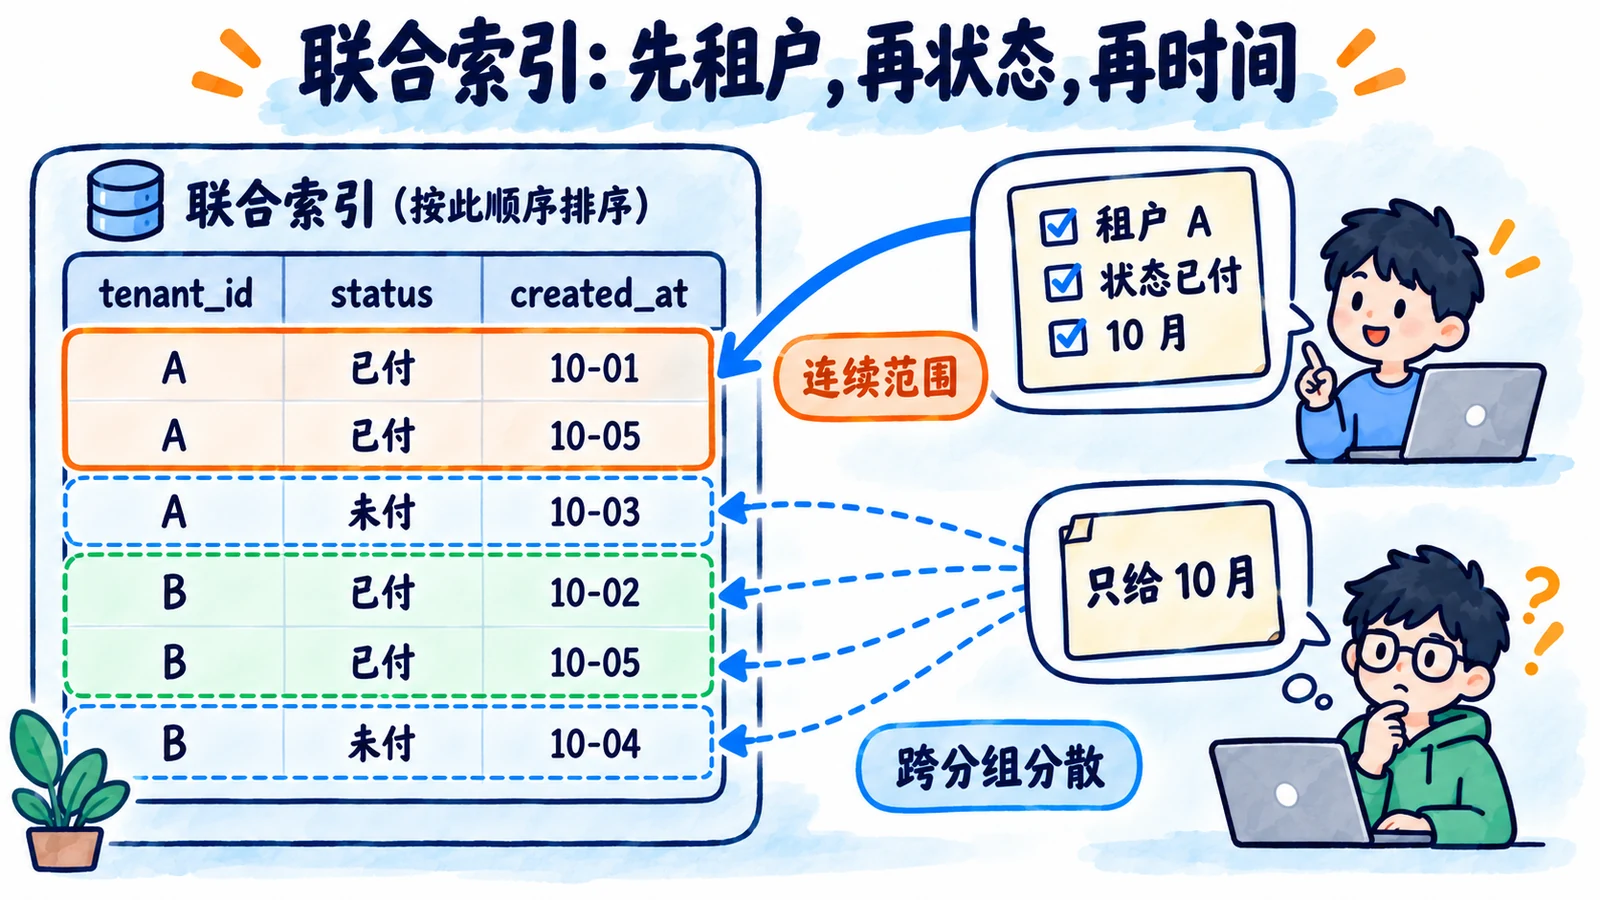
假设索引是 tenant_id、status、created_at。它先按租户排,同一租户里再按状态排,最后按时间排。
租户和状态都确定以后,一段时间范围通常比较容易定位。只给 created_at,则符合条件的记录可能分散在很多租户和状态分组中,不像连续的一段范围。
这解释了最左前缀为什么重要,但不是说缺少第一列以后,任何索引利用都不可能。优化器还可能选择其他方式,例如某些情况下的 Skip Scan 或覆盖扫描。
范围之后的列也不能简单说成“完全没用”,它们可能仍参与过滤或覆盖,只是不一定继续缩小同一段索引访问区间。MySQL 的联合索引说明与范围优化说明给出了更准确的适用条件。
索引能用,为什么优化器还是全表扫描?
假设条件会匹配表里大部分订单,还需要取很多不在二级索引中的字段。
沿二级索引找到主键,再对大量行回表,可能比直接扫描聚簇索引更贵。表很小时,全表读取也可能本来就便宜。
优化器根据统计信息估计代价。数据分布改变、统计过旧或者估计不准确,都可能让选择不理想,但应该先检查证据,不要直接 FORCE INDEX。
EXPLAIN 应该怎样连起来读?
possible_keys 表示可能考虑的索引,key 表示实际选中的索引。二者不是同一个结果。
type 可以帮助判断访问方式,例如范围访问或全表扫描;type=index 则可能是完整索引扫描,不能看见单词 index 就认为只查了几条。
rows 和 filtered 是估算信息,不能直接当成实际返回行数。Extra 中的 Using index 常提示覆盖访问,Using filesort 表示排序未由相应索引顺序直接完成,也不意味着一定写磁盘或必然很慢。
因此,要顺着计划看:在哪里找候选、预计找多少、是否回表、是否排序,再结合实际耗时。EXPLAIN 官方说明还介绍了 ANALYZE 的实际执行信息。本文不提供虚构的计划数字,应该在自己的代表性数据上观察。
面试官继续追问
LIKE 一定导致索引失效吗?
不一定。常量前缀如 ‘abc%’ 可以形成有序范围,而 ‘%abc’ 通常不能靠这个前缀范围定位。
但是否使用索引,还受字符集、表达式和代价估算影响。覆盖扫描也可能出现,所以要区分“无法前缀定位”与“完全没有使用任何索引”。
加更多索引,问题会不会自然解决?
不会。索引增加存储,也增加写入和维护成本。
先分析高频查询的过滤、排序与返回字段,再选择必要的索引。重复索引和过宽覆盖索引可能让读稍快,却拖慢写入。
怎么验证改写 SQL 没有改变结果?
对照正常数据和边界数据,确认行集合、排序、空值和时间条件一致。
然后在相同数据规模与缓存条件下比较扫描量、回表、耗时和写入影响。先保证查询含义正确,再谈性能。
面试速记卡
- 先分类:条件不能有效定位,或优化器不选择。
- 联合索引:理解排序顺序,不背绝对“失效清单”。
- key 有值:不代表扫描少,也不代表没有回表。
- 估算与实际:rows 是估算,ANALYZE 会执行。
- 优化目标:结果不变,减少实际代价,而非强行出现索引名字。
