
HTTP Keep-Alive 和 TCP Keepalive 有什么区别?长连接能保证对方一直在线吗?
下面是一段教学用的模拟面试。
🧑💻 面试官: HTTP 长连接和 TCP Keepalive 是一回事吗?
🙋♂️ 我: 都是让连接别断,减少重新建连接。
🧑💻 面试官: 一条 TCP 连接暂时没有 HTTP 请求,还会被复用吗?Keepalive 会不断替你发送业务请求吗?
🙋♂️ 我: 连接复用和空闲探测应该是两层机制。
🧑💻 面试官: 探测成功,能证明订单接口正常、数据库没卡住吗?
先分清「连接复用」与「对端探测」。传输层还活着,不代表业务能正常处理。
面试速答(60 秒版)
HTTP 长连接通常指复用连接来承载多次请求,减少反复建立连接的成本。HTTP/1.1 默认采用持久连接,但实际能保留多久,仍受客户端、服务端和中间代理的超时等条件影响。
TCP Keepalive 是传输层对空闲连接进行探测的一种机制,需要启用并按系统参数运行。它帮助发现某些连接失效,不负责发送真实业务请求。
因此,两者不是同一层的开关。连接池复用、TCP 探测与应用心跳,各有不同目的和覆盖范围。
Keepalive 成功也不能证明业务健康。要判断接口能否服务,还需要应用层指标、超时和有意义的健康检查。
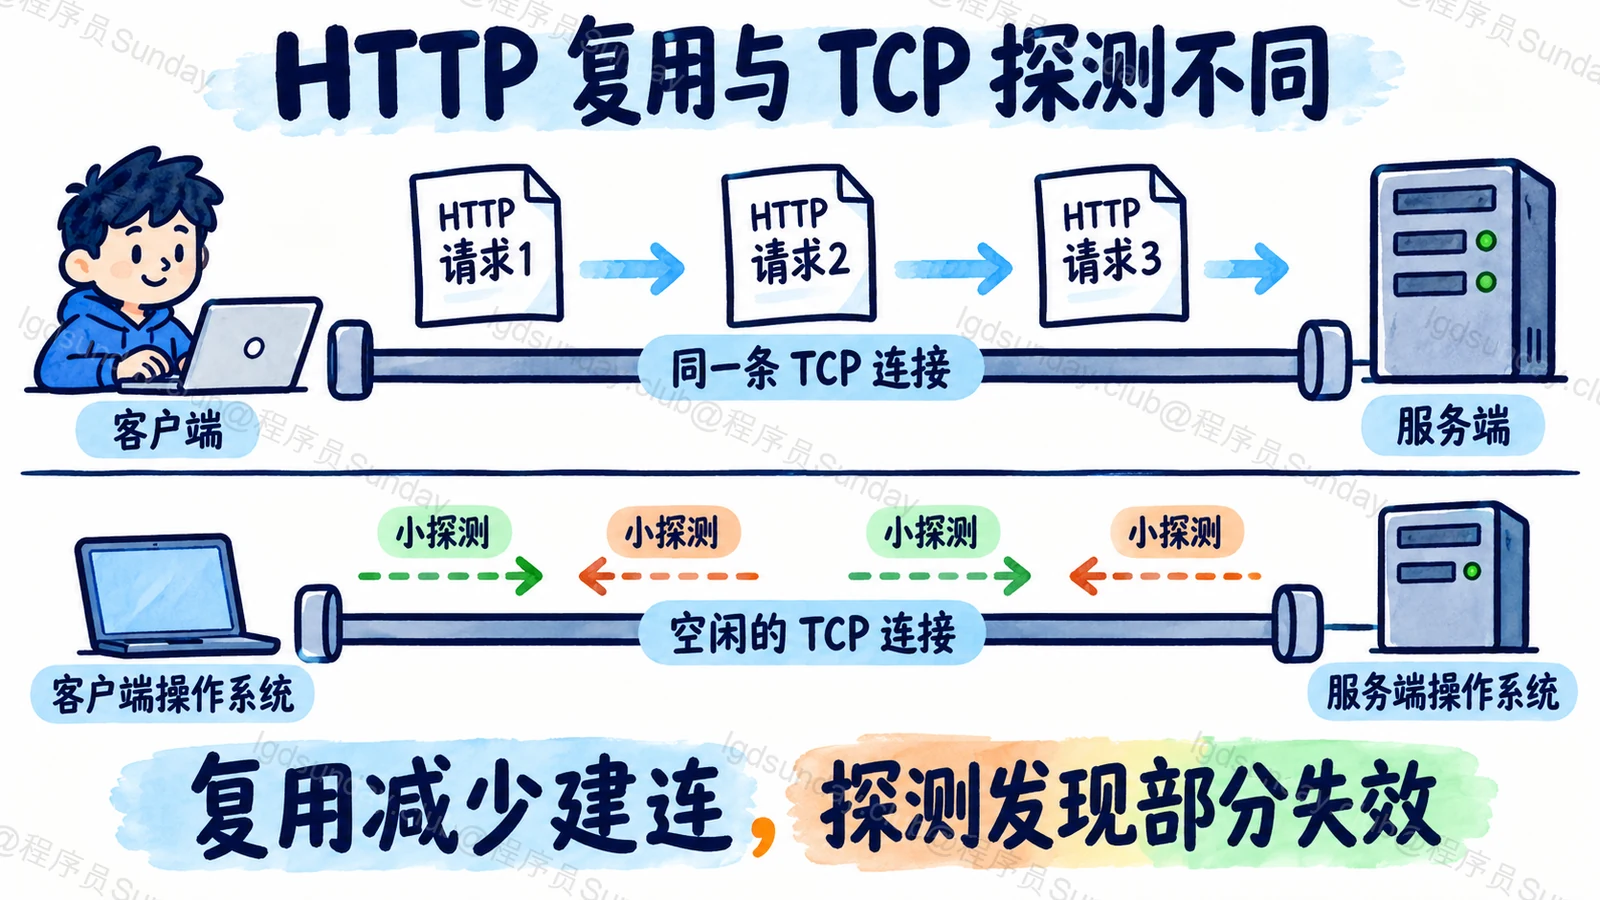
图:HTTP 复用与 TCP 探测不同。
知识点详解:连接还在,与请求能完成,不是一回事
HTTP 为什么想复用连接?
假设客户端连续请求同一个服务。每次都新建连接,会重复付出建连等成本。持久连接允许在符合协议与实现条件时继续使用已有连接。
HTTP/1.1 默认持久连接,但不是无限保留。响应定界、Connection: close、空闲超时与错误处理都会影响后续能否复用。规范见 RFC 9112。
HTTP/2 还有多路复用,HTTP/3 则基于 QUIC。不能把 HTTP/1.1 的 Connection 头写法当成所有 HTTP 版本通用的连接开关,也不能把“连接复用”直接等同“同时并发处理请求”。
TCP Keepalive 在什么时候做什么?
一条连接长时间没有传输时,操作系统可以在启用相关选项的条件下发送探测。探测次数、间隔和开始时间,依赖系统与配置。
这是为了在部分空闲失效场景下发现对端不可达,并不是为了持续请求业务接口。Linux 的具体选项可核对 tcp(7)。
连接正在传输数据时,还有其他超时与重传机制。不要把所有断线检测都说成 Keepalive,也不要背一个默认时长后认为任何环境都相同。
为什么 TCP 活着,业务却可能卡住?
假设应用服务还在,操作系统可以回应 TCP 探测,但处理请求的工作线程或数据库连接全部在等待。
此时传输层探测可能正常,业务仍然超时。因为 Keepalive 没有执行“查订单”这条路径,也不知道我们期望的延迟是多少。
应用层心跳或健康检查也要定义范围。只返回一个固定 OK,不能证明数据库、权限系统和全部业务能力健康;检查过重,又可能给故障中的系统增加压力。
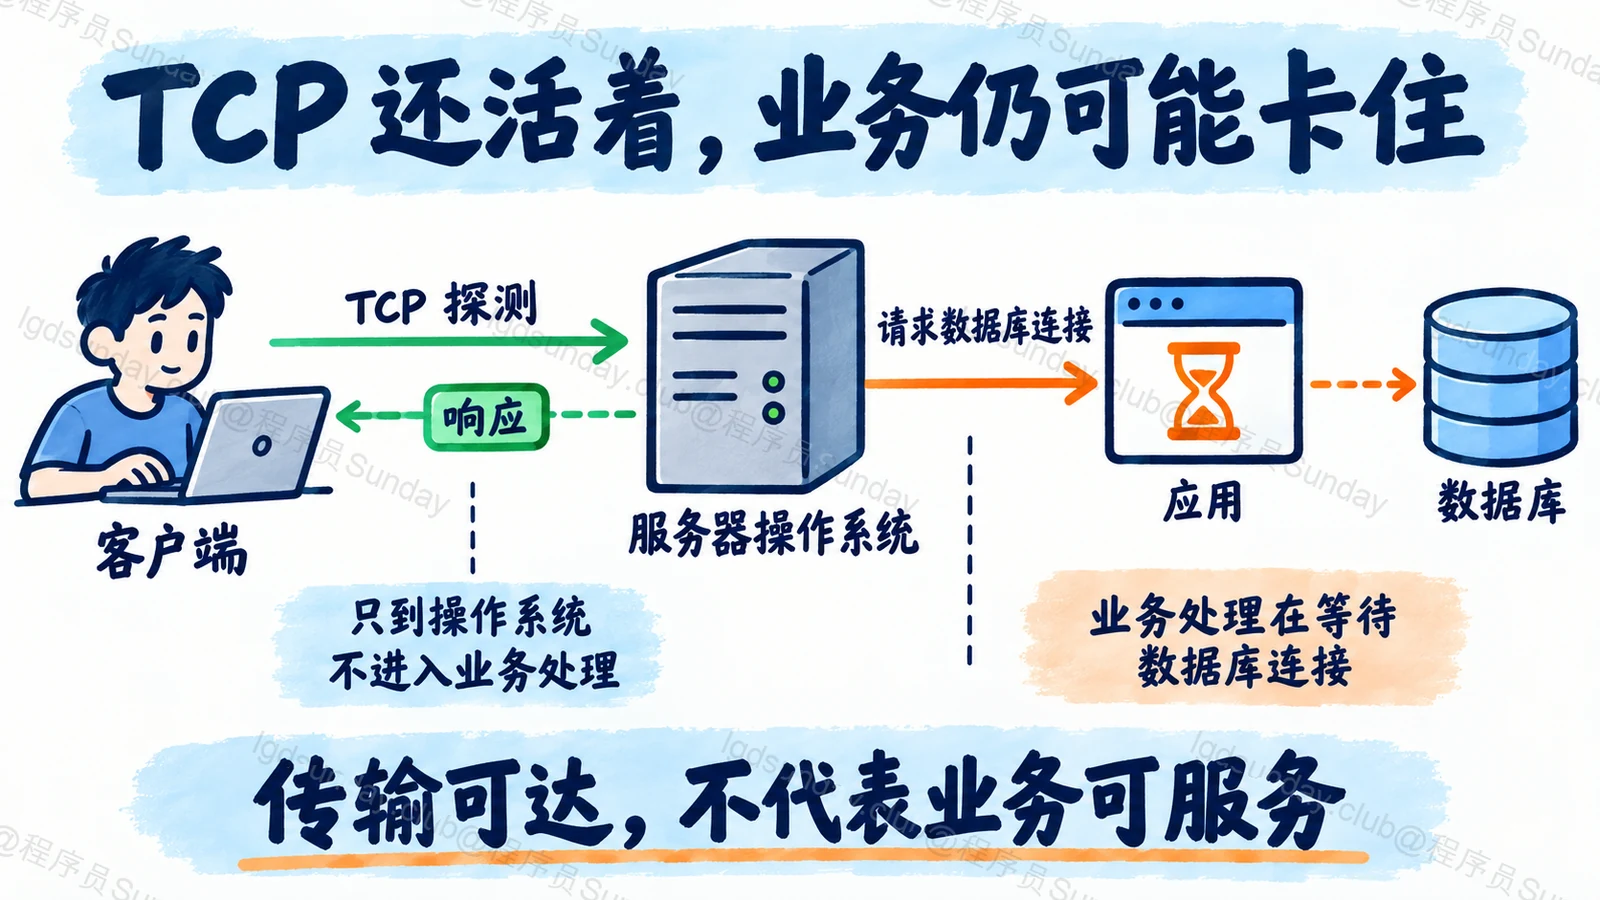
图:TCP 还活着,业务仍可能卡住。
代理会让“同一条连接”变得更复杂
浏览器到代理、代理到后端,可能是不同的连接。前一段还保持着,不代表后一段也保持着。
因此,排查空闲后第一次请求失败,要对照各段连接池、空闲超时和关闭行为。某一侧缓存了已经被另一侧关闭的连接,就可能在下一次使用时遇到错误。
重试也不是随手再发一次。如果请求有副作用,需要先判断是否可以安全重试,不能用连接问题替代幂等设计。
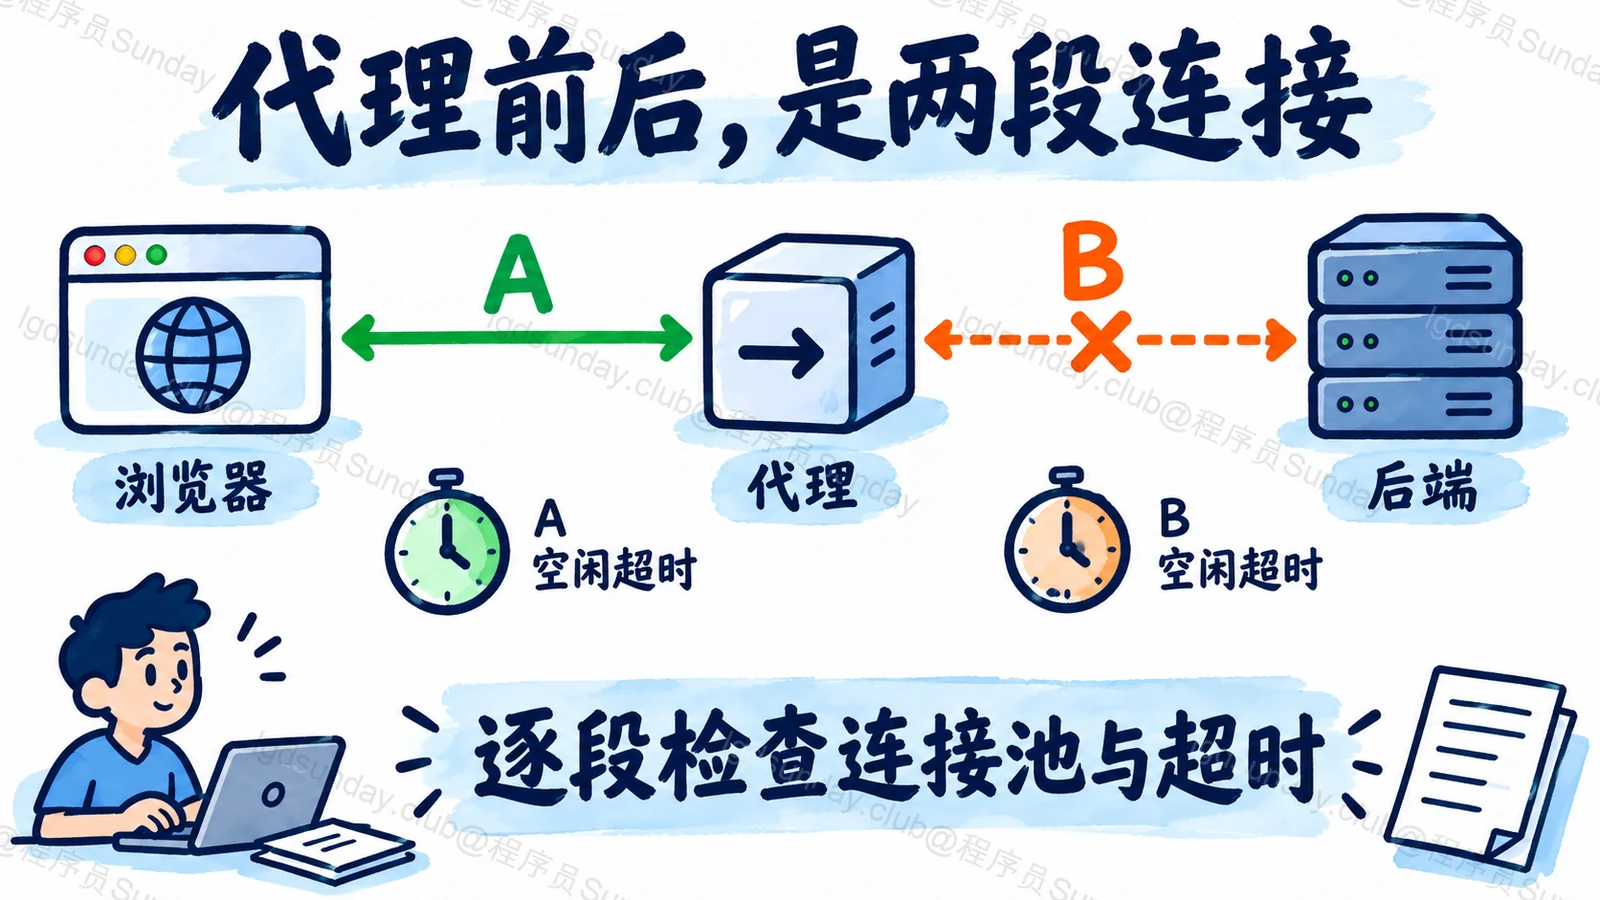
图:代理前后,是两段连接。
面试官继续追问
Keepalive 可以取代业务超时吗?
不能。它关注特定空闲失效检测,业务请求需要自己的截止时间。否则连接存在但服务迟迟不返回,用户还是会无限等待。
配置得越频繁越好吗?
不一定。更频繁会增加探测与资源成本,也要考虑网络和代理行为。先明确需要发现哪种失效、希望多久发现,再选择参数。
面试速记卡
- HTTP 持久连接:尽可能复用连接承载后续请求。
- TCP Keepalive:启用后的传输层空闲探测。
- 应用心跳:按应用协议表达状态,不是同一机制。
- 健康:TCP 可达不等于业务可服务。
- 排查:客户端、代理、后端的连接与超时逐段检查。
公司面试真题
真题根据求职者公开面经整理,题意经过概括,非逐字原话或公司官方题库;本文为 Sunday 的独立解析。
字节跳动 · 后端(番茄小说) · 实习
HTTP 连接建立后,每次请求都需要重新建立 TCP 连接吗?(题意整理)
【字节跳动】番茄小说部门 后端实习 ↗
面试记录为 2021 年 1 月;原帖发布于 2022-04-29