
Kubernetes HPA 如何自动扩缩容?为什么 CPU 很高却没有增加 Pod?
下面是一段教学模拟,不是真实面试记录。
🧑💻 面试官:CPU 很高,HPA 为什么不扩容?
🙋♂️ 我:可能达到 maxReplicas。
🧑💻 面试官:还没达到呢?CPU 百分比相对 limit、节点总量,还是 request?
🙋♂️ 我:通常相对 request。
🧑💻 面试官:再区分:HPA 没要求增加,和要求增加但 Pod 一直 Pending,是同一个故障吗?
分成「取得指标」「作出决定」「新副本运行」三段排查,不能只看一个 CPU 图。
面试速答(60 秒版)
HPA 根据当前指标与目标值的比例,调整工作负载的期望副本数。常见 CPU 利用率目标以 request 为基准,不是直接看 limit。
CPU 高却没有增加副本,要检查指标服务、相关容器的 request、副本上限,以及扩缩容策略和稳定相关约束。
还要区分期望数与运行数。已经要求增加,但节点资源不足导致 Pod Pending,就继续查调度与集群容量。
HPA 增加副本,不会自动解决数据库瓶颈或外部接口限额。对于 I/O 等待型服务,CPU 也未必是合适的扩容指标。
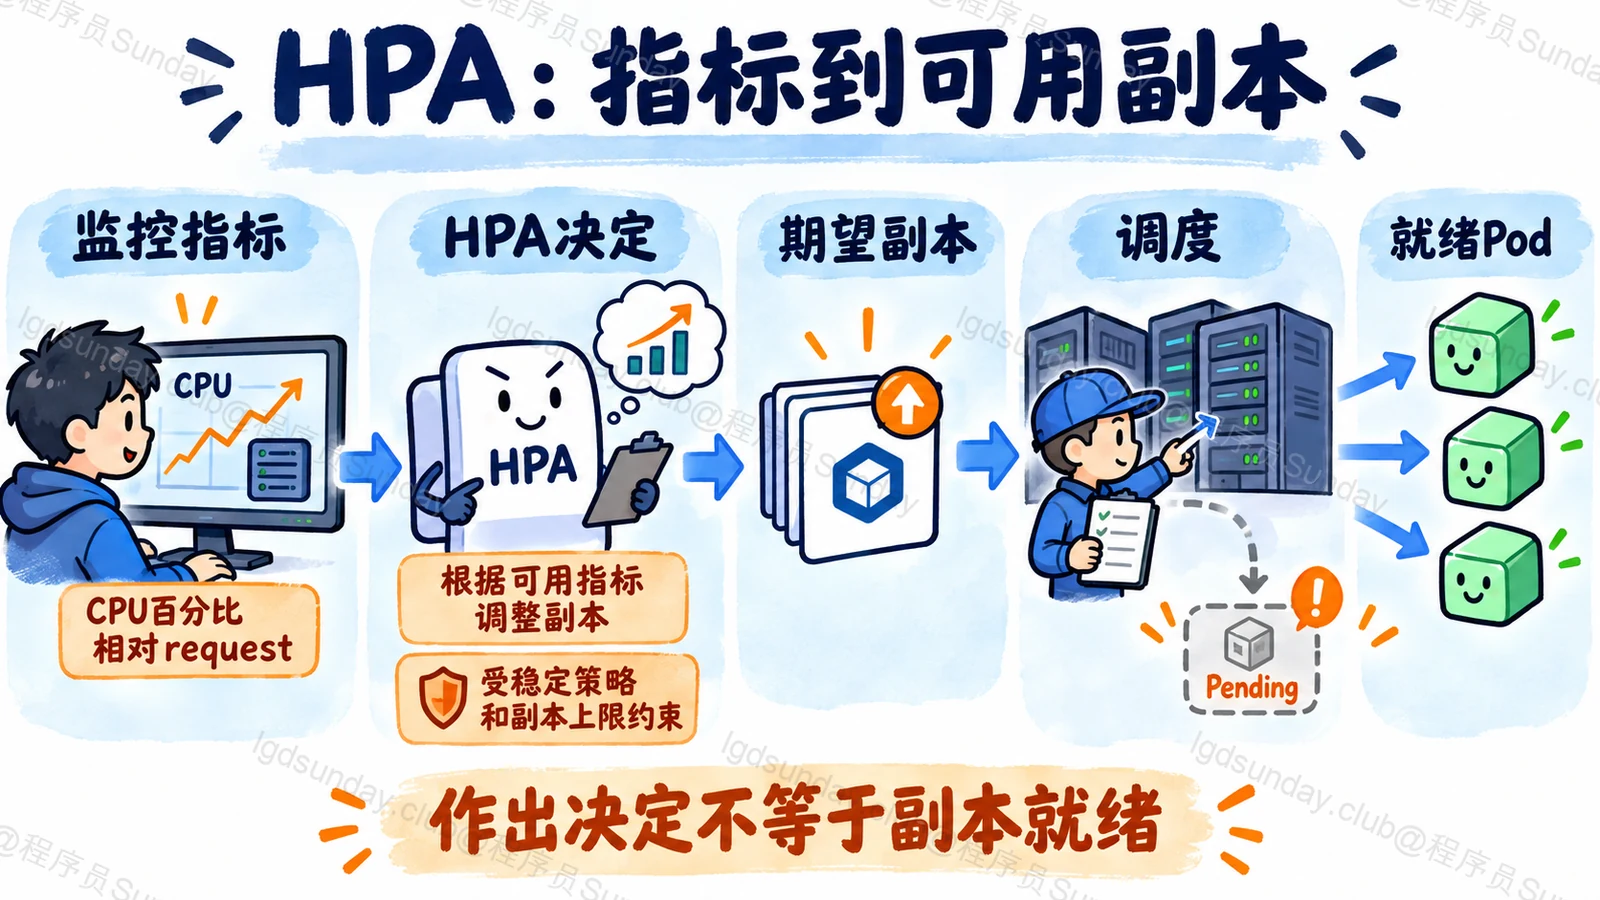
知识点详解:从指标到可用实例,中间还有几步?
先比较当前值与目标值
简化公式是:
期望副本数 = 向上取整(当前副本数 × 当前指标 / 目标指标)。
假设两个 Pod 的 request 相同,当前平均利用率 100%,目标 50%,简化计算得到四个副本。
实际控制器还要处理容差、缺失指标、未就绪 Pod 与策略限制,不能保证立即按简单公式调整。官方 HPA 算法
CPU 百分比,先找分母
容器 request 是 500m,当前使用 250m,相对 request 就是 50%。如果 limit 是 1000m,相对 limit 则是 25%。
两张图不矛盾,但不能拿第二个百分比直接对比 HPA 的利用率目标。
相关容器没有 request,某些利用率计算就无法成立。容器级与自定义指标还有各自规则,应按实际配置确认。
没扩容,是没算出来还是受到限制?
先看 HPA conditions:有没有取得指标、识别工作负载并满足调整条件。
再看最小最大副本、扩缩容策略与稳定配置。扩容和缩容不必使用同一规则,不能把常见缩容窗口说成所有扩容都必须等待一样时间。
缺失和未就绪样本也可能使计算保守。需要查判断依据,而不是只看控制器有没有报异常。
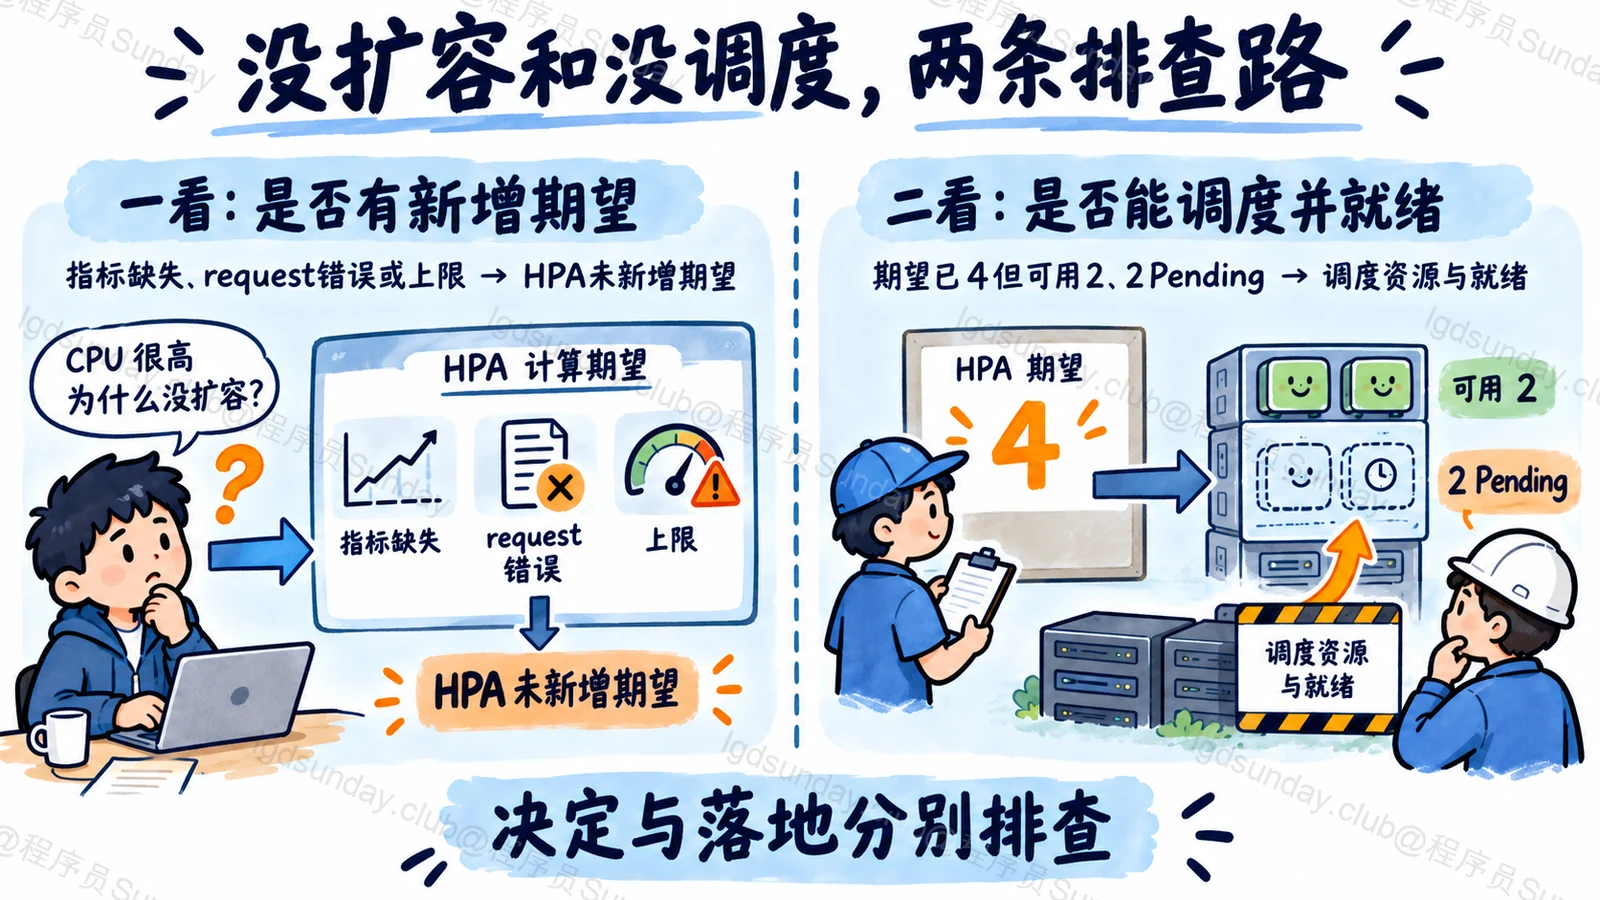
期望四个,不等于可用四个
HPA 调整规模后,工作负载控制器创建 Pod,调度器还要找节点。
资源、亲和性、配额或镜像问题都可能让 Pod 不能就绪。此时决定已经做出,故障在后面。
节点自动扩容是另一层能力,HPA 不提供无限节点。即使副本都运行,下游容量不变,系统也可能继续慢。
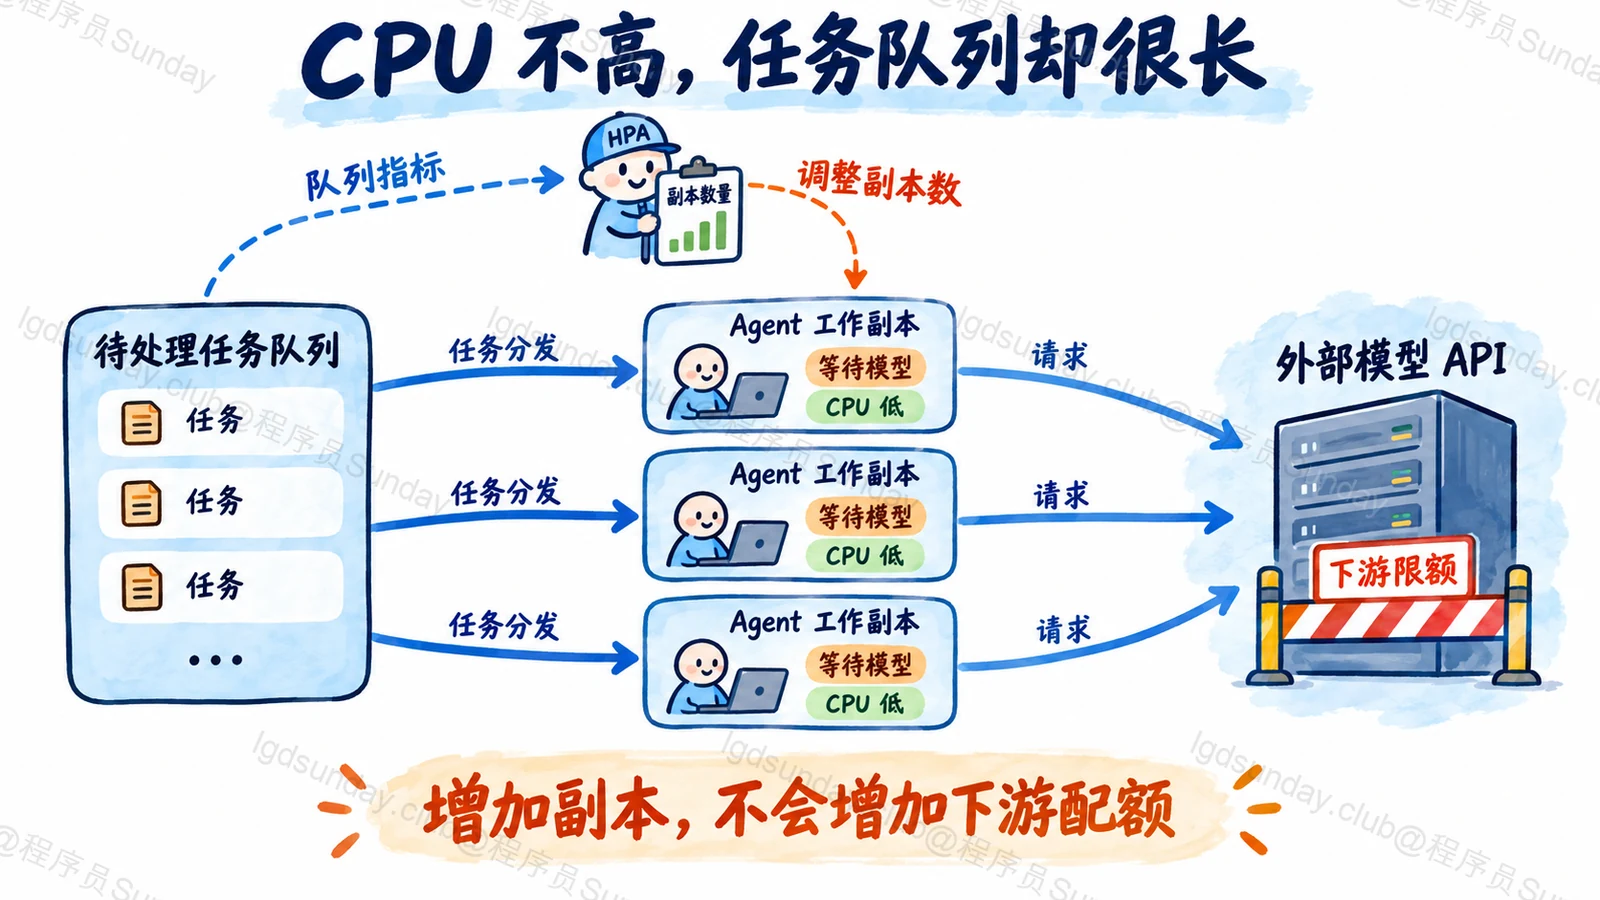
CPU 低但队列很长,怎么办?
假设 Agent 服务主要等待模型 API,CPU 不高,但待处理请求持续增加。
可以评估队列长度、在途工作等指标,同时结合下游限额。更多副本如果只引发更多限流与重试,未必改善体验。
指标应表达真实工作压力,不是只因为 CPU 最方便就固定使用。
面试官继续追问
request 越小,扩容越敏感,是不是更好?
不是。它影响调度与利用率意义,过小可能扭曲判断,应依据资源需求和实际测试设置。
副本增加但接口仍慢,说明 HPA 无效吗?
不一定。检查就绪、负载分布和下游瓶颈。扩容成功与性能改善分别验证。
平均 CPU 会掩盖热点吗?
可能。还要看流量不均、热点任务和分区压力,不能只依赖平均值。
面试速记卡
- HPA:按指标与目标比例调整期望副本数。
- CPU 基准:常见利用率相对 request,不是 limit。
- 无决定:查指标、request、上下限与调整规则。
- 未落地:查调度、资源与就绪状态。
- 系统边界:副本增加不等于下游容量增加。
公司面试真题
这道题暂未收录可核验的公司真题来源。你可以先阅读本文解析,或浏览已收录的公司面试真题。
浏览公司面试真题 →