
Kubernetes 三种探针有什么区别?存活、就绪和启动检查失败后会怎样?
下面是一段教学用的模拟面试。
🧑💻 面试官:Kubernetes 的 liveness、readiness 和 startup 探针怎么分?
🙋♂️ 我:存活判断进程是否正常,就绪判断能不能接请求,启动判断应用有没有启动好。
🧑💻 面试官:readiness 失败,会重启容器吗?应用启动要两分钟,liveness 十秒就开始检查,会有什么问题?
🙋♂️ 我:readiness 不负责重启;启动慢时,需要避免被存活探针提前杀掉。
🧑💻 面试官:那数据库短暂不可用,三个探针都返回失败,是更保险,还是把服务反复重启了?
先说失败后要采取什么动作:「继续等启动、暂时不接流量,还是重启恢复」。
面试速答(60 秒版)
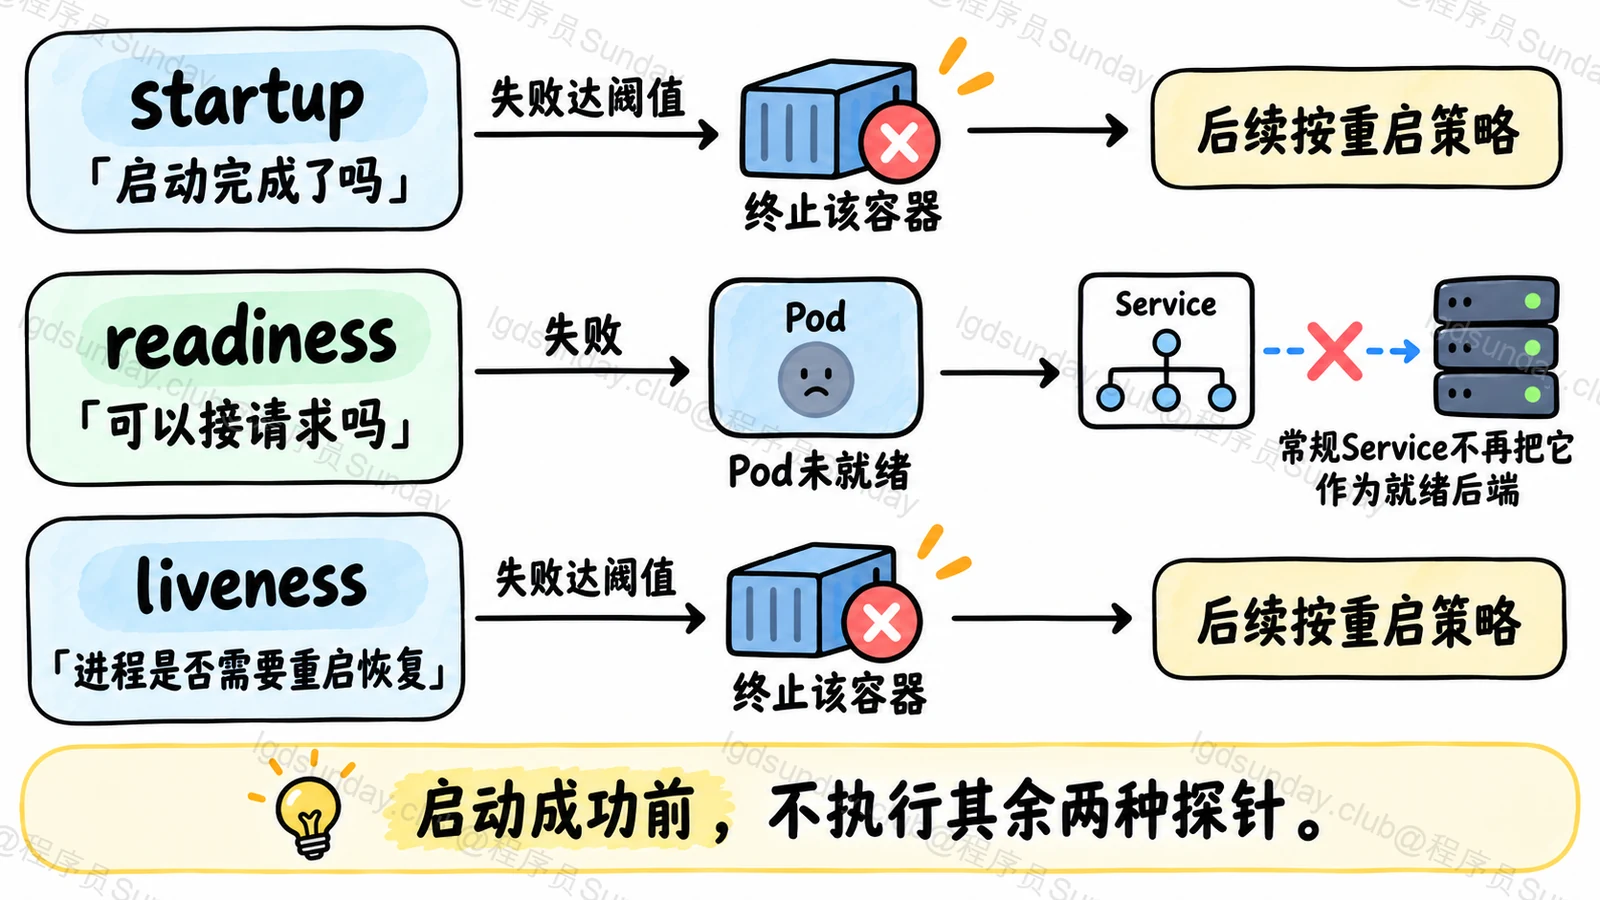
startupProbe 给应用启动阶段一个独立检查。配置它以后,在启动探针成功前,存活和就绪探针不会开始执行;启动检查持续失败达到阈值时,会终止相应容器,再按重启策略处理。
readinessProbe 判断当前是否适合接流量。失败会让 Pod 不再作为常规 Service 流量的就绪后端,但不会仅因为就绪失败就重启容器。
livenessProbe 判断是否需要通过重启恢复。失败达到阈值时,kubelet 会终止相应容器,并按重启策略处理。因此,不能把所有外部依赖故障都塞进存活检查,避免一个数据库问题引发所有实例反复重启。探针内容与时间预算都要按应用真实状态设计。
知识点详解:应用启动慢,和应用卡死,是两种问题
探针在问谁,谁来执行动作?
假设咱们把一个 API 服务放在 Pod 里运行。进程还在,不代表它已经能接请求,也不代表重启就能解决当前问题。
探针由 kubelet 对相应容器执行诊断,可以通过 HTTP、TCP、exec 或 gRPC 等方式检查。检查结果交给对应机制处理,而不是应用自己看到失败就必须退出。
三种探针可能都使用 HTTP 接口,但接口相似不代表职责相同。真正需要区分的是判断目标与失败后的动作。Kubernetes 探针文档说明了这些规则。
启动探针,避免还没开门就被判坏
假设服务启动时需要加载配置和预热数据,正常要一段时间。
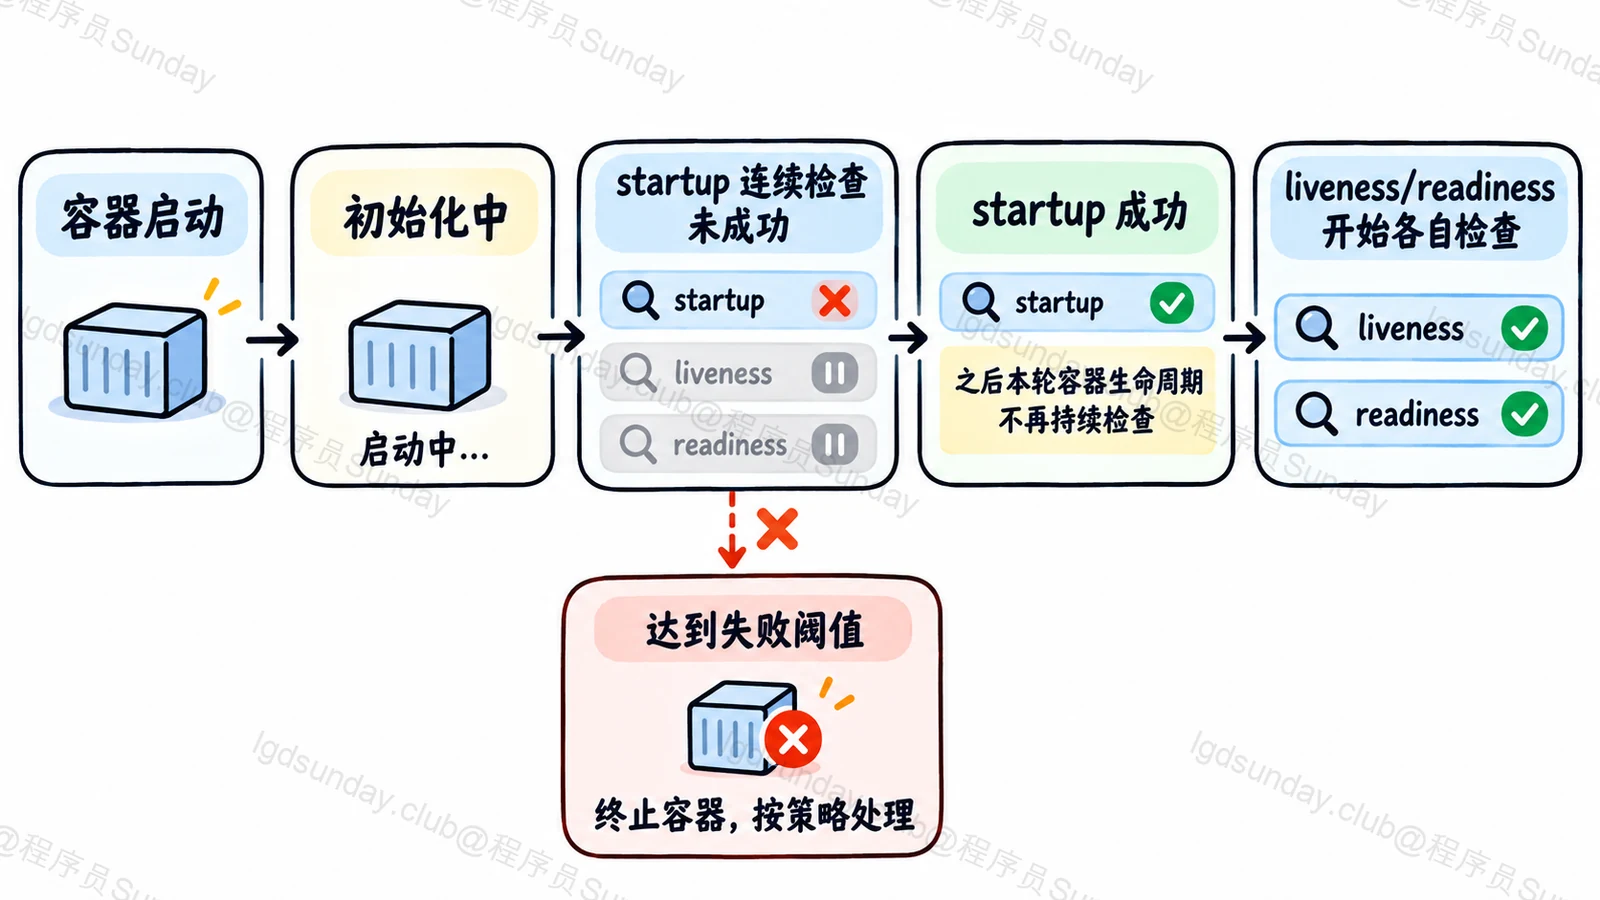
如果存活探针太早开始,并把“还没准备好”当成故障,容器可能在每次启动过程中被杀掉。它又重新启动,再被同一个检查杀掉,始终走不到可用状态。
startupProbe 可以先判断启动是否完成。在成功之前,liveness 和 readiness 被这个启动阶段挡住,不会提前参与检查。
启动成功后,才进入正常的存活与就绪检查。启动探针不是每次业务请求都重复执行的健康判断,也不替后续阶段永久担保。
给它的预算应覆盖合理的启动长尾,同时仍能发现真正卡在启动阶段的实例。预算可以结合 failureThreshold 与 periodSeconds 等估算,但精确触发时刻还受初始延迟、检查耗时与调度影响,不能当成严格秒表。
就绪失败,是先把流量绕开
假设服务已经启动,但当前正在恢复某项必要连接,暂时不能正确处理请求。
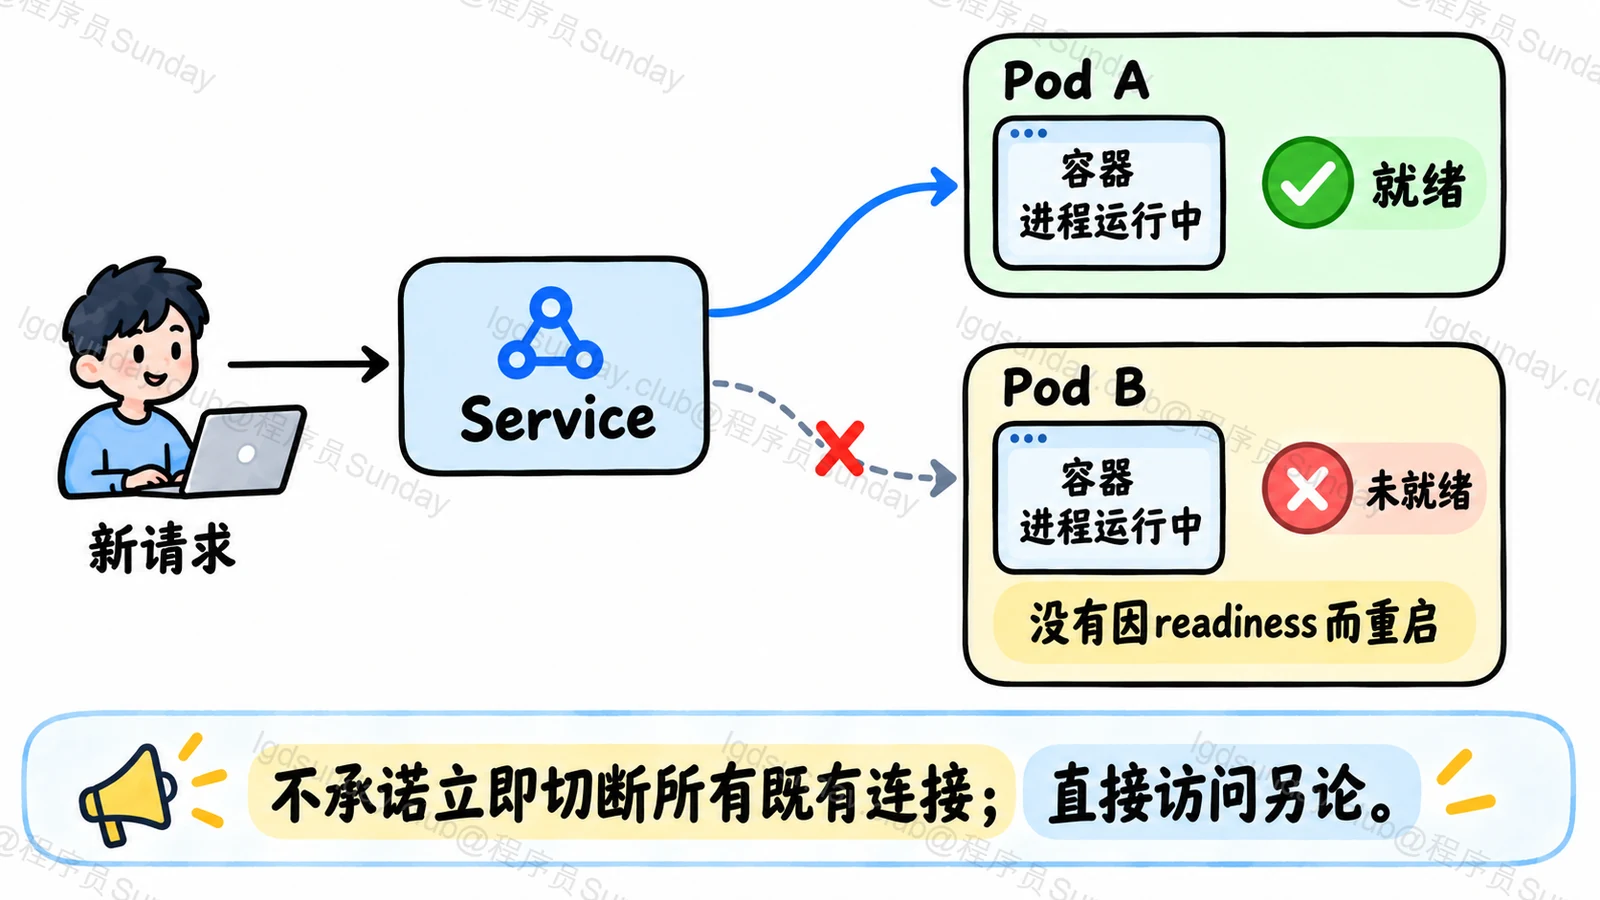
readiness 返回失败,可以让这个 Pod 不再作为常规 Service 流量的就绪后端。其他就绪实例继续承担请求,当前容器可以留着恢复。
这里的“摘流量”不是瞬间撤销所有网络连接,也不保证所有访问方式都消失。已有请求、直连 Pod,以及特殊的 Service 或流量配置,需要分别理解。
所以,就绪失败后还需要考虑正在处理的请求怎么办。容器没有被重启,也不代表里面所有工作自动安全结束。
等它恢复并通过就绪检查,再重新进入相应流量范围。这适合某些可恢复的暂时状态,不必把它们全部转成重启。
存活失败,为什么需要特别谨慎?
假设进程陷入无法自行恢复的卡死,重启可能让服务重新取得进展。这才是 liveness 常见的使用目的。
达到失败阈值后,kubelet 会终止对应容器,再依据 restartPolicy 等规则决定后续处理。常见服务工作负载使用可重启策略,但不能省略这些条件,断言任何 Pod 都一定无限重启。
它通常重启的是相应容器,不是因为一次探针失败就必然删除并重建整个 Deployment。
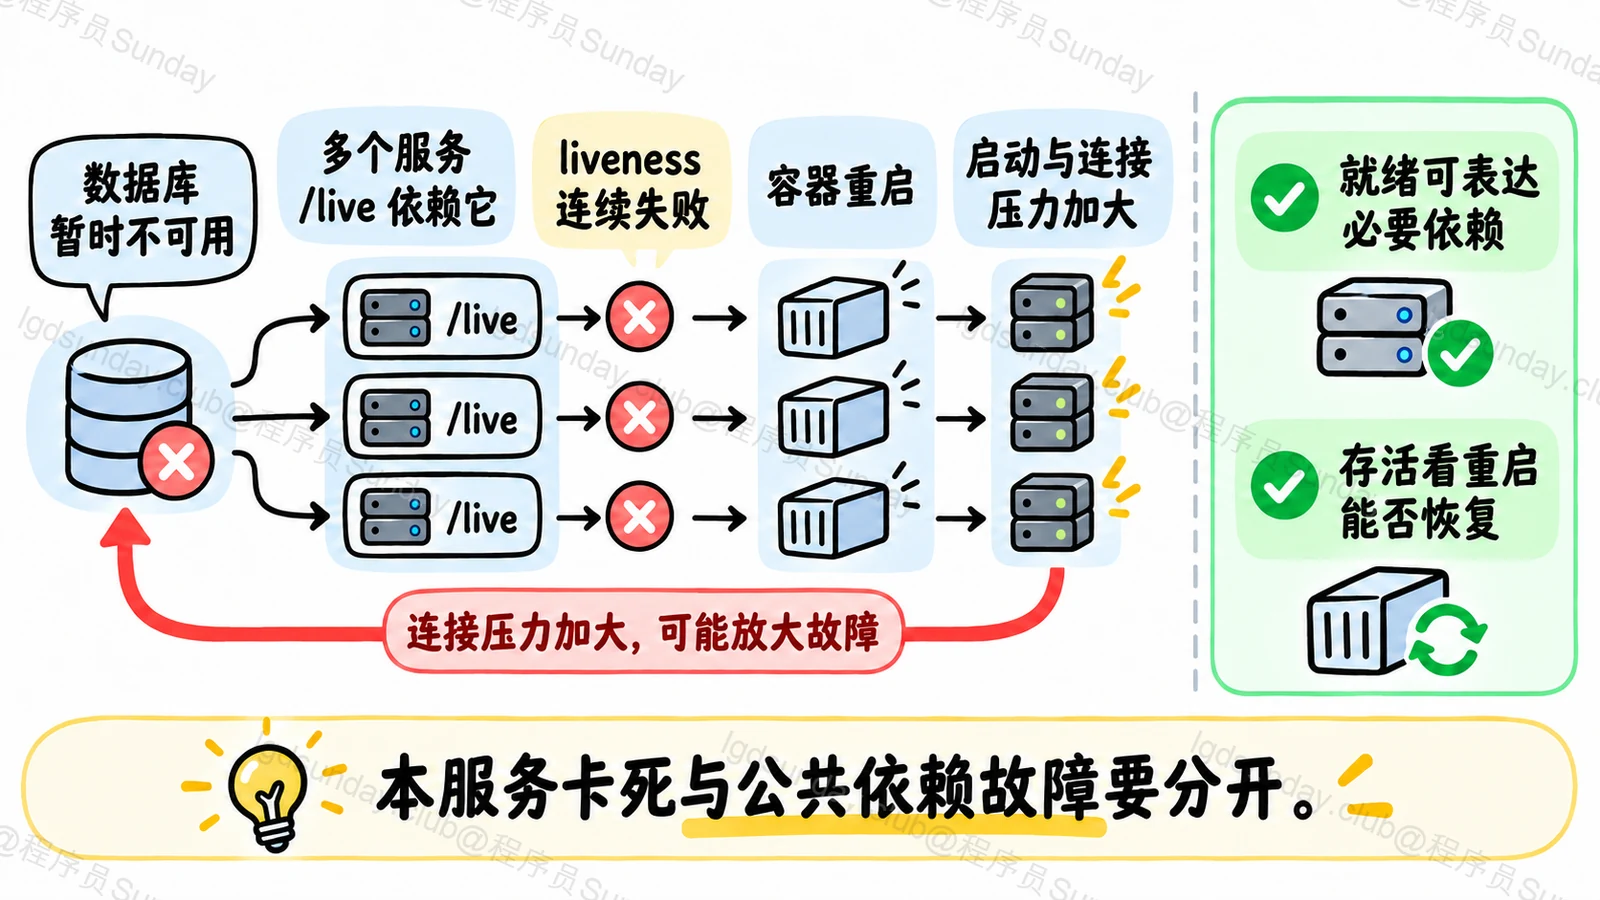
如果把数据库可用性作为所有实例的存活条件,数据库短暂故障时,整个服务可能开始一轮轮重启。重新连接和预热又增加依赖压力,恢复反而更困难。
外部依赖是否影响 readiness,也要看当前服务是不是完全不能接任何有用请求。有合法降级能力时,判断可能不同。不要把“查得越深越保险”当成探针设计原则。
三个接口,应该表达三种状态
可以把接口职责理解成下面这样,而不是直接把它们全部代理到同一个深度检查。
| 状态 | 要回答的问题 | 失败后主要动作 |
|---|---|---|
| 启动 | 初始化是否已经完成? | 持续失败达到阈值,终止并按策略处理 |
| 就绪 | 当前适不适合接常规流量? | 标记不就绪,不因此直接重启 |
| 存活 | 当前是否需要通过重启恢复? | 失败达到阈值,终止并按策略处理 |
检查还应该足够轻量,响应结构清楚。健康接口本身很慢,可能在高负载时制造假故障;每次都执行昂贵外部查询,也可能让检查成为新的负担。
本文不提供一份声称适合所有服务的固定 YAML。路径、端口、时间预算和失败条件,应来自应用设计与真实测试,不能复制一个数值就认定可以上线。
怎样验证没有“越检查越糟”?
在测试环境分别制造启动较慢、暂时无法接请求、进程卡死和依赖短暂故障。
检查启动阶段是否有完整机会、就绪失败是否只改变接流量资格、存活失败是否按预期触发容器处理,以及依赖恢复后有没有不必要的重启风暴。
再看 Pod Events、探针失败原因、容器重启次数和流量结果。不是健康接口返回一次 200,就证明三个阶段都正确。
面试官继续追问
readiness 失败,为什么进程还在?
这是设计职责:它改变接流量资格,不负责直接重启。应用可以留在原地恢复相应状态。
startup 成功了,以后还会再帮应用判健康吗?
后续阶段交给存活与就绪检查。容器再次启动时会重新经历启动阶段,但不能把一次成功当成永久健康证明。
TCP 端口能连接,就说明业务正常吗?
只能证明对应检查条件满足。端口接受连接,不保证业务依赖、请求处理与响应内容都符合要求,探针需要匹配自己真正想判断的能力。
面试速记卡
- startup:先确认启动完成,成功前挡住 liveness 与 readiness。
- readiness:调整接常规 Service 流量的资格,不因此直接重启。
- liveness:判断是否需要重启恢复,达到阈值后按容器策略处理。
- 依赖故障:不一律变成存活失败,避免重启与依赖压力互相放大。
- 验证:慢启动、暂时不就绪、卡死与依赖恢复分别测试。
公司面试真题
这道题暂未收录可核验的公司真题来源。你可以先阅读本文解析,或浏览已收录的公司面试真题。
浏览公司面试真题 →