
FastAPI BackgroundTasks 和 Celery 有什么区别?耗时任务应该放在哪里执行?
下面是一段教学模拟,不是真实面试记录。
🧑💻 面试官:上传文件后,需要处理十分钟,接口怎么返回?
🙋♂️ 我:放进 BackgroundTasks,立即返回成功。
🧑💻 面试官:服务两分钟后重启,剩下的工作谁继续?
🙋♂️ 我:那得使用任务队列。
🧑💻 面试官:用了 Celery 就能保证任务只执行一次吗?返回成功,表示处理完成还是只表示受理?
先问「任务要不要脱离当前服务进程存活」,再选工具。提前返回响应,不等于已经获得可靠执行保证。
面试速答(60 秒版)
BackgroundTasks 在响应发送后执行附加任务,仍由当前应用进程承载,适合较轻、能够接受这种生命周期的工作。
Celery 将任务交给消息系统和独立 Worker,适合耗时处理、独立扩容以及需要重试和任务管理的场景,但要引入额外部署与配置。
进程内后台任务不会自动变成持久队列;Celery 也不是天然只执行一次,任务仍可能重试或重复投递,需要幂等处理。
设计接口时,应区分受理和完成:先保存必要的任务记录,返回任务 ID,再提供状态查询。选择依据是可靠性、资源与生命周期要求,而不只是任务要等几秒。
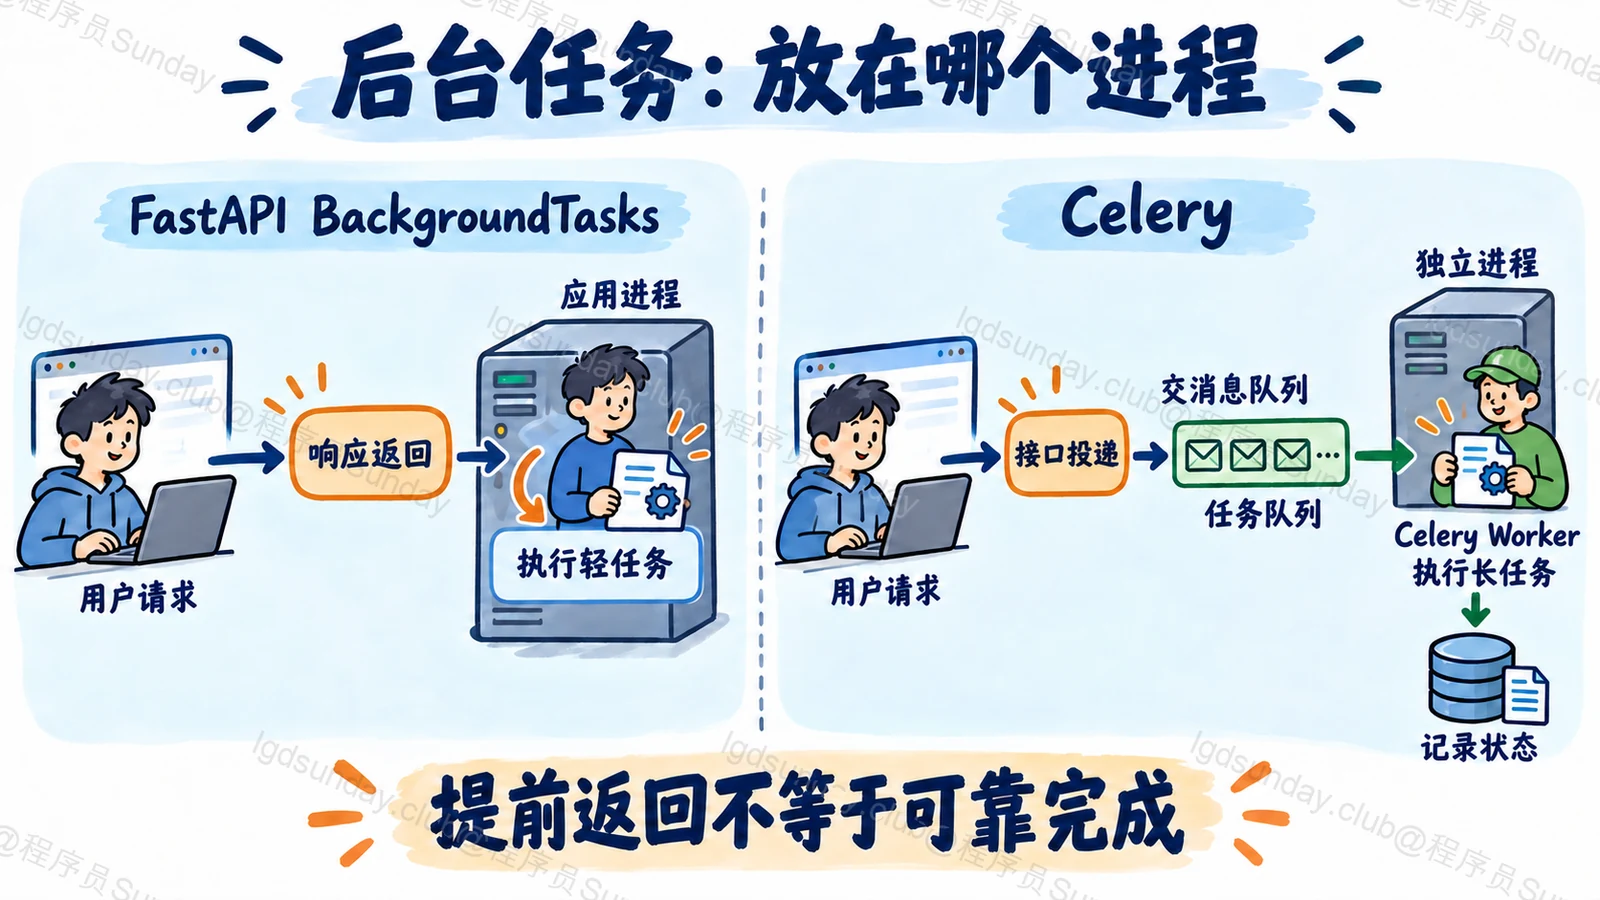
知识点详解:把任务放到响应后面,究竟改变了什么?
BackgroundTasks 改的是等待位置
假设接口保存一条记录后,还要发送一封非关键提醒邮件。用户不需要一直等邮件服务,便可以把提醒安排在响应之后。
请求响应变快了,但工作仍由应用进程执行。如果进程退出,任务并不会自动在另一台机器重新出现。FastAPI 说明
同步函数与异步函数的执行方式也不同。Starlette 会将相应同步后台工作放在线程池;异步函数则仍需要正确使用非阻塞操作。把 CPU 密集循环写进 async 函数,不会因此获得一个独立计算进程。线程池说明
所以,不要把“后台”误解成“与接口资源完全隔离”。
Celery 增加独立的任务执行链路
换成大型文件处理,我们可以让接口提交任务,Worker 从消息系统接收并执行。
这时 Web 服务和计算服务可以独立部署,任务的等待与执行也不必绑在当前请求进程上。代价是需要管理 broker、Worker、结果与故障恢复。
可靠性取决于实际消息持久化、确认时机和 Worker 配置,不是安装 Celery 包就自动完成。任务状态保存在哪里、保存多久,也应明确设计。Celery 任务文档
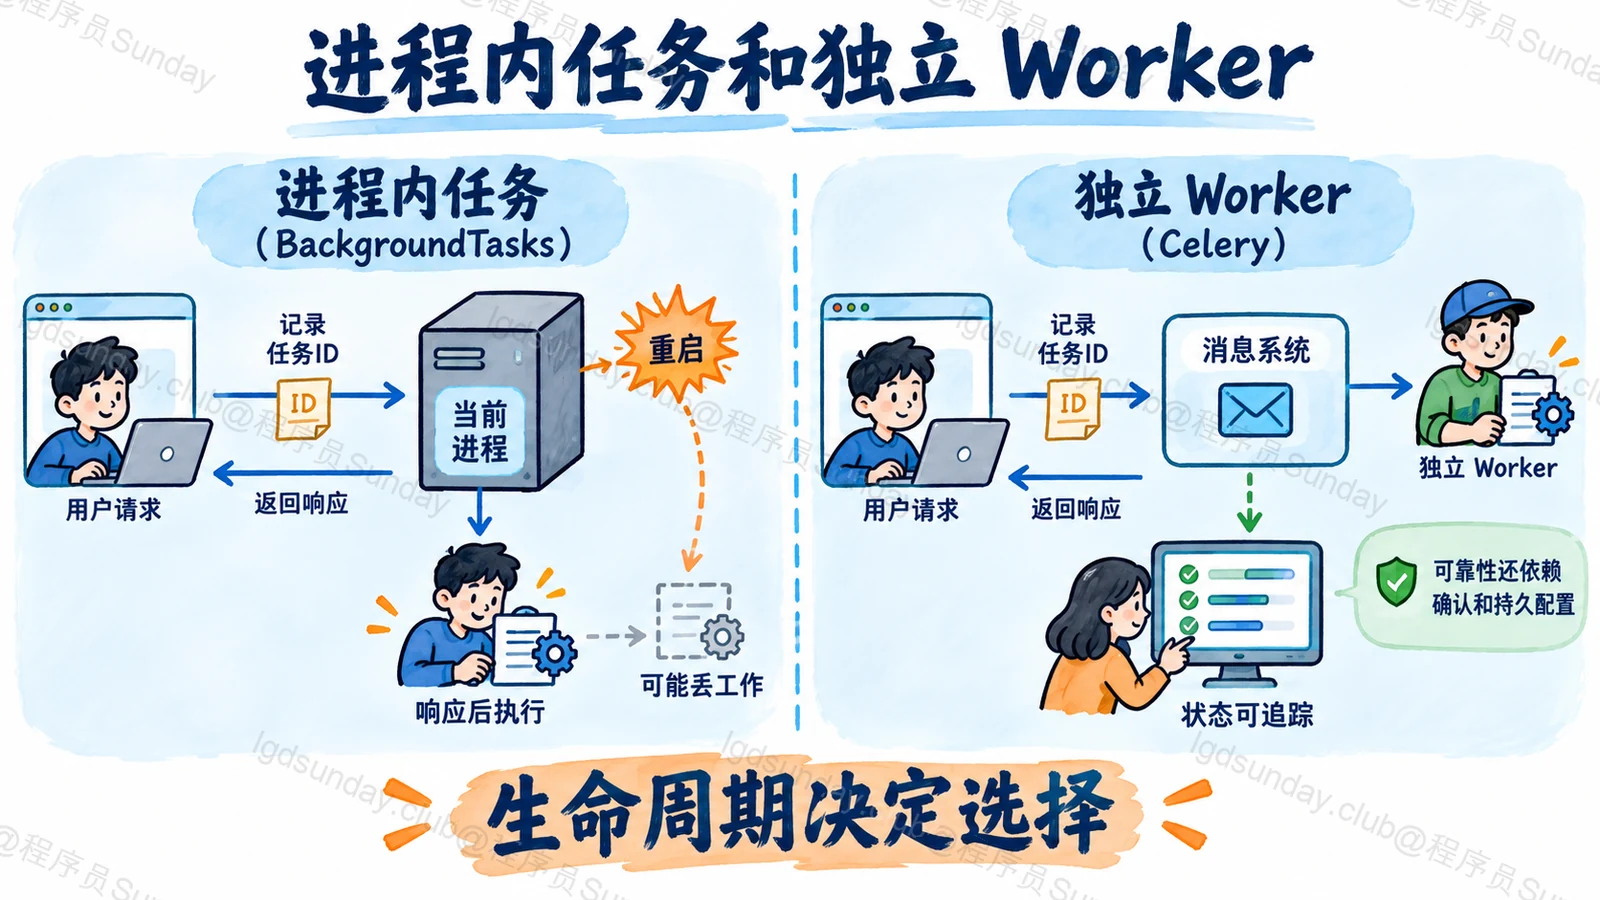
有队列,为什么仍然要考虑重复?
假设 Worker 已经生成报告并上传,但确认消息之前连接断开。系统后来可能再次执行同一个任务。
如果任务每次都新建一份报告,用户可能收到重复内容。更稳妥的是使用稳定业务任务 ID,检查对应阶段的完成状态,并让关键写入具有幂等性。
但不要只在内存里放一个“执行过”集合:进程重启后它就没了,也无法协调多个 Worker。幂等记录与业务写入需要有一致的保存规则。
同样,失败重试也要分类。临时网络问题可以按预算重试,格式错误或权限拒绝通常不能靠反复执行修复。
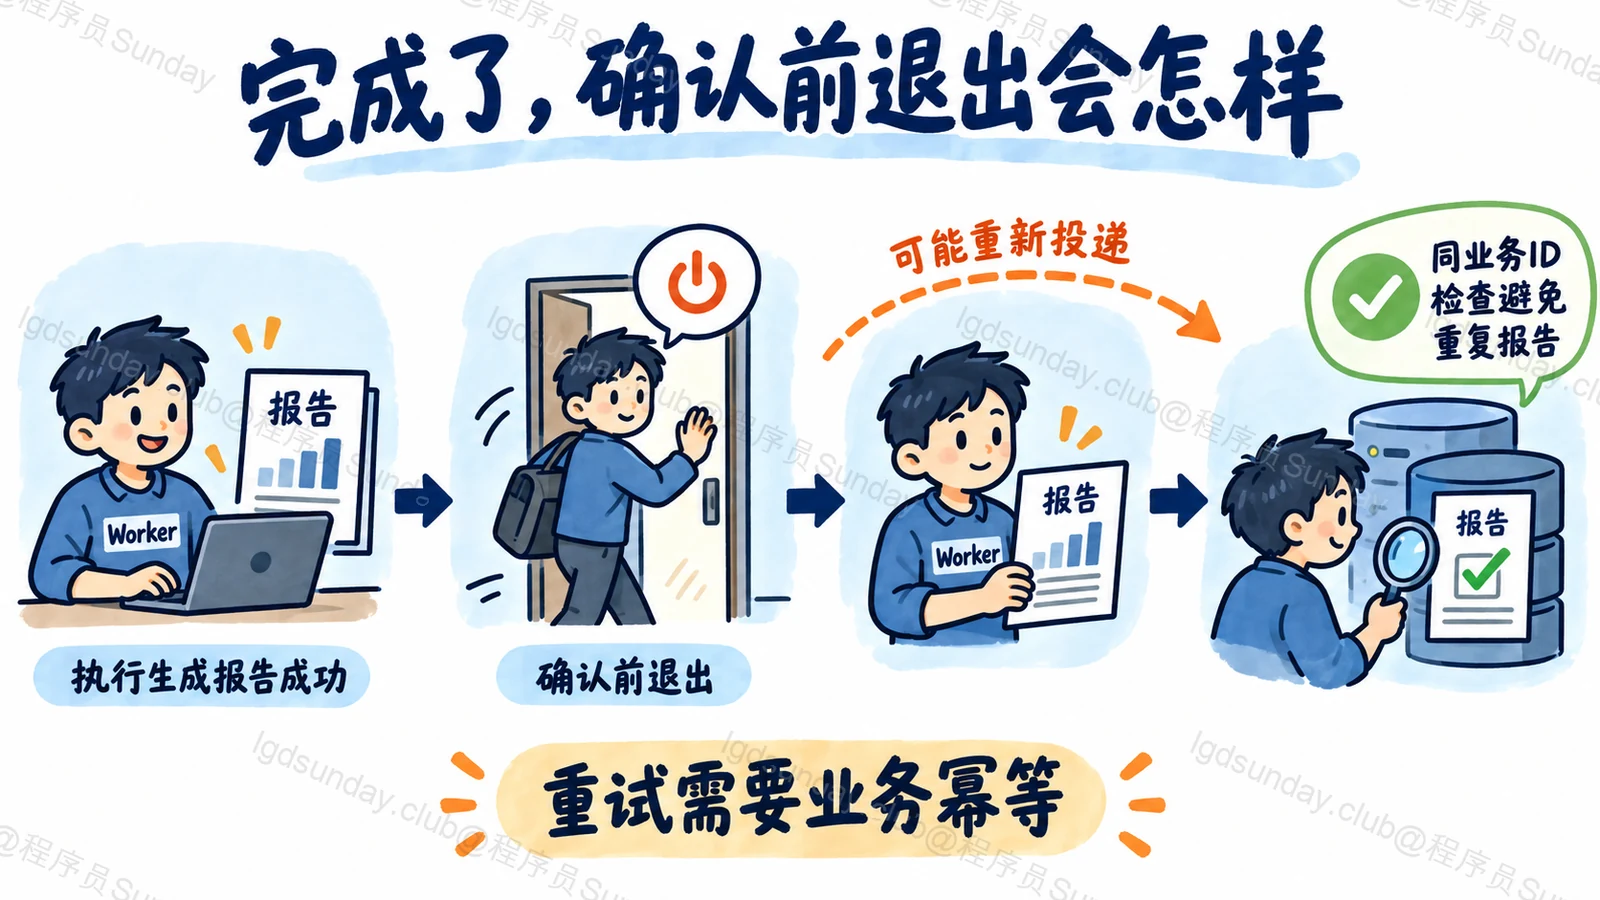
返回任务 ID,比假装完成更清楚
一个合理接口可以表达:任务已受理、正在运行、成功或失败。受理之后,用户用任务 ID 查询状态,而不是一直保持原请求。
保存任务记录与投递消息之间也可能失败:记录成功但消息未发出,或者消息已发出但响应丢失。重要任务需要可靠投递设计,例如结合事务内的待投递记录,并提供补投检查;不能用一句“返回 202”跳过这个窗口。
Python 的 FastAPI 与 Celery 有各自真实 API。TypeScript 后端可使用合适的队列库实现类似架构,但不是这两个框架的同名替代版。本文讨论执行边界,不机械翻译接口。
面试官继续追问
发邮件一定要用 Celery 吗?
不一定。先看邮件是否关键、允许怎样失败,以及是否需要跨重启恢复。轻量附加通知与必须投递的业务凭证,可以采用不同方案。
任务耗时长,但用户必须等待结果呢?
后台执行不改变用户需要结果的事实。可以返回可追踪任务、使用进度推送,或设计有限等待与后续查询,不能只把函数挪走却没有结果交付方式。
Worker 扩容越多越好吗?
不一定。数据库、外部 API 和 CPU 都有限制,需要控制并发与重试放大。队列能缓冲等待,不会凭空提高下游容量。
面试速记卡
- BackgroundTasks:响应后执行,仍依赖当前应用进程。
- Celery:消息与独立 Worker 承担任务执行,需要额外运维。
- 可靠性:确认、持久化与重试配置决定具体保证。
- 幂等:任务可能重复,关键操作不能假定只执行一次。
- 接口语义:受理不等于完成,保存任务 ID 与可查询状态。
公司面试真题
这道题暂未收录可核验的公司真题来源。你可以先阅读本文解析,或浏览已收录的公司面试真题。
浏览公司面试真题 →