
N+1 查询是什么?为什么一个列表接口会执行上百次 SQL?
下面是一段教学用的模拟面试。
🧑💻 面试官:一个接口只返回二十条文章,为什么执行了二十一条 SQL?
🙋♂️ 我:可能先查了文章列表,再给每篇文章分别查作者,这就是 N+1 查询。
🧑💻 面试官:那把二十次作者查询并发起来,算解决了吗?
🙋♂️ 我:只是减少等待,数据库收到的查询数量没有减少。
🧑💻 面试官:改成一个大 JOIN 就一定更好吗?如果还要查每篇文章的一百条评论,结果会变成多少行?
这道题先看查询为什么按记录数增长,再看减少往返以后,数据量有没有失控。
面试速答(60 秒版)
N+1 查询通常是先执行一次列表查询,再为列表中的每条记录分别查询关联数据。返回 N 条记录,就可能追加 N 次查询。
它经常出现在 ORM 的懒加载,或者循环里访问关联对象的地方。接口代码看起来很短,数据库却在反复收请求。
解决时,我会先从 SQL 日志确认查询模式,再根据关联关系选择批量预加载、IN 查询、JOIN,或请求级的批处理。同一批关联 ID 可以合并查询,再按 ID 组装结果。
同时,少查几次不代表一定更快。多个一对多关系一起 JOIN,可能把结果成倍放大;还要检查分页、返回字段、索引和连接池等待。重点是让查询次数与数据规模可控,而不是追求所有接口只有一条 SQL。
知识点详解:一次循环,为什么变成一串数据库请求?
N+1 是怎么发生的?
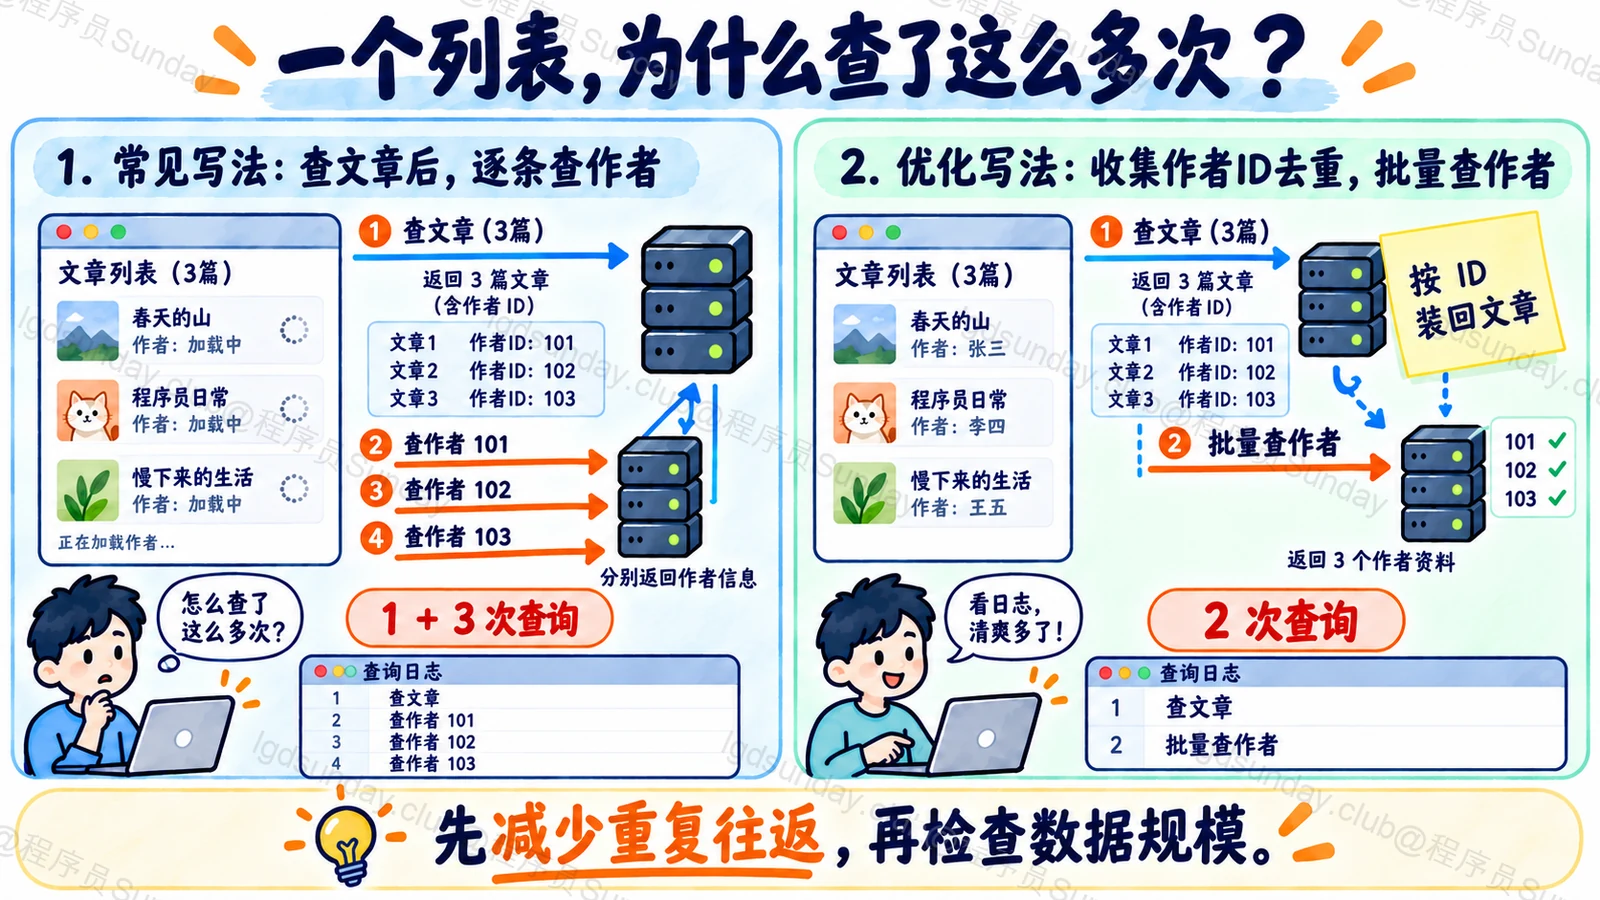
假设文章表里保存作者 ID。接口先查二十篇文章,再遍历列表,为每个作者 ID 查询作者资料。
第一次是查文章,后面的二十次是查作者。如果几篇文章属于同一个作者,甚至还会重复查询相同资料。
ORM 里的懒加载会让这个问题更隐蔽。访问 article.author 看起来像读取内存对象,实际可能触发 SQL。要判断它是否查询数据库,得看加载配置和最终日志,不能只看属性写法。
所以,N+1 描述的是查询模式,不是“使用 ORM 就一定慢”。手写 SQL 的循环也会造成同样的问题。
为什么并发查询没有真正解决?
把查询同时发出去,可能缩短接口等待时间,但数据库仍然需要处理二十个请求。每个请求都有连接、传输、解析和执行成本。
列表变大,或者接口被多人同时访问,连接池容易排队。原本二十次并发在本地很快,上线后却可能让其他接口一起等待。
并发可以是工具,但不能代替减少重复往返。
批量查询怎么做?
先查文章,收集并去重作者 ID。随后一次查询拿到这些作者,再建立“作者 ID → 作者资料”的映射,把结果装回文章。
SELECT id, title, author_id FROM article
ORDER BY id DESC LIMIT 20;

-- 参数来自前一步去重后的 author_id,实际使用参数绑定。
SELECT id, name FROM author
WHERE id IN (...);
这通常是两次查询。文章数量在合理范围内变化,不会再为每篇文章各查一次作者。ID 特别多时仍要分批,不能无限扩大 IN 条件。
批量方案还要处理作者不存在、记录无权访问、查询结果顺序不同。不能假设数据库返回的第一个作者,就对应第一篇文章。
JOIN 和预加载,应该怎么选?
对于文章与作者这种多对一关系,合理的 JOIN 可以直接返回需要的字段。作者表的主键不会让每篇文章多出一堆结果,通常比较容易控制。
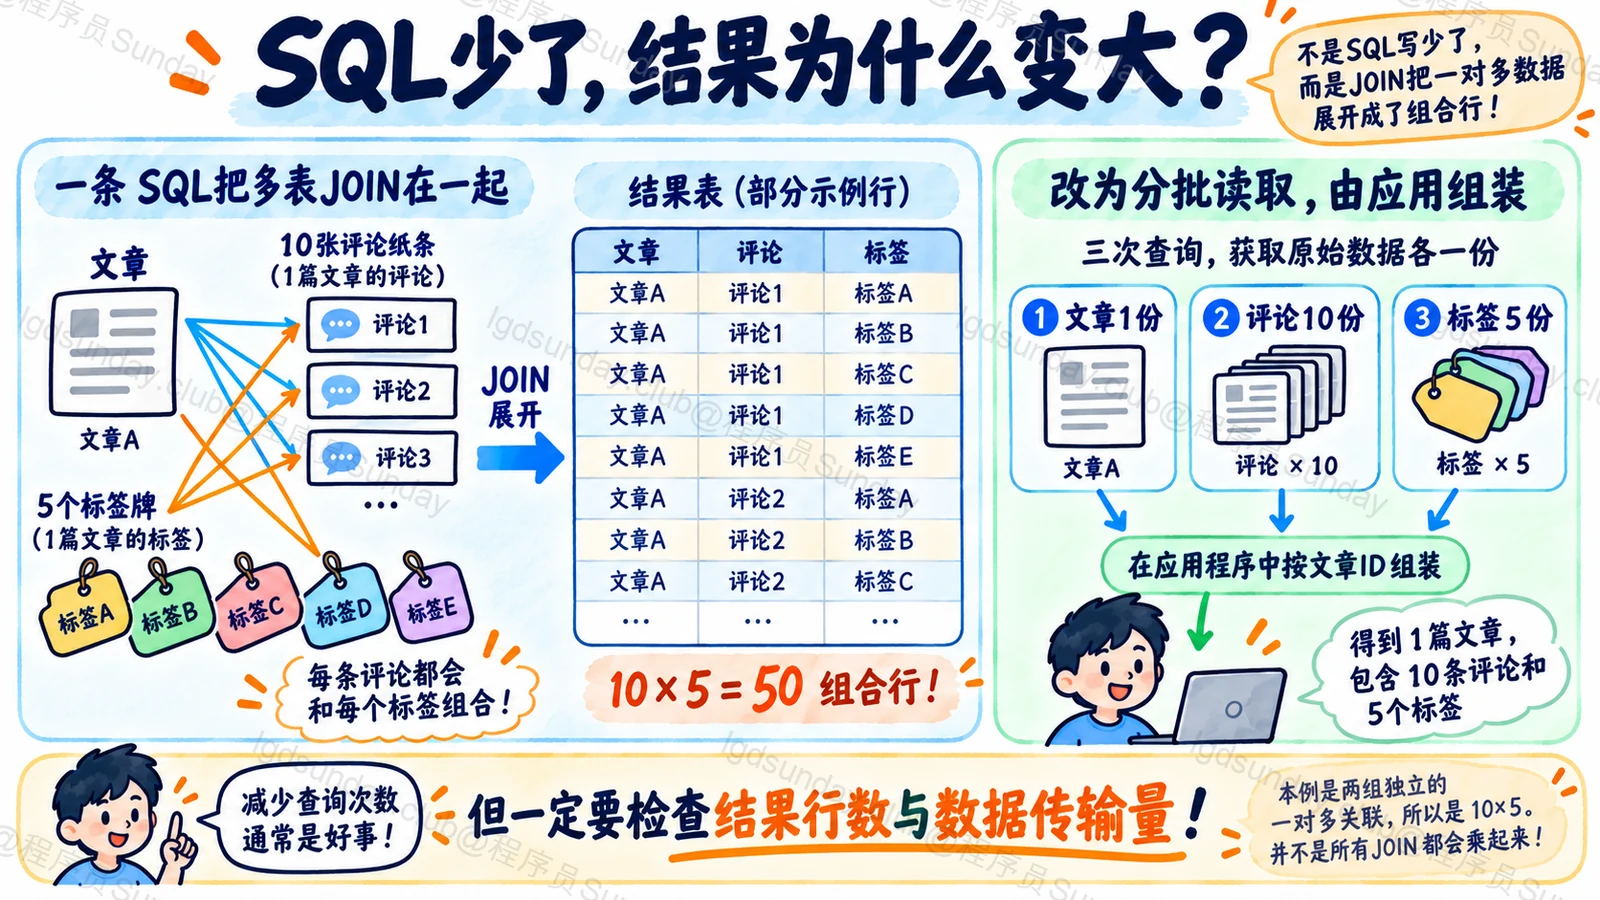
如果还要关联评论和标签,就要小心。某篇文章有十条评论、五个标签,直接把两种一对多关系展开,可能出现五十行组合。数据库传输变多,应用还得去重。
这种情况下可以先分页查文章,再分别批量查作者、评论和标签。查询不止一条,却更容易控制数据规模。
ORM 的预加载也可能采用多次批量查询,或者 JOIN。不同版本与选项行为不同。Prisma 的 查询性能文档 展示了这些方式,但不能看到 include 就认定只会执行一条 SQL。
DataLoader 的作用是什么?
在同一次请求里,多个 resolver 可能分别申请作者资料。批处理工具可以把一个调度批次里的请求合并,再把结果分发回各个调用者。
它通常还能在请求范围内复用已经查到的结果。这里的关键是请求范围和缓存键:用户权限、租户等会影响结果,不能把不同用户的查询随意混在一个长期缓存里。
批处理也有边界。分散在不同时间批次的请求,未必会合成一次。需要从实际执行的查询验证,而不是给代码加上 DataLoader 就算完成优化。
怎么判断优化有效?
在相同数据与负载下,比较每次接口的 SQL 数量、数据库耗时、返回行数、传输量和连接池等待。
还要验证第一页、深分页、关联记录缺失和一对多数据很多的情况。避免修掉 N+1 后,又把分页对象或访问权限查错了。
面试官继续追问
SQL 从二十一条变成一条,为什么反而更慢?
可能 JOIN 放大了结果,也可能取了大量不需要的列、没用上合适索引。先看执行计划和实际行数,别只比较查询条数。
给每次关联查询加索引,能解决吗?
索引能减少单次查找成本,但 N 次往返仍然存在。通常需要同时优化查询模式与单条 SQL。
批量查询能不能放进全局缓存?
是否可以缓存,取决于更新频率、权限、租户和失效机制。请求内复用容易控制,全局缓存是另一项设计,不能顺手扩大范围。
面试速记卡
- 一次查列表,再逐条查关联数据,容易形成 N+1。
- 属性访问可能触发懒加载,要看最终 SQL。
- 并发减少等待,不会减少查询总数。
- 批量查询后按 ID 组装,不能依赖返回顺序。
- JOIN 要检查一对多展开、分页和数据传输量。
- 同时比较查询次数、执行成本与返回数据规模。
公司面试真题
真题根据求职者公开面经整理,题意经过概括,非逐字原话或公司官方题库;本文为 Sunday 的独立解析。
字节跳动 · 前端 · 原帖未明确批次
GraphQL 为什么会出现 N+1 查询问题?(题意整理)
字节跳动 前端 3+1 面经(字节教育) ↗
原帖编辑于 2020-08-24